3. Diffusion models and denoising autoencoders
확산 모델은 제한적인 형태의 잠재 변수 모델처럼 보일 수 있지만, 구현에 있어 많은 자유도를 허용한다. 순방향 과정의 분산 $\beta_t$ 를 선택해야 하며, 역과정의 모델 아키텍처와 가우시안 분포 매개변수화 방식을 결정해야 한다. 이러한 선택의 방향을 잡기 위해, 우리는 확산 모델과 디노이징 스코어 매칭 간의 새로운 명시적 연결을 확립하며(섹션 3.2), 이는 확산 모델을 위한 단순화되고 가중치가 부여된 변분 하한 목적 함수로 이어진다(섹션 3.4). 궁극적으로 우리 모델의 설계는 단순성과 경험적 결과에 의해 정당화된다(섹션 4). 우리의 논의는 수식 (5)의 항들에 따라 분류된다.
3.1 순방향 과정과 $L_T$
우리는 순방향 과정의 분산 $\beta_t$ 가 재매개변수화를 통해 학습 가능하다는 사실을 무시하고, 대신 이를 상수로 고정한다(자세한 내용은 섹션 4 참조). 따라서 우리의 구현에서 근사 사후 분포 $q$ 는 학습 가능한 매개변수가 없으며, $L_T$ 는 학습 과정에서 상수이므로 무시할 수 있다.
3.2 역과정과 $L_{1:T-1}$
이제 $1 < t \le T$ 에 대한 $p_\theta(\mathbf{x}_{t-1}\vert \mathbf{x}_t) = \mathcal{N}(\mathbf{x}_{t-1}; \boldsymbol{\mu}_\theta(\mathbf{x}_t, t), \boldsymbol{\Sigma}_\theta(\mathbf{x}_t, t))$ 에서의 선택을 논의한다. 첫째로, 우리는 $\boldsymbol{\Sigma}_\theta(\mathbf{x}_t, t) = \sigma_t^2 \mathbf{I}$ 를 학습되지 않는 시간 종속 상수로 설정한다. 실험적으로 $\sigma_t^2 = \beta_t$ 와 $\sigma_t^2 = \tilde{\beta}_t = \frac{1-\bar{\alpha}_{t-1}}{1-\bar{\alpha}_t}\beta_t$ 모두 유사한 결과를 보였다. 첫 번째 선택은 $\mathbf{x}_0 \sim \mathcal{N}(\mathbf{0}, \mathbf{I})$ 일 때 최적이며, 두 번째 선택은 $\mathbf{x}_0$ 가 한 점으로 결정론적으로 설정될 때 최적이다. 이들은 좌표별 단위 분산을 가지는 데이터에 대한 역과정 엔트로피의 상한과 하한에 해당하는 두 가지 극단적인 선택이다 [53].
둘째로, 평균 $\boldsymbol{\mu}_\theta(\mathbf{x}_t, t)$ 를 표현하기 위해, $L_t$ 에 대한 다음 분석에서 동기를 얻은 특정 매개변수화를 제안한다. $p_\theta(\mathbf{x}_{t-1}\vert \mathbf{x}_t) = \mathcal{N}(\mathbf{x}_{t-1}; \boldsymbol{\mu}_\theta(\mathbf{x}_t, t), \sigma_t^2 \mathbf{I})$ 일 때, 다음과 같이 쓸 수 있다. \(L_{t-1} = \mathbb{E}_q \left[ \frac{1}{2\sigma_t^2} \| \tilde{\boldsymbol{\mu}}_t(\mathbf{x}_t, \mathbf{x}_0) - \boldsymbol{\mu}_\theta(\mathbf{x}_t, t) \|^2 \right] + C \quad (8)\) 여기서 $C$ 는 $\theta$ 에 의존하지 않는 상수이다. 따라서 $\boldsymbol{\mu}_\theta$ 의 직관적인 매개변수화는 순방향 과정의 사후 분포 평균인 $\tilde{\boldsymbol{\mu}}_t$ 를 예측하는 모델임을 알 수 있다. 그러나 수식 (4)를 $\mathbf{x}_t(\mathbf{x}_0, \boldsymbol{\epsilon}) = \sqrt{\bar{\alpha}_t}\mathbf{x}_0 + \sqrt{1-\bar{\alpha}_t}\boldsymbol{\epsilon}$ ( $\boldsymbol{\epsilon} \sim \mathcal{N}(\mathbf{0}, \mathbf{I})$ )로 재매개변수화하고, 순방향 과정 사후 분포 공식 (7)을 적용하여 수식 (8)을 전개할 수 있다.
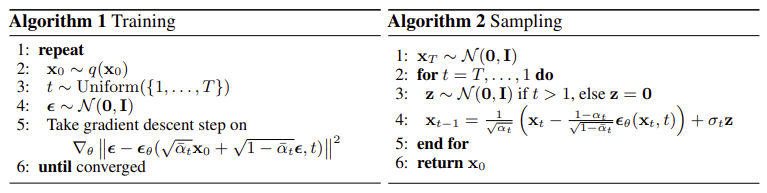
수식 (10)은 $\boldsymbol{\mu}_\theta$ 가 주어진 $\mathbf{x}_t$ 에 대해 $\frac{1}{\sqrt{\alpha_t}} \left( \mathbf{x}_t - \frac{\beta_t}{\sqrt{1-\bar{\alpha}_t}}\boldsymbol{\epsilon} \right)$ 를 예측해야 함을 보여준다. $\mathbf{x}_t$ 는 모델의 입력으로 주어지므로, 우리는 다음과 같은 매개변수화를 선택할 수 있다. \(\boldsymbol{\mu}_\theta(\mathbf{x}_t, t) = \tilde{\boldsymbol{\mu}}_t\left(\mathbf{x}_t, \frac{1}{\sqrt{\bar{\alpha}_t}}(\mathbf{x}_t - \sqrt{1-\bar{\alpha}_t}\boldsymbol{\epsilon}_\theta(\mathbf{x}_t))\right) = \frac{1}{\sqrt{\alpha_t}} \left( \mathbf{x}_t - \frac{\beta_t}{\sqrt{1-\bar{\alpha}_t}}\boldsymbol{\epsilon}_\theta(\mathbf{x}_t, t) \right) \quad (11)\) 여기서 $\boldsymbol{\epsilon}_\theta$ 는 $\mathbf{x}_t$ 로부터 $\boldsymbol{\epsilon}$ 을 예측하도록 의도된 함수 근사기이다. $\mathbf{x}_{t-1} \sim p_\theta(\mathbf{x}_{t-1}\vert \mathbf{x}_t)$ 를 샘플링하는 것은 $\mathbf{x}_{t-1} = \frac{1}{\sqrt{\alpha_t}} \left( \mathbf{x}_t - \frac{\beta_t}{\sqrt{1-\bar{\alpha}_t}}\boldsymbol{\epsilon}_\theta(\mathbf{x}_t, t) \right) + \sigma_t \mathbf{z}$ ( $\mathbf{z} \sim \mathcal{N}(\mathbf{0}, \mathbf{I})$ )를 계산하는 것이다. 전체 샘플링 절차인 알고리즘 2는 학습된 데이터 밀도 기울기로서의 $\boldsymbol{\epsilon}_\theta$ 를 가지는 랑주뱅 동역학과 유사하다. 더 나아가 매개변수화 (11)을 사용하면, 수식 (10)은 다음과 같이 단순화된다.
이는 $t$ 로 인덱싱된 여러 노이즈 스케일에 걸친 디노이징 스코어 매칭과 유사하다 [55]. 수식 (12)가 랑주뱅 형태의 역과정 (11)에 대한 변분 하한과 동일하므로, 디노이징 스코어 매칭과 유사한 목적 함수를 최적화하는 것은 랑주뱅 동역학과 유사한 샘플링 연쇄의 유한 시간 주변 분포를 적합시키기 위해 변분 추론을 사용하는 것과 동일함을 알 수 있다.
요약하자면, 우리는 역과정 평균 함수 근사기 $\boldsymbol{\mu}_\theta$ 가 $\tilde{\boldsymbol{\mu}}_t$ 를 예측하도록 학습하거나, 매개변수화를 수정하여 $\boldsymbol{\epsilon}$ 을 예측하도록 학습할 수 있다. 우리는 $\boldsymbol{\epsilon}$ -예측 매개변수화가 랑주뱅 동역학과 유사하며 확산 모델의 변분 하한을 디노이징 스코어 매칭과 유사한 목적 함수로 단순화함을 보여주었다. 이는 $p_\theta(\mathbf{x}_{t-1}\vert \mathbf{x}_t)$ 의 또 다른 매개변수화이므로, 섹션 4의 절제 실험에서 $\boldsymbol{\epsilon}$ 예측과 $\tilde{\boldsymbol{\mu}}_t$ 예측을 비교하여 그 효과를 검증한다.