geoffrey hinton은 RBM을 이용해서 현재 DNN의 초기화가 얼마나 중요한지 밝혀냄. RBM은 Generative Model이라고 하는데 ANN, DNN, CNN, RNN등과 같은 Deterministic Model들과 약간 다른 목표를 갖고 있음.
Deterministic Model들이 타겟과 가설 간의 차이를 줄여서 오차를 줄이는 것이 목표라고 한다면, Generative Model들의 목표는 확률밀도함수(probability density function, pdf)를 모델링하는 것이다.
이때, 확률 밀도 함수를 정확히 안다는 것은 무엇인가를 생각해보자.
가령 얼굴을 그려주는 기계가 있다고 할때 얼굴의 여러 요소 중 코를 타겟으로 잡아보자. 코 역시도 여러가지 모양이 있을 수 있는데 만약 세상에 코의 형태가 동그라미, 세모, 네모 코만 있다고 가정했을 때, 이 세가지 형태의 코에 대한 pdf를 알고 있다고 해보면 온 세상의 얼굴에서 코의 형태를 다 조사한 후 histogram으로 그려볼 수 있음. 이때 이 코의 모양에 대한 확률 분포는 확률질량함수로 표현될 수 있음.
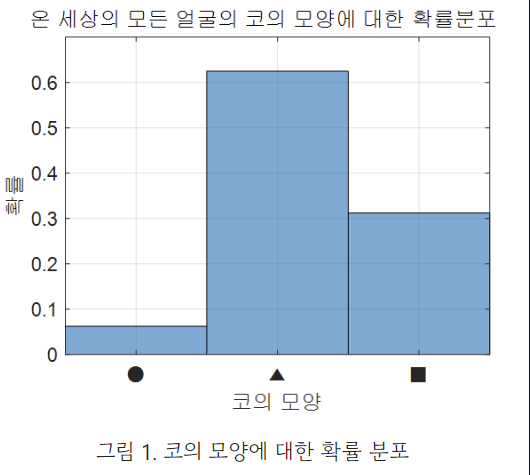
얼굴 그려주는 기계가 이런 확률 분포에 대해 알고 있다면 얼굴을 그릴 때 세모 모양의 코를 그려줄 가능성이 높음.
이런 식으로 모든 가능한 경우에 대해 어떤 사건이 발생할 확률을 정확히 알 수 있다면, 여러 사건들의 조합으로 구성되는 사건(여기서는 전체 얼굴)을 생성할 수 이게 되는 것임.
이렇게 확률분포를 통해 결과물을 생성해주는 과정을 sampling이라고 함.
즉, Generative Model의 목적은 확률분포를 정확히 학습해 좋은 sample을 sampling하는 것이라고 할 수 있음.
Boltzmann Machine은 확률분포(정확히는 PMF 혹은 PDF)를 학습하기 위해 만들어짐. 볼츠만 머신이 가정하는 것은 “우리가 보고 있는 것들 외에도 보이지 않는 요소들까지 잘 포함시켜 학습할 수 있다면 확률분포를 좀 더 정확하게 알 수 있지 않을까?”라는 것임.
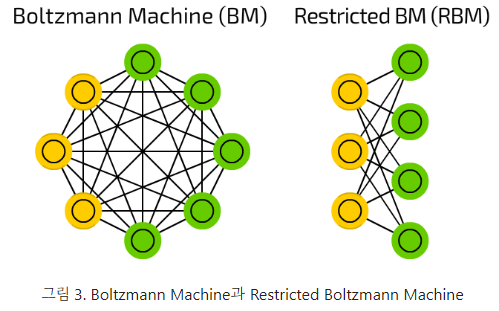
위 사진에서 왼쪽이 Boltzman Machine(BM), 오른쪽이 Restricted Boltzman Machine(RBM)임.
BM내 모든 노드들은 가능한 이벤트들에 대한 state임. 가령 얼굴의 형태에 대한 확률분포를 학습한다고 할때 각 노드가 얼굴의 특정 부위에 대한 상태를 표시함. 또, 노란색과 초록색으로 표현된 노드는 각각 hidden unit, visible unit임. hidden unit은 우리가 보지 못하는 어떤 특성이 존재함을 암시하고, 이렇게 보이지 않는 factor들까지도 학습할 수 있다면 좀 더 정확한 확률 분포를 학습할 수 있다는 것을 전제함. 이 네트워크의 모든 가능한 상태(state, v, h의 모든 조합)에 대해 에너지(E(v,h))라는 스칼라값을 정의함. 직관적으로 훈련데이터와 ‘유사한’ 상태는 낮은 에너지를 갖고, ‘있을 법하지 않은’상태는 높은 에너지를 갖도록 학습됨. 이 energy function을 boltzmann gibbs분포를 통해 확률분포로 정의하면 아래와 같음.
이때 Z(분배 함수) = $\sum_{v,h} e^{-E(v,h)}$ 임. Z는 모든 가능한 상태에 대해 더해야 하므로 계산이 매우 어려움.
오른쪽 RBM은 visible unit과 hidden unit 간의 연결만 남아있음. 이렇게 RBM을 구성한 것은 여러가지 확률 계산과 관련된 실용적인 이유가 있는데 먼저 visible, hidden layer의 노드 간 내부적인 연결이 없어진 것은 사건 간의 독립성을 가정함으로써 확률분포의 결합을 쉽게 표현하기 위함임.
| 또, visible layer(p(v))와 hidden layer(p(h))만을 연결해줌으로써 각 layer가 주어졌을 때 나머지 layer의 상태를 conditional probability(p(h | v), p(v | h))로 쉽게 표현할 수 있게 됨. 이러한 ‘조건부 독립’특성 덕분에 MCMC방법의 일종인 깁스 샘플링을 효율적으로 수행할 수 있지만 여전히 Z는 다루기 힘듦(intractable). |
이로써 볼츠만 머신에서 RBM으로 넘어오면서 Feed-Forward NN처럼 학습이 가능해짐. RBM의 작동 방식이 visible unit이 주어졌을 때 forward propagation을 통해 hidden unit의 state를 결정하고, 다시 backward propagation을 통해 visible unit의 상태를 재구성하게 됨.
이때 각 노드를 연결해주는 간선을 weight라고 부르며 W라고 표기하고 각 unit에는 bias가 존재함.
RBM이 학습을 잘 했다는 것을 수치적(어떤 스칼라)으로 판단하기 위해서 cost function을 정의해야 하는데 RBM의 비용함수는 물리학에서 energy 개념을 도입하여 정의함.
특정 상태 x에 대한 에너지를 E(x)라고 할때, E(x)는 그 상태(configuration:배열)에 매칭되는 값임.
즉, 상태 x에 대한 사건들의 분포를 말해주기도 하므로, 이는 확률분포와 연결시켜 생각할 수 있음.
Deep Belief Network(DBN)
여러 층의 RBM을 쌓아 올린 구조의 생성 모델임. 초기 가중치 초기화 기술이 없던 때 gradient vanishing문제를 어느정도 해결하는 방법으로 DBN을 사용함.
첫번째 단계는 pre-train과정으로 RBM을 한층씩 쌓음.
두번째 단계로 이전에 사전학습된 RBM의 hidden state를 다음 RBM의 input data로 사용하여 두번째 RBM을 학습함.
이 과정을 반복하며 깊은 구조를 학습할 수 있게 됨.
이 하지만 RBM의 근본적인 문제인 계산적 어려움과 MCMC의존성이 여전히 존재함.
출처 - 공돌이의 수학노트