Generative Modeling by Estimating Gradients of the Data Distribution
Yang Song, Stefano Ermon
핵심 내용 정리
1. 문제 제기: 기존 방식의 두 가지 한계
데이터 분포의 그래디언트(스코어)를 학습하여 샘플링하는 방식이 이론적으로 완벽하지만, 실제 고차원 데이터에 적용하면 실패하는 이유를 두 가지로 분석함.
- 매니폴드 가설
- 실제 데이터는 고차원 공간 전체에 퍼져있는 것이 아니라, 매우 낮은 차원의 매니폴드 위에 존재함.
- 문제는 매니폴드 위에서는 확률 밀도가 정의되지만, 매니폴드를 벗어난 공간에서는 정의되지 않는다는 점임. 따라서 그래디온트(스코어)도 정의할 수 없고, 스코어 매칭이 실패함.
- 저밀도 영역에서의 스코어 추정 및 느린 혼합
- 데이터가 희소한 영역에서는 학습 데이터가 없어서 스코어 네트워크가 정확한 그래디언트를 학습할 수 없음.
- 샘플링 시 Langevin Dynamics를 사용하는데, 데이터의 두 모드(Mode)가 저밀도 영역으로 분리되어 있으면, 샘플이 한 모드에서 다른 모드로 건너가지 못하고 갇히는 문제가 발생.
Q. 샘플이 한 모드에서 다른 모드로 건너가지 못하는게 왜 문제인가?
A. Mode는 데이터 분포에서 확률 밀도가 높은 덩어리들을 의미함. 예를 들어, 개와 고양이 사진을 학습했다면 개와 고양이의 각 집합이 각각의 모드가 됨.
샘플링 과정(Langevin Dynamics)이 모드 사이의 저밀도 영역을 건너가지 못하고 특정 모드에 갇혀버린다면, 모델은 전체 데이터 분포의 비율을 정확하게 반영하지 못함. 위 예시에서 샘플링이 개 Mode에 갇히면 생성된 결과물이 개 99%, 고양이 1%가 될 수 있음. 이는 모델이 데이터 분포를 제대로 학습했다고 할 수 없음.
학습 중 큰 노이즈를 먼저 주입하여 분리되어 있든 모드들이 서로 연결되어(저밀도 영역이 채워져서) 샘플이 자유롭게 이동할 수 있게 됨.
Q. Langevin Dynamics를 사용한다는 의미가 무엇인가?
A. 기울기(스코어)만 보고 확률밀도가 높아지는 방향으로 가는 것임.
정의: 스코어 함수만들 사용하여 확률분포로부터 샘플을 생성하는 반복적인 절차임.
Drift 항: 확률 밀도가 높은 곳으로 샘플을 밀어 올리는 힘.(등산)
Noise: 랜덤한 방향으로 샘플을 흔드는 힘.(확산)
의미: 데이터의 확률 분포 자체는 모르지만, 그 기울기는 신경망으로 학습함. Langevin Dynamics는 이 Vector field를 따라가며 랜덤 노이즈를 점차 그럴듯한 데이터로 샘플링함.
2. 해결책: Noise Conditional Score Network(NCSN)
이 문제를 해결하기 위해 데이터를 다양한 강도의 노이즈로 훼손(perturb, 섭동/perturbation)시키는 방법을 제안함.
- 다단계 노이즈 주입: $\sigma_1 > \sigma_2 > \dots > \sigma_L$ 순서로 노이즈 레벨을 설정
- 큰 노이즈로 데이터 분포를 넓게 퍼뜨려 저밀도 영역을 채우고, 모드 간 이동이 쉬워지게 유도. 전체 공간에서 스코어가 잘 정의됨.
- 작은 노이즈로 원본 데이터 분포와 거의 유사한 스코어를 정의.
- 조건부 스코어 네트워크: 각 노이즈 레벨에 대해 별도의 모델을 만드는 대신, 단일 신경망 $s_\theta(x, \sigma)$ 를 학습시킴. 이 네트워크는 입력과 현재 노이즈 레벨을 받아 해당 분포의 스코어를 추정함.
- 학습목표: Donoising Score Matching 손실 함수를 모든 노이즈 레벨에 대해 합친 형태:
이때 $\sigma_i^2$ 가중치는 모든 노이즈 레벨에서 손실 함수의 크기를 맞춰주기 위함.
3. 새로운 샘플링: Annealed Langevin Dynamics
학습된 모델로 이미지를 생성할 때 담금질(Annealing)기법을 적용한 새로운 샘플링 알고리즘을 사용.
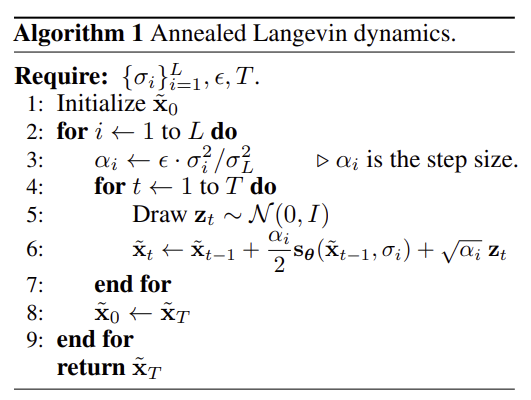
- 랜덤 노이즈에서 시작.
- 가장 큰 노이즈 레벨에 해당하는 스코어를 이용해 Langevin Dynamics를 수행.(큰 구조)
- 그 결과를 초기값으로 삼아, 다음 노이즈 레벨로 넘어감.
- 이를 제일 작은 노이즈 레벨까지 반복함.(세부 디테일)
이 방식으로 큰 노이즈에서 Mode를 잘 찾아가게 한 뒤, 점차 노이즈를 줄여가며 원본 데이터 매니폴드에 안착하게 만듦.
Q. 노이즈가 특정 Mode로 수렴하게끔 만들면 결국 학습데이터와 유사한 데이터밖에 만들어내지 못하는게 아닌가? 무작위 노이즈를 주입한다 하더라도 결국 끝은 확률 밀도가 가장 높아지는, 학습 데이터 방향임.
A. 매니폴드 학습: 모델은 학습 데이터 포인트 그 자체가 아니라, 학습 데이터가 놓여 있는 매니폴드(데이터가 존재할 수 있는 공간의 구조)를 배움. 매니폴드는 학습 데이터 포인트 사이사이를 잇는 연속적인 집합임. Langevin Dynamics는 이 매니폴드 위의 임의의 점으로 수렴함.
랜덤 노이즈의 역할: Langevin Dynamics 식을 보면 마지막에 항상 $\sqrt{\epsilon} z_t$ 라는 노이즈 항이 있음. 이 덕분에 샘플은 확률 밀도가 가장 높은 한 점으로 붕괴되지 않고, 확률 밀도가 높은 영역 안에서 계속 요동침. 즉, 분포 자체에서 샘플링을 수행함.