분산과 불확실성, 그리고 정밀도
정밀도 행렬(precision matrix)에서 말하는 정밀도는 머신러닝의 혼동 행렬(Confusion Matrix)에서 말하는 정밀도(Precision)와는 다른 개념이다.
일변수 확률 변수 $x$ 에 대해, $x$ 가 평균이 $m$ 이고 분산이 $s$ 인 정규분포를 따른다고 가정했을 때 분산의 역수( $\frac{1}{s}$ )는 무엇을 의미할까?
분산이란 어떤 확률 변수의 불확실성을 내포한다. 그 역수는 이 불확실성의 역수인데, 만약 분산이 크다면(불확실함) 그 역수는 작아질 것이고, 분산이 작다면(확실함) 그 역수는 커질 것이다. 즉, 불확실성의 역은 확신(Certainty)과 결이 통하며, 이것이 곧 정밀도이다.
다변수를 다룰 경우, 이러한 정밀도 행렬은 다변수 가우시안 분포의 지수항에서 찾아볼 수 있으며(1), 선형회귀에서 해석적 해를 찾는 정규방정식에서도 볼 수 있다(2).
기하학적 직관: 데이터의 맥락과 거리
다변수 데이터에서 거리를 측정할 때, 우리는 ‘데이터의 맥락’을 고려해야 한다.
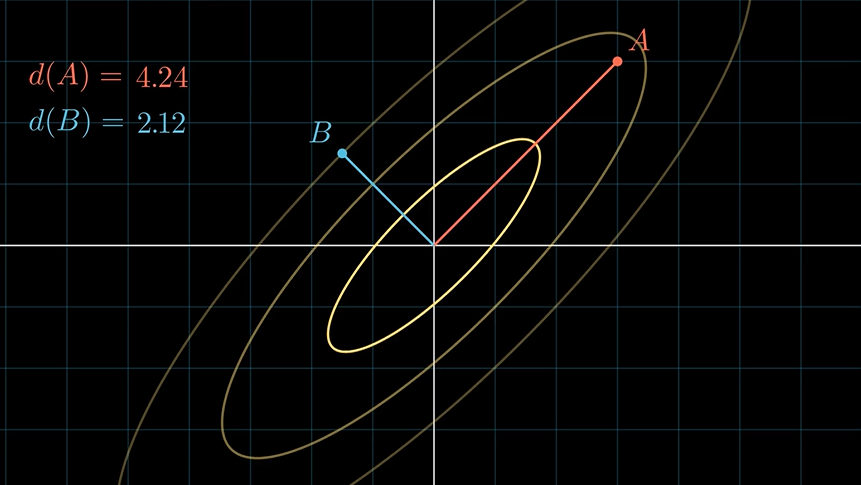
위는 두 확률 변수가 양의 상관관계를 가지는 데이터의 공분산 행렬이 $\begin{bmatrix}3.0 & 2.5 \ 2.5 & 3.0\end{bmatrix}$ 인 타원형 분포이다. 이때, 두 점 A, B를 생각해보자.
- 중심에서 $y=x$ 방향(긴 축)으로 떨어져 있는 점 A.
- 중심에서 $y=-x$ 방향(짧은 축)으로 떨어져 있는 점 B.
단순한 유클리드 거리로 재면 점 B가 중심에 가깝다. 하지만 데이터의 맥락에서 보면, 점 A는 데이터의 흐름을 잘 따르는 ‘정상적인’ 점이지만, 점 B는 데이터의 경향성을 완전히 벗어난 이상치이다. 따라서 통계적 맥락에서는 점 A가 중심에 훨씬 더 가까운 점으로 취급되어야 한다.
이 주관적인 ‘데이터의 맥락’을 수학적으로 어떻게 정의할 수 있을까? 이를 이해하기 위해서는 공간 변환의 관점이 필요하다.
기하학적으로 공분산 행렬 $\boldsymbol{\Sigma}$ 가 완벽한 원을 타원으로 길게 늘리는 변환이라면, 그 역행렬인 정밀도 행렬( $\boldsymbol{\Sigma}^{-1}$ )은 그 늘어난 타원을 다시 꾹 눌러서 완벽한 원형으로 압축하는(되돌리는, 역산, $\boldsymbol{\Sigma}^{-1}\boldsymbol{\Sigma}=\boldsymbol{I}$ ) 변환이다.
- $y=x$ 축처럼 데이터가 넓게 퍼져 분산이 큰 방향은 압축.
- $y=-x$ 축처럼 데이터가 좁게 뭉친 방향으로 늘림.
- 상관관계(기울기)를 회전시켜 제거.
이러한 공간 변환을 거치고 나면 데이터 분포는 완벽한 구형이 되며, 이 변환된 공간에서 재는 단순한 유클리드 거리가 곧 통계적으로 타당한 거리(마할라노비스 거리)가 된다.
이처럼 데이터를 구형으로 만드는 변환 과정을 백색화(Whitening) 변환이라고 부른다.
백색화 변환: 공간의 표준화
백색화란 다변량 확률 변수의 상관관계를 제거하고 모든 분산을 1로 표준화하는 선형변환이다.
‘백색’이라는 용어는 신호 처리 분야의 백색 잡음(White Noise)에서 유래했다. 가시광선의 모든 주파수가 균일하게 혼합될 때 백색광이 되는 물리적 현상에 빗대어, 모든 주파수 대역의 에너지가 균일하고 서로 독립적인 무작위 신호를 백색 잡음이라고 부른다. 데이터에 존재하는 특성 간의 편중이나 상관관계를 완전히 소거하여 이 백색 잡음과 같은 무상관 상태로 변환하기 때문에 백색화라고 불린다.
공분산 행렬 $\boldsymbol{\Sigma}$ 와 평균 $\boldsymbol{\mu}$ 를 갖는 다차원 확률 변수 벡터 $X$ 가 존재한다고 하자. 목표는 공분산이 항등 행렬( $\boldsymbol{I}$ )인 새로운 확률 변수 $Y$ 를 도출하는 것이다. 공분산 행렬이 항등 행렬이라는 것은 비대각 성분이 0(상관관계 없음)이고, 대각 성분이 1(분산이 1)이라는 뜻이다.
평균이 0으로 맞춰진(mean-centering) 데이터에 행렬 $W$ 를 곱하여 새 확률변수 $Y$ 를 정의해 보자.
이때 변환 행렬 $W$ 가 백색화 행렬이 되려면 반드시 $W^\top W = \boldsymbol{\Sigma}^{-1}$ 조건을 만족해야 한다.
(참고: $W = \boldsymbol{\Sigma}^{-1/2}$ 로 정의하면 이는 ZCA 백색화에 해당한다. 만약 $W = \boldsymbol{\Lambda}^{-1/2} \mathbf{Q}^\top$ 로 정의한다면 이는 PCA 백색화가 된다. 두 방식 모두 결과 데이터의 공분산을 항등 행렬로 만들지만, ZCA는 원본 데이터와 구조적 유사성(회전 최소화)을 유지하고, PCA는 축 자체를 주성분 축으로 완전히 정렬시킨다는 차이가 있다. 아래 ZCA백색화와 PCA백색화를 시각화하였다.)
정밀도를 곱하는 것과 정밀도의 제곱근을 곱하는 것의 차이
여기서 주의할 점이 있다. 데이터를 공간적으로 압축하여 구형으로 만든다고 할 때, 정밀도 행렬( $\boldsymbol{\Sigma}^{-1}$ ) 자체를 데이터에 직접 곱하는 것이 아니다. 데이터 변환 시에는 정밀도 행렬의 제곱근( $\boldsymbol{\Sigma}^{-1/2}$ )을 곱해야 한다(표준편차는 원본 데이터와 단위가 같지만, 분산은 단위의 제곱임을 상기하자).
만약 데이터에 $\boldsymbol{\Sigma}^{-1}$ 를 직접 곱하면 결과 확률 변수의 분산은 1이 되는 것이 아니라, 오히려 원래 분산의 역수가 되어버린다. 이를 아래 일변수, 다변수에서 유도하였다.
일변수(1D)에서의 증명
어떤 일변수 데이터 $X$ 의 분산이 $\sigma^2$ 이라고 해보자 ( $Var(X) = \sigma^2$ ). 목표는 새로운 데이터 $Y$ 의 분산을 1로 만드는 것이다.
만약 정밀도(분산의 역수)를 데이터에 직접 곱한다면 ( $Y = \frac{1}{\sigma^2} X$ ), 새로운 확률 변수 $Y$ 의 분산은 다음과 같다.
분산이 1이 되지 않고, 오히려 정밀도 값 자체가 되었다.
이번엔 정밀도의 제곱근(표준편차의 역수)을 곱해보자 ( $Y = \frac{1}{\sigma} X$ ):
원하는 대로 분산이 1이 되었다.
다변수(Multi-D)에서의 증명
이는 다변수 공간에서도 동일하게 적용된다. 행렬 곱의 공분산을 구하는 공식은 $Cov(AX) = A \cdot Cov(X) \cdot A^\top$ 이다.
초기 데이터 $X$ 의 공분산 행렬은 $\boldsymbol{\Sigma}$ 이며, 새 확률 변수 $Y$ 의 공분산 행렬을 $\boldsymbol{I}$ 로 만드는 게 목표이다.
만약 데이터에 $\boldsymbol{\Sigma}^{-1}$ 를 직접 곱하는 경우 ( $Y = \boldsymbol{\Sigma}^{-1} X$ ):
$\boldsymbol{\Sigma}$ 는 대칭 행렬이므로 역행렬의 전치 행렬은 자기 자신과 같다. $( (\boldsymbol{\Sigma}^{-1})^\top = \boldsymbol{\Sigma}^{-1} )$
공분산이 $\boldsymbol{I}$ 가 아니라 $\boldsymbol{\Sigma}^{-1}$ 이 되어버린다.
반면, $W^\top W = \boldsymbol{\Sigma}^{-1}$ 를 만족하는 $W = \boldsymbol{\Sigma}^{-1/2}$ 를 곱해보자 ( $Y = \boldsymbol{\Sigma}^{-1/2} X$ ):
데이터 공간이 완벽하게 백색화되었다.
ZCA백색화: 타원이 원으로 압축되며, 고유벡터의 방향은 변하지 않는 것을 확인할 수 있다.
PCA 백색화: 타원이 원으로 압축됨과 동시에 고유벡터 축으로 공간이 회전한다.
(np.linalg.eigh(cov) 함수는 디폴트로 행렬의 고유값(vals)과 고유벡터(vecs)를 계산할 때, 크기를 기준으로 오름차순(작은 값부터 큰 값 순서)으로 정렬하여 반환하기 때문에 첫 번째 주성분이 변환된 공간에서 $y$ 축, 두번째 주성분이 $x$ 축으로 정렬되었다.)
PCA 백색화(반전X)
공분산 행렬은 상관관계를 만드는 변환인가?
공분산 행렬과 정밀도 행렬을 기하학적으로 이해하려다 보면 다음과 같은 직관인적 모순에 부딪힐 수 있다.
“공분산 행렬 $\boldsymbol{\Sigma}$ 가 데이터에 선형적인 상관관계를 부여하는(늘리는) 변환 행렬이라면, 그 역변환인 ‘상관관계를 없애는 행렬’은 당연히 역행렬인 정밀도 행렬 $\boldsymbol{\Sigma}^{-1}$ 이 되어야 하는 것 아닌가? 왜 $\boldsymbol{\Sigma}^{-1/2}$ 인가?”
이 직관이 빗나간 근본적인 이유는 직관의 출발점이 된 전제 자체가 수학적으로 참이 아니기 때문이다. 원형 데이터에 상관관계를 부여하여 타원형으로 만든 진짜 변환 행렬은 $\boldsymbol{\Sigma}$ 가 아니라 $\boldsymbol{\Sigma}$ 의 제곱근 행렬인 $\boldsymbol{\Sigma}^{1/2}$ 이다.
상관관계가 없는 완벽한 구형 데이터 공간(공분산이 $\boldsymbol{I}$ 인 확률 변수 $Z$ )이 있다고 가정해 보자. ( $Cov(Z) = \boldsymbol{I}$ )
이 데이터에 어떤 선형 변환 행렬 $A$ 를 곱하여, 우리가 아는 특정 상관관계를 가진 타원형 데이터 $X$ 를 만들었다. ( $X = AZ$ )
이때 생성된 데이터 $X$ 의 공분산이 $\boldsymbol{\Sigma}$ 가 되어야 한다.
공분산의 행렬 연산 법칙( $Cov(AX) = A \cdot Cov(X) \cdot A^\top$ )을 적용해 보면 다음과 같다.
우리는 $X$ 의 공분산이 $\boldsymbol{\Sigma}$ 가 되기를 원하므로 다음 식이 성립해야 한다.
만약 $A$ 가 대칭 행렬이라고 가정한다면( $A = A^\top$ ), $A^2 = \boldsymbol{\Sigma}$ 가 된다. 즉, 데이터를 변환하여 공분산 $\boldsymbol{\Sigma}$ 를 만들어낸 실제 변환 행렬 $A$ 는 $\boldsymbol{\Sigma}$ 가 아니라 $\boldsymbol{\Sigma}^{1/2}$ 이다.
“상관관계를 만든 변환의 역행렬이 상관관계를 없앤다”는 직관의 논리적 흐름 자체는 옳으나, ‘데이터를 늘린 행렬’을 $\boldsymbol{\Sigma}$ 로 착각했을 뿐이다.
- 상관관계를 만든 변환 행렬: $\boldsymbol{\Sigma}^{1/2}$
- 상관관계를 없애는 역변환 행렬 (백색화): $(\boldsymbol{\Sigma}^{1/2})^{-1} = \boldsymbol{\Sigma}^{-1/2}$
만약 구형 데이터 $Z$ 에 변환 행렬로서 $\boldsymbol{\Sigma}$ 를 직접 곱해버리면 ( $X = \boldsymbol{\Sigma}Z$ ), 생성된 데이터 $X$ 의 공분산은 어떻게 될까?
결과 데이터의 공분산이 $\boldsymbol{\Sigma}$ 가 되는 것이 아니라, $\boldsymbol{\Sigma}^2$ 으로 스케일이 한 번 더 곱해져 과장되게 변형되어 버린다.
결론적으로, 데이터를 다루는 ‘선형 변환 행렬(1차원적인 좌표 공간)’과 데이터의 흩어짐을 나타내는 ‘공분산 행렬(거리의 제곱 공간)’은 수학적 차원(Scale)이 다르다. 분산은 본질적으로 값의 ‘제곱’을 기반으로 계산되므로, 공분산 행렬에 담긴 정보를 1차원적인 벡터 변환 행렬로 가져오려면 반드시 제곱근( $1/2$ 승)을 취해야만 논리적 모순이 발생하지 않는다.
거리 측정과 가우시안 분포: 왜 지수항에는 $\boldsymbol{\Sigma}^{-1}$ 이 들어가는가?
앞서 데이터의 ‘좌표’를 변환할 때는 $\boldsymbol{\Sigma}^{-1/2}$ 를 곱해야 한다고 증명했다. 그렇다면 왜 통계적 거리(마할라노비스 거리)의 공식이나 가우시안 분포의 수식에는 $\boldsymbol{\Sigma}^{-1/2}$ 가 아니라 정밀도 행렬 ** $\boldsymbol{\Sigma}^{-1}$ ** 이 통째로 들어가는 것일까?
이 질문에 대한 가장 명쾌한 해답은, 백색화된 공간에서의 ‘유클리드 거리’를 계산해보면 자연스럽게 유도된다.
백색화된 공간(완벽한 구형, 항등 공분산을 가지는 공간)을 $Z$ 라고 하자. 원점(평균)에서 특정 점까지의 단순한 유클리드 거리의 제곱은 다음과 같다.
이때 $Z$ 는 원본 데이터 $X$ (평균이 0으로 맞춰졌다고 가정)에 백색화 행렬을 곱한 것이므로, $Z = \boldsymbol{\Sigma}^{-1/2} X$ 를 대입할 수 있다.
전치 행렬의 성질 $(AB)^\top = B^\top A^\top$ 을 적용하면:
여기서 공분산 행렬 $\boldsymbol{\Sigma}$ 는 대칭 행렬이므로, 그 제곱근 행렬 또한 대칭 행렬이다. 즉, $(\boldsymbol{\Sigma}^{-1/2})^\top = \boldsymbol{\Sigma}^{-1/2}$ 가 성립한다. 이를 대입하면:
이 결과가 바로 마할라노비스 거리(Mahalanobis Distance) 공식이다.
다변량 가우시안 확률 밀도 함수 역시 이 마할라노비스 거리를 지수항에 사용한다.
결론적으로, 백색화( $\boldsymbol{\Sigma}^{-1/2}$ )를 통해 공간 자체를 구형으로 펴주는 변환을 수행한 뒤 그 공간에서 유클리드 거리를 재는 것과, 애초에 거리 공식 내부에 정밀도 행렬( $\boldsymbol{\Sigma}^{-1}$ )을 넣어 거리를 계산하는 것은 수학적으로 완전히 동치이다. 거리를 구하기 위해 내적(제곱)을 하는 과정에서 $\boldsymbol{\Sigma}^{-1/2}$ 가 두 번 곱해지기 때문에 자연스럽게 정밀도 행렬( $\boldsymbol{\Sigma}^{-1}$ )로 귀결되는 것이다.
Q. 정밀도 행렬을 곱함으로써 단위를 제거한 것의 연산이 이루어지는가?
일변수(1D) 정규분포에서 우리가 거리를 잴 때, 단위를 없애기 위해 값에서 평균을 빼고 ‘표준편차( $\sigma$ )’로 나눈다. ( $z = \frac{x - \mu}{\sigma}$ ) 이 거리를 ‘제곱’하면 다음과 같다.
여기서 $\frac{1}{\sigma^2}$ 이 바로 1차원에서의 정밀도이다. 즉, 거리를 잴 때 정밀도를 곱해준다는 것은 분산(단위의 크기)을 1로 만드는, 즉 단위를 제거하여(무차원량) 통계적 거리만 남기는 연산이다.
다변수 공간의 마할라노비스 거리를 구할 때 정밀도 행렬 $\boldsymbol{\Sigma}^{-1}$ 이 곱해지는 것도 완전히 동일한 원리이다. 즉, 내부적으로는 $\boldsymbol{\Sigma}^{-1/2}$ 변환이 두 번 곱해져(제곱) $\boldsymbol{\Sigma}^{-1}$ 형태가 된 것이다.
Q. 가우시안 분포는 애초에 각 변수간의 상관관계를 제거한 확률분포인가?
다변량 가우시안 분포 $\mathcal{N}(\boldsymbol{\mu}, \boldsymbol{\Sigma})$ 는 변수 간의 상관관계를 제거한 것이 아니라 모델링한 분포이다. 분포항의 수식이 가지는 기하학적 의미는 다음과 같다. “어떤 데이터 $\mathbf{x}$ 가 상관관계( $\boldsymbol{\Sigma}$ )가 내재된 공간 상에 존재할 때, 이 상관관계를 역으로 계산하여( $\boldsymbol{\Sigma}^{-1}$ 적용), 상관관계가 제거된 가상의 표준 공간에서 보았을 때의 거리(마할라노비스 거리)를 측정해 확률 밀도를 평가하겠다.”
고윳값 분해 관점
Q. 상관관계를 제거한다는 것은 공분산행렬의 고유벡터축으로 회전한다는 것인가?
정밀도 행렬로 공간을 변환하여 상관관계를 제거하고 단위를 제거하는 과정(백색화)은 고윳값 분해로 직관적인 해석이 가능하다.
공분산 행렬 $\boldsymbol{\Sigma}$ 는 대칭 행렬이므로, 직교 행렬(고유벡터, $\mathbf{Q}$ )과 대각 행렬(고윳값, $\boldsymbol{\Lambda}$ )로 분해할 수 있다.
따라서 이 공간을 ‘원상 복구’시키는 정밀도 행렬의 제곱근 변환( $\boldsymbol{\Sigma}^{-1/2}$ )은 다음과 같다.
위 예시( $y=x$ 축으로 비스듬하게 퍼져있는 데이터 분포)에서 $\mathbf{Q}^\top$ 를 곱해 데이터 전체를 고유벡터 축으로 돌려 정렬시킨 뒤, 각 축에 대해 독립적인 1차원 분산(고윳값 $\lambda$ )의 제곱근( $1/\sqrt{\lambda}$ )을 곱하여( $\boldsymbol{\Lambda}^{-1/2}$ ) 스케일링(단위 제거)을 수행한다. 이후 다시 $\mathbf{Q}$ 를 곱해 원래 축 방향으로 되돌려 놓는 것이다.
Q. 고윳값(분산)과 정밀도의 관계 부등식
공분산 행렬 $\boldsymbol{\Sigma}$ 의 고윳값들이 내림차순으로 정렬되어 있다고 하자.
정밀도 행렬 $\boldsymbol{\Sigma}^{-1}$ 의 고윳값은 원래 고윳값의 역수인 $1/\lambda$ 이므로, 위 부등호의 방향은 반대가 된다.
공분산의 관점에서 $\lambda_1$ 은 데이터가 이 고유벡터 방향으로 가장 넓게 퍼져 있다는 뜻이다. 즉, 이 방향의 정보가 가장 불확실하다는 것을 의미한다. PCA에서 이를 첫 번째 주성분이라 부른다.
정밀도의 관점에서 $1/\lambda_1$ 은 어떤 ‘확신의 강도’라고 볼 수 있다. 데이터가 사방으로 흩어져 있어 가장 불확실한 방향이므로, 이 방향에 대해서 우리가 가질 수 있는 확신이 가장 작을 수밖에 없다.
반대로 $\lambda_n$ 에 대응되는 고유벡터 방향으로 데이터의 분산이 거의 0에 가깝다. 이 방향에 대해 가장 강력하게 확신할 수 있으며, 정밀도의 관점에서 $1/\lambda_n$ 는 가장 큰 값이 된다.
Q. 고유벡터의 순서 매칭
공분산행렬을 분해했을 때 얻어지는 고유벡터 행렬( $\mathbf{Q}$ )과 정밀도 행렬을 분해했을 때 얻는 고유벡터 행렬( $\mathbf{Q}$ )은 ‘고유벡터의 집합’ 자체는 동일하지만, 고윳값의 순서가 역전되었으므로 고유벡터의 순서 또한 그에 맞게 배치되어야 한다.
further
- 조건부 독립: 가우시안 분포에서 정밀도 행렬의 비대각 성분이 0이라는 것은, 나머지 모든 변수들이 주어졌을 때 두 변수가 서로 완전히 독립(Conditional Independence)임을 의미한다.
Q. 데이터와 평균과의 차이를 어떤 벡터 $\boldsymbol{d} := \mathbf{x} - \boldsymbol{\mu}$ 라고 했을 때, 아래 이차형식은 어떤 의미를 가지는가?
또, 이 이차형식에서 $\boldsymbol{d}$ 에 대한 1차 도함수와 2차 도함수(헤시안)가 가지는 의미는 무엇인가?
가우시안 분포의 로그 우도 $\log p(\mathbf{x})$ 를 미분한 스코어 함수(1차 도함수)는 $-\boldsymbol{\Sigma}^{-1}\boldsymbol{d}$ 이다. 이는 기하학적으로 현재 위치에서 확률 밀도가 가장 높아지는 방향(데이터 매니폴드로 돌아가는 힘)을 나타내는 그래디언트이다. 정밀도 행렬이 곱해졌기 때문에, 분산이 큰 방향으로는 약하게, 분산이 작은(확신이 큰) 방향으로는 강하게 밀어내는 곡률이 반영된 복원력 벡터가 된다. (SBM, Diffusion 등 최근 생성 모델에서 중요한 개념이다.)
이를 한 번 더 미분한 2차 도함수(헤시안)는 $-\boldsymbol{\Sigma}^{-1}$ 자체가 된다. 즉 정밀도 행렬 자체가 공간의 곡률(Curvature)이자 피셔 정보(Fisher Information)를 나타내며, 확률 밀도의 지형이 얼마나 가파른지를 정량화한다.
Q. 변환된 공간의 유클리드 거리(마할라노비스 거리)는 변수간의 선형관계만 고려한 거리측정인가?
그렇다. 공분산 행렬 $\boldsymbol{\Sigma}$ 는 두 변수 간의 ‘선형적’ 상관관계만을 측정하는 지표이다. 데이터에 비선형적인 관계(예: U자 형태)가 내재되어 있더라도 백색화(정밀도 행렬 변환)는 이를 선형적인 스케일링과 회전으로만 해석하여 제거하는 변환이다.
Reference