이 글을 보기 전 참고하면 좋은 글들
이차 형식
양의 정부호
딥러닝 09_04_02 선형차원축소
MML 6.4절 정의 6.7을 보면 다차원 확률 변수의 분산은 행렬로 정의되는데, 그것이 외적으로 정의되는 이유와 이 공분산 행렬이 왜 항상 양의 준정부호 행렬인지 그것이 가지는 기하학적 의미를 확인해보려 한다.
공분산
共 함께 공, 分 나눌 분, 散 흩을 산
네이버 사전에 의하면 ‘둘 이상의 변량이 서로 관련성을 가지며 분포하는 모양을 전체적으로 나타내는 분산’을 의미한다.
또한 ‘분산’은 통계값(=관측값?)과 평균값의 차이인 편차를 제곱하여 얻은 값들의 산술평균이다. 분산이 작으면 자료(샘플)는 평균값 주위에 모여 있게 되고, 분산이 크면 자료 가운데 평균값에서 멀리 떨어진 것이 많게 된다.
다차원 변수에 대한 분산이 외적으로 정의되는 이유.
1차원 공간에서 분산은 편차의 제곱, 즉 $(x - \mu)(x - \mu)$ 이다. 다차원 공간에서 변수는 $n \times 1$ 형태의 열벡터 $\boldsymbol{x}$ 이며, 편차 역시 열벡터 $(\boldsymbol{x} - \boldsymbol{\mu})$ 가 된다. 이 편차 벡터를 스스로 곱하여 다차원적인 ‘퍼짐’을 수학적으로 포착하는 방법에는 내적(Inner Product)과 외적(Outer Product) 두 가지가 있는데 이때 외적을 선택해야만 하는 이유가 있다.
만약 내적을 사용한다면 결과는 다음과 같다.
이는 각 축(차원)별 분산들의 단순 합(스칼라)이다. 기하학적으로는 다차원 데이터 분포 내 무작위 점에 대해, 그 점이 중심(평균)으로부터 얼만큼 떨어져 있는지에 대한 거리 제곱의 평균 기대치를 의미한다. 이는 실제 공분산 행렬(외적을 사용한)의 대각합과 동일하다.
이 스칼라에는 서로 다른 차원 $i$ 와 $j$ 간의 상호작용, 즉 차원 간의 얽힘(교차 공분산) 정보는 존재하지 않는다.
반면 $n \times 1$ 열벡터와 $1 \times n$ 행벡터를 곱하는 외적 $(\boldsymbol{x} - \boldsymbol{\mu})(\boldsymbol{x} - \boldsymbol{\mu})^\top$ 을 수행하면 $n \times n$ 크기의 행렬이 생성된다. 이 행렬의 $i$ 행 $j$ 열에 위치한 원소는 대수적으로 정확히 $(x_i - \mu_i)(x_j - \mu_j)$ 가 된다. 여기에 기댓값 연산자 $\mathbb{E}$ 의 선형성을 적용하면, 대각선 원소는 자기 자신의 편차 제곱 기댓값(분산)이 되고, 비대각선 원소는 서로 다른 변수 간 편차 곱의 기댓값(공분산)이 된다. 즉, 다차원 공간에서 모든 변수 쌍 간의 선형적 관계를 온전히 담아낸 행렬이 구축되는 것이다.
양의 준정부호(PSD)를 ‘행렬의 관점’에서 이해하기
어떤 변환 $\boldsymbol{A}$ 를 취했을 때( $\boldsymbol{Ax}$ ) 원래 벡터 $\boldsymbol{x}$ 와의 사이각이 90도 이하인 변환 $\boldsymbol{A}$ 는 양의 준정부호 이며, 이에 대한 기하학적 의미(벡터 관점)는 이 글에 적어놓았다.
이 글에서 공분산 행렬 $\boldsymbol{\Sigma}$ 가 양의 준정부호라는 사실을 다룰 때는, 벡터의 회전이나 각도가 아니라 ‘행렬 자체에 내재된 이차 형식(Quadratic Form)과 통계적 분산’의 관점으로 접근한다.
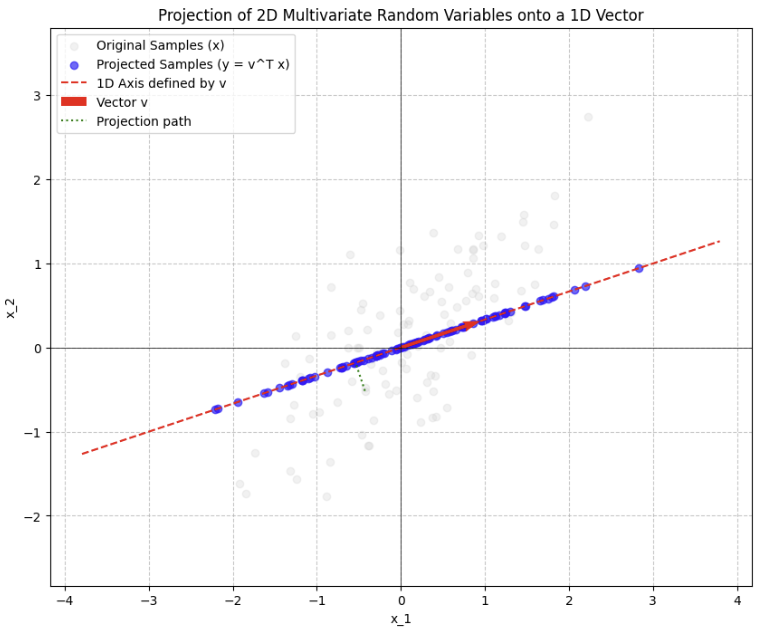
$n$ 차원 공간에 존재하는 확률 변수 열벡터 $\boldsymbol{x} = [x_1, x_2, \dots, x_n]^\top$ 가 있다고 가정한다. 여기에 임의의 상수 열벡터 $\boldsymbol{v} = [v_1, v_2, \dots, v_n]^\top$ 를 이용한 내적 $\boldsymbol{v}^\top \boldsymbol{x}$ 를 생각해보자.
이 연산의 결과는 1차원 스칼라 확률 변수다. 편의를 위해 이 새로운 1차원 확률 변수를 $y$ 라고 부르겠다. ( $y = \boldsymbol{v}^\top \boldsymbol{x}$ )
이 1차원 확률 변수 $y$ 의 분산을 구해보자. $\boldsymbol{x}$ 의 평균 벡터를 $\boldsymbol{\mu}$ 라고 하면, 기댓값의 선형성에 의해 $y$ 의 평균( $\mathbb{E}[y]$ )은 $\boldsymbol{v}^\top \boldsymbol{\mu}$ 가 된다.
이를 전개하면:
여기서 상수 벡터 $\boldsymbol{v}^\top$ 를 공통 인수로 묶어낼 수 있다.
$\mathbb{E}[(\boldsymbol{x} - \boldsymbol{\mu})(\boldsymbol{x} - \boldsymbol{\mu})^\top]$ 은 다차원 확률 변수 $\boldsymbol{x}$ 의 공분산 행렬 $\boldsymbol{\Sigma}$ 이다.
$y(= \boldsymbol{v}^\top \boldsymbol{x})$ 는 1차원 실수 확률 변수다. 실수의 편차를 제곱하여 기댓값을 낸 분산 $\mathbb{V}[y]$ 는 수학적으로 절대로 음수가 될 수 없다. 즉, 조건 없이 무조건 $\mathbb{V}[y] \ge 0$ 이 성립해야 한다. 또한 $\mathbb{V}[y]$ 가 정확히 $\boldsymbol{v}^\top \boldsymbol{\Sigma} \boldsymbol{v}$ 와 동일하다는 것을 위에서 유도하였다. 따라서, $n$ 차원의 어떤 임의의 벡터 $\boldsymbol{v}$ 를 가져와서 새로운 확률 변수 $y$ 를 만들어내든 간에, 그 $y$ 의 분산인 $\boldsymbol{v}^\top \boldsymbol{\Sigma} \boldsymbol{v}$ 는 항상 $0$ 이상이어야만 한다.
이는 행렬 $\boldsymbol{\Sigma}$ 가 양의 준정부호(positive semi-definite)임을 뜻한다.
기하학적으로, $n$ 차원 공간에 다변량 확률 분포라는 데이터 분포가 퍼져 있고, 같은 공간에 단위 벡터 $\boldsymbol{v}$ 가 존재한다고 상상해 보자. 이때 내적 $\boldsymbol{v}^\top \boldsymbol{x}$ 연산은 다차원 데이터들을 $\boldsymbol{v}$ 가 스팬(span)하는 1차원 직선 위로 정사영(Projection)시키는 것과 같다. 결과적으로 다차원 공간에 흩어진 확률 변수들의 분포가 1차원 직선 위로 압축되며, 우리는 이 직선 위에서 데이터가 얼마나 퍼져 있는지를 측정할 수 있게 된다.
실제 데이터의 공분산 행렬
$m$ 개의 샘플(데이터 개수)과 $n$ 개의 특징(Feature, 차원)을 가진 데이터 행렬 $\boldsymbol{Z} \in \mathbb{R}^{m \times n}$ 를 가정한다. 행렬의 각 행(Row)은 하나의 데이터 샘플 벡터 $\boldsymbol{z}_i^\top$ 를 나타내고, 각 열(Column)은 특징(feature)을 나타낸다.
공분산은 평균으로부터 떨어진 편차(Deviation)’들의 곱에 대한 기댓값이므로 각 열(특징)의 평균을 계산하여 원본 데이터에서 빼주어야 한다. 이 편차 행렬을 $\boldsymbol{Z}_c$ (Centered $\boldsymbol{Z}$ )라고 하자.
(여기서 $\mathbf{1}$ 은 모든 원소가 $1$ 인 $m \times 1$ 열벡터, $\bar{\boldsymbol{z}}$ 는 각 특징의 평균을 담은 $n \times 1$ 열벡터다. 이 두 벡터의 외적을 만든 행렬을 원본 데이터에 빼준다.)
경험적 공분산 행렬 $\hat{\boldsymbol{\Sigma}}$ 는 각 샘플 편차 외적의 총합을 전체 샘플 개수 $m$ (또는 비편향 추정의 경우 $m-1$ )으로 나누어 산술 평균(기댓값)을 구해야 한다.
위의 합산 기호( $\Sigma$ )를 행렬 곱셈으로 표현하면, $m \times n$ 편차 행렬 $\boldsymbol{Z}_c$ 를 이용하여 다음과 같이 쓸 수 있다.
이를 위에서 유도한 이차 형식처럼 다뤄보자.
mean-centering한 m개의 샘플을 임의의 1차원 축 $\boldsymbol{v}$ (단위 벡터, $\Vert \boldsymbol{v}\Vert = 1$ ) 위로 정사영시킨다고 가정해보자. 행렬과 벡터의 곱셈 $\boldsymbol{Z}_c \boldsymbol{v}$ 를 수행하면, 그 결과는 $m \times 1$ 크기의 열벡터가 된다. 편의상 이 결과 벡터를 $\boldsymbol{y}$ 라고 하겠다.
이 열벡터 $\boldsymbol{y}$ 의 각 성분 $y_1, y_2, \dots, y_m$ 은 m개의 원본(평균이 0인) 데이터( $\boldsymbol{z}_1, \dots, \boldsymbol{z}_m$ )들이 1차원 축 $\boldsymbol{v}$ 위로 투영된( $\boldsymbol{z}_1^{\top}\boldsymbol{v}, \dots, \boldsymbol{z}_m^{\top}\boldsymbol{v}$ ) 1차원 스칼라 좌표값들이다.
우리가 알고 싶은 것은 이 투영된 데이터들이 1차원 축 위에서 얼마나 넓게 흩어져 있는가, 즉 이 $m$ 개의 좌표값 $y_i$ 들의 ‘경험적 분산’이다.
원본 데이터 $\boldsymbol{Z}_c$ 가 이미 각 차원별로 평균이 $0$ 이 되도록 중심화되어 있으므로, 투영된 좌표값들의 평균 역시 $0$ 이 된다(이에 대한 증명은 아래에 적어놓았다). 평균이 $0$ 인 $m$ 개 데이터의 분산은 단순히 각 데이터의 제곱을 모두 더한 뒤 $m$ 으로 나눈 값이다. 이 제곱의 합은 $\boldsymbol{y}^\top \boldsymbol{y}$ 로 표현할 수 있다.
위 식에 $\boldsymbol{y} = \boldsymbol{Z}_c \boldsymbol{v}$ 를 대입하면 다음과 같다.
상수 $\frac{1}{m}$ 을 식 중앙에 넣고 정리하면 다음과 같이 유도할 수 있다.
괄호 안의 $\frac{1}{m} \boldsymbol{Z}_c^\top \boldsymbol{Z}_c$ 는 위에서 계산한 $n$ 차원 특징(feature) 벡터의 경험적 공분산 행렬 $\hat{\boldsymbol{\Sigma}} \in \mathbb{R}^{n \times n}$ 이다.
결론적으로, $n$ 차원의 임의의 방향 벡터 $\boldsymbol{v}$ 와 경험적 공분산 행렬 $\hat{\boldsymbol{\Sigma}}$ 를 결합한 이차 형식 $\boldsymbol{v}^\top \hat{\boldsymbol{\Sigma}} \boldsymbol{v}$ 를 계산하면, 이는 복잡한 행렬 투영 연산을 거치지 않고도 정사영된 1차원 데이터들의 실제 분산을 바로 계산할 수 있다.
“평균이 0인 데이터들을 임의의 공간으로 투영했을 때, 투영된 성분들의 평균도 0인가?”
mean centering된 n차원 데이터 샘플을 $\boldsymbol{z}_1, \boldsymbol{z}_2, \dots, \boldsymbol{z}_m$ 라고 해보자. 원본 데이터를 평균 중심화했다는 건 그 데이터들의 평균이 원점(0)이라는 뜻이다.
이 데이터들을 임의의 방향 벡터 $\boldsymbol{v}$ 위로 정사영내린다. 투영된 1차원 스칼라 좌표값 $y_i$ 는 내적으로 계산된다 ( $y_i = \boldsymbol{v}^\top \boldsymbol{z}_i$ ).
투영된 성분들의 평균 $\bar{y}$ 은 다음과 같다.
이때 $\boldsymbol{v}^\top$ 는 상수 벡터이므로 다음과 같이 정리할 수 있다.
평균 중심화는 기하학적으로 다차운 공간에 떠 있는 데이터 분포의 무게 중심을 원점으로 이동시키는 행위이다. 이때 이 공간 내 임의의 축을 골라 데이터들을 정사영내리는 변환은 무게 중심을 이동시키지 않고 그대로 유지한다.
이차 형식 최대화하기
이제 데이터가 가장 넓게 퍼져 있는 즉, 분산이 최대가 되는 방향 $\boldsymbol{v}$ 은 어떻게 찾는지에 대한 질문으로 넘어가게 된다.
목표는 분산 함수 $f(\boldsymbol{v}) = \boldsymbol{v}^\top \boldsymbol{\Sigma} \boldsymbol{v}$ 의 값을 최대화하는 벡터 $\boldsymbol{v}$ 를 찾는 것이다. 이때 이차 형식은 $\boldsymbol{v}$ 의 크기에 비례하므로, 단순히 벡터 $\boldsymbol{v}$ 의 길이를 키우면 함수가 최대가 된다. 우리는 데이터의 분산이 제일 큰 ‘방향’을 찾는 것이므로, 벡터 $\boldsymbol{v}$ 길이는 반드시 $1$ 이어야 한다는 제약 조건이 필수적이다.
제약 조건이 있는 최적화 문제를 풀기 위해 라그랑주 승수 $\lambda$ 를 사용하여 라그랑주 함수를 정의한다.
이 함수가 최대(혹은 최소)값을 가지는 극점을 찾기 위해, $\boldsymbol{v}$ 에 대해 편미분하고 그 결과를 영벡터( $\boldsymbol{0}$ )로 둔다. 공분산 행렬 $\boldsymbol{\Sigma}$ 는 대칭 행렬이므로 $\boldsymbol{v}^\top \boldsymbol{\Sigma} \boldsymbol{v}$ 의 미분은 $2\boldsymbol{\Sigma}\boldsymbol{v}$ 가 된다.
이 식을 정리하면 익숙한 형태가 도출된다.
즉, 데이터의 분산을 최대로 만드는 방향을 찾았는데, 그 후보 방향이 공분산 행렬의 고유벡터 중 하나임을 뜻한다.
목적 함수(라그랑주 함수)는 다차원 벡터 $\boldsymbol{v}$ 를 입력으로 받아 하나의 실수값을 출력하는 다변수 스칼라 함수이다. 이 함수가 최대값(혹은 최소값)을 가지려면, 기하학적으로 그 지점에서 접평면(tangent plane)의 기울기가 영이 되어야 한다. 즉, 어느 방향으로의 미소 변화량이 출력에 미치는 영향이 0이어야 한다.
다변수 스칼라 함수의 변화율(기울기)을 모든 변수 방향에 대해 모은 벡터가 그래디언트 $\nabla_{\boldsymbol{v}}$ 이다. 따라서 목적 함수를 $\boldsymbol{v}$ 로 미분하여 그 $n$ 차원 그래디언트 벡터를 구하고, 이를 영벡터( $\boldsymbol{0}$ )와 같다고 놓는 행위( $\frac{\partial \mathcal{L}}{\partial \boldsymbol{v}} = \boldsymbol{0}$ )는, 이 함수의 값이 극대점이나 극소점이 될 수 있는 모든 임계점 후보를 찾는 것과 같다.
그렇다면 찾은 점이 극대점인지 극소점인지 판별하기 위해 헤시안 행렬을 구하고 양의 정부호성을 따져야 하지만, 그 전에 목적 함수를 1차 미분한 그래디언트의 형태를 보자.
이것이 함의하는 바는 목적 함수의 기울기를 0으로 만드는 어떤 벡터가 있는데, 그 벡터가 바로 공분산 행렬의 고유벡터이며, 고유벡터로 데이터를 투영시켰을 때 분산이 극대화 또는 극소화된다는 점이다.
고유벡터의 의미를 기하학적으로 잘 생각해보면, 어떤 행렬이 벡터에 작용되는 변환의 주축(principal axis) 방향을 나타내므로, 공분산 행렬의 고유벡터는 데이터 분포가 다차원 공간상에서 어떤 방향으로 뻗어 나가며 분산되어 있는지를 나타내준다고 할 수 있다.
이어서 $\boldsymbol{\Sigma}\boldsymbol{v} = \lambda\boldsymbol{v}$ 에 대해 해석해보자. 공분산 행렬 $\boldsymbol{\Sigma}$ 라는 선형 변환을 벡터 $\boldsymbol{v}$ 에 가했을 때, 그 벡터의 ‘방향’은 전혀 틀어지지 않고 오직 ‘길이’만 $\lambda$ 배만큼 늘어나거나 줄어든다.
다차원 데이터 공간에서 이 고유벡터들은 데이터 분포가 퍼져 있는 독립적인 주축들을 의미한다.
공분산 행렬은 대칭 행렬이므로 스펙트럼 정리에 의해, 서로 다른 고윳값에 대응하는 고유벡터들은 반드시 서로 직교(Orthogonal)한다.
즉, 데이터가 얽혀 있는 복잡한 $n$ 차원 공간을, 서로 완전히 독립적이고 수직으로 교차하는 $n$ 개의 새로운 기저로 변환하는 것이다.
그렇다면 벡터의 길이가 늘어나는 비율인 고윳값 $\lambda$ 는 무엇을 의미할까? 이를 확인하기 위해 도출된 식 $\boldsymbol{\Sigma}\boldsymbol{v} = \lambda\boldsymbol{v}$ 의 양변 왼쪽에 $\boldsymbol{v}^\top$ 를 곱해본다(또는 목적함수에 대입).
우리가 설정한 제약 조건에 의해 $\boldsymbol{v}^\top \boldsymbol{v} = 1$ 이다. 따라서 식은 다음과 같이 정리된다.
좌변 $\boldsymbol{v}^\top \boldsymbol{\Sigma} \boldsymbol{v}$ 는 우리가 앞서 논의했던 “방향 $\boldsymbol{v}$ 로 정사영된 데이터의 분산”이다.
결론적으로 고윳값 $\lambda$ 는 데이터를 해당 고유벡터 방향으로 투영했을 때 얻어지는 ‘실제 분산의 크기’를 의미한다. 분산을 가장 크게 만들고 싶다면, 가장 큰 고윳값에 대응되는 고유벡터를 선택하면 된다.
그렇다면 고유벡터와 고유값은 어떻게 구할까. $n$ 차원 공간의 대칭 행렬인 공분산 행렬 $\boldsymbol{\Sigma}$ 는 서로 직교하는 $n$ 개의 고유벡터를 가진다. 위에서 라그랑주 상수를 사용한 목적함수의 그래디언트를 영으로 만드는 고유벡터를 구해야 하는데, 식을 보면 또 하나의 미지수 $\lambda$ 가 있다. 보통 이는 목적함수를 $\lambda$ 로도 미분하여 연립방정식을 풀이하는데, 현재는 특수한 경우로, 특성방정식 $\det(\boldsymbol{\Sigma} - \lambda\boldsymbol{I}) = 0$ 을 만족하는 $\lambda$ 를 구하면 $n$ 개의 고유벡터 $\boldsymbol{v}_i$ 은 자명하다. 이때 이 $n$ 개의 고윳값들을 크기순으로 정렬했을 때 ( $\lambda_1 \ge \lambda_2 \ge \dots \ge \lambda_n$ ), 가장 큰 고윳값 $\lambda_1$ 에 대응하는 제1 고유벡터 방향이며, 이 방향에서 분산일 가장 크다.
“평균 중심화( $\boldsymbol{Z}_c$ )와 정규화( $\frac{1}{m}$ )를 동일하게 적용한 상태에서, 행렬곱의 순서를 바꾼 $\frac{1}{m} \boldsymbol{Z}_c \boldsymbol{Z}_c^\top$ 연산은 어떤 의미를 가지는가?”에 대한 내용은 이 글에 작성하였다.
Reference
wikipidea
공돌이의 수학정리노트