Quantile-Quantile Plot
quantile은 분위수라는 의미인데, 분위수는 데이터를 오름차순(또는 내림차순)으로 정렬한 뒤, 전체 데이터를 특정 개수로 나눌 때 기준이 되는 수이다. 예를 들어 4분위수라고 하면 전체 데이터를 25%, 50%, 75%로 나눠 4등분한다는 것이다. Q-Q plot은 말 그대로 X, Y 축 척도가 분위수라는 의미인데 두 축을 단순 분위수로 두면 조금 추상적일 수 있다. 구체적으로 보자.
X축은 만약 데이터가 정규분포였다면 나왔어야 할 값이다. 일반적으로 표준정규분포의 z-값(표준편차 단위)을 사용한다.
Y축은 실제 내가 수집한 데이터의 값이다.
보통 Q-Q plot을 그릴 때 Y축은 원본 데이터값을 그대로 쓰는데, 이때 기준선(빨간 선)은 다음과 같은 1차 함수 형태를 띈다.
- 기울기( $\sigma$ ): 데이터의 표준편차
- 절편( $\mu$ ): 데이터의 평균
즉, 데이터의 평균과 표준편차에 맞춰서 ‘이 데이터가 정규분포라면 마땅히 있어야 할 이상적인 직선’을 긋는 것이다. 만약 데이터를 표준화했다면 기준선은 $y=x$ 가 된다.
아래 그래프는 데이터가 정규분포를 따르는지 Q-Q plot으로 시각화해보았다. 히스토그램의 빨간 점선은 이론적 정규분포이고, 파란 막대는 데이터의 빈도를 나타낸다. Q-Q plot의 빨간 선은 데이터가 정규분포를 따를 때 가져야 하는 실제 데이터 값에 대한 직선이다(ex. 데이터가 평균 100, 표준편차 10이라면 기준선은 $y=10x+100$ 이다).
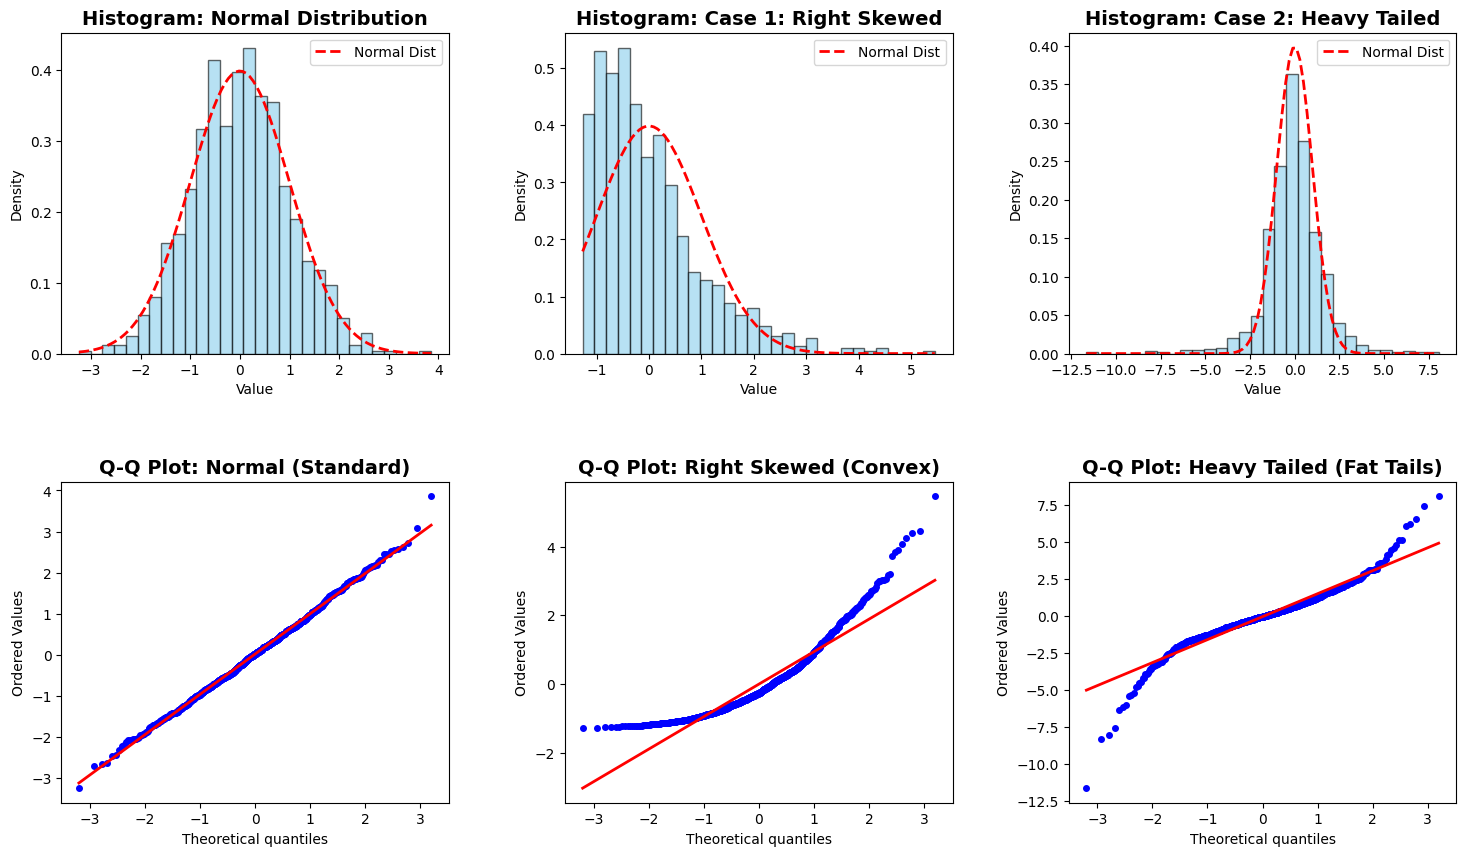
첫 번째 열(정규성을 만족하는 경우): 히스토그램에서 빨간 점선과 파란색 막대가 거의 일치한다. Q-Q plot에서 파란 점들이 기준선 위에 놓여있다. 때문에 데이터가 (표준)정규분포를 따른다고 볼 수 있다.
case 1: 히스토그램은 데이터가 빨간 점선 왼쪽에 쏠려 있고, 오른쪽으로 꼬리가 길게 늘어졌다. Q-Q plot에서 점들이 아래로 볼록한 곡선 형태를 가진다. 극단적으로 큰 값이 존재한다.
case 2: 히스토그램을 봤을 때 정규분포보다 꼬리가 더 긴(분산이 큰) t-분포이다. 이때 Q-Q plot을 보면 역 S자 형태를 보인다. 극단적으로 큰 값과 작은 값이 정규분포보다 많기 때문이다.
히스토그램과 Q-Q plot만으로 데이터의 정규성을 확신할 수 있을까.
히스토그램은 데이터를 몇 개의 막대로 나누느냐에 따라 모양이 바뀐다. 구간에 따라 정규분포 모양을 가질 수도, 아닐 수도 있다. case 2의 경우 정규분포보다 첨도(중심이 뾰족한 정도)가 작은 t분포이다. 이는 엄밀하게 정규분포가 아니며, 정규성을 위반할 수 있다.
때문에 히스토그램으로 데이터가 종 모양인지 확인하고, Q-Q plot으로 꼬리 부분이 튀지 않고 기준선위에 놓여있는지를 확인하고, Shapiro-wilk 등과 같은 검정 방법을 사용하여 통계적으로도 정규성을 가지는지 보여야 한다.
Q-Q plot을 누적 분포 함수로써 볼 수 있다. 사실 수학적으로 분위수는 누적 분포 함수(CDF)의 역함수이다. 먼저 두 개념을 연결해보겠다.
CDF: “내 점수(X)가 80점이라면, 나는 상위 몇 %(Y)인가?”, 점수(x) $\to$ 확률(y)
Quantile: “내가 상위 10%(X)가 되려면, 몇 점(Y)을 받아야 하는가?”, 확률(x) $\to$ 점수(y)
즉, Q-Q plot은 CDF를 x,y축을 뒤집어서(역함수) 비교하는 것과 같다.