이 책을 읽는 두 가지 방법
머신러닝에 필요한 수학을 이해하기 위한 전략으로 우리는 크게 두 가지 접근법을 고려할 수 있다.
- 상향식 접근 (Bottom-up):
가장 기초적인 개념부터 시작해 점차 고난도 개념으로 지식을 쌓아 올리는 방식이다. 이는 수학과 같이 기술적인 깊이가 필요한 분야에서 흔히 선호되는 전통적인 학습법이다. 이 전략의 장점은 학습자가 언제나 이전에 확실히 익힌 개념을 발판 삼아 다음 단계로 나아갈 수 있다는 점이다.
하지만 불행히도, 실무자 입장에서 기초 개념들은 그 자체만으로는 딱히 흥미롭지 않은 경우가 많다. 이로 인해 학습 동기가 떨어지게 되고, 결국 애써 배운 기초 정의들을 금방 잊어버리게 된다는 단점이 있다. - 하향식 접근 (Top-down):
실무적인 필요(practical needs)에서 출발하여, 그것을 해결하기 위해 필요한 기초 원리 쪽으로 파고들어 내려가는 방식이다. 이 ‘목표 지향적(goal-driven)’ 접근의 장점은 학습자가 특정 개념을 ‘왜’ 공부해야 하는지 그 이유를 항상 명확히 알 수 있으며, 필요한 지식의 경로가 뚜렷하다는 것이다.
반면, 이 전략의 치명적인 단점은 지식이 다소 불안정한 기초 위에 쌓일 위험이 있다는 것이다. 또한, 학습자는 해당 용어가 진정으로 무엇을 의미하는지 깊이 이해하지 못한 채, 단순히 용어들의 집합을 암기해야 하는 상황에 놓일 수 있다.
우리는 독자가 앞서 언급한 두 가지 방식(상향식, 하향식) 모두로 이 책을 읽을 수 있도록, 기초적인 수학 개념과 그 응용 분야를 분리하여 모듈식으로 집필했다.
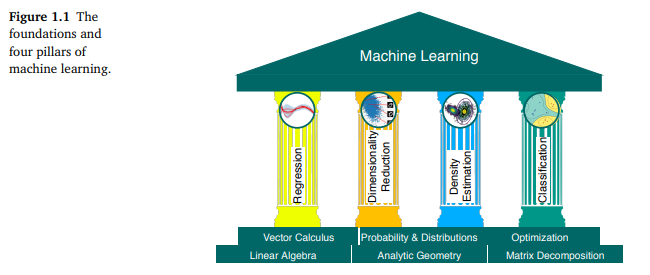
이 책은 크게 두 부분으로 나뉜다. 1부(Part I)에서는 수학적 기초를 다루고, 2부(Part II)에서는 1부의 개념들을 적용하여 머신러닝의 근간을 이루는 핵심 문제들을 해결한다. 그림 1.1에서 묘사한 것처럼 머신러닝은 1) 회귀(Regression), 2) 차원 축소(Dimensionality Reduction), 3) 밀도 추정(Density Estimation), 4) 분류(Classification)라는 네 개의 기둥으로 이루어져 있다.
1부의 각 챕터는 대부분 이전 챕터의 내용을 바탕으로 전개되지만, 필요하다면 건너뛰었다가 나중에 다시 돌아와서 공부하는 것도 가능하다. 반면 2부의 챕터들은 서로 느슨하게 연결되어 있어(loosely coupled) 순서에 상관없이 읽어도 무방하다. 또한 책 전반에 걸쳐 수학적 개념과 머신러닝 알고리즘을 유기적으로 연결하기 위해 1부와 2부를 오가는 참조 표시(pointers)를 많이 달아두었다.
$\quad$ 물론 이 책을 읽는 방법이 딱 두 가지만 있는 것은 아니다. 대부분의 독자는 상향식과 하향식 접근법을 적절히 섞어서 학습한다. 때로는 복잡한 개념에 도전하기 전에 기초 수학 실력을 먼저 쌓기도 하고, 때로는 머신러닝 애플리케이션에 대한 호기심을 따라 주제를 선택하기도 한다.
Part I은 수학에 관한 내용이다
앞서 그림 1.1에서 살펴본 머신러닝의 4대 기둥을 제대로 세우기 위해서는 탄탄한 수학적 기초가 필수적이며, 바로 이 내용을 1부(Part I)에서 다룬다.
$\quad$ 우리는 수치 데이터를 벡터(vector)로 표현하고, 이러한 데이터가 표 형태로 모인 것을 행렬(matrix)로 나타낸다. 이처럼 벡터와 행렬을 연구하는 학문을 선형대수(linear algebra)라 부르며, 이는 2장에서 상세히 소개한다. 벡터들의 집합을 어떻게 행렬로 다루는지에 대한 내용도 여기서 함께 설명될 것이다.
$\quad$ 한편, 현실 세계의 두 물체를 나타내는 두 개의 벡터가 주어졌을 때, 우리는 종종 이 둘이 얼마나 닮았는지, 즉 유사성(similarity)을 따져봐야 한다. 만약 두 벡터가 서로 비슷하다면, 머신러닝 알고리즘(예측기)에 넣었을 때 나오는 결과값 또한 비슷해야 한다는 것이 기본 아이디어다. 이러한 벡터 간의 유사성을 수학적으로 엄밀하게 정의(formalize)하기 위해서는, 두 벡터를 입력받아 그 유사도를 하나의 수치값으로 반환해 주는 연산이 필요하다. 이처럼 유사성과 거리(distance)의 개념을 구축하는 것이 바로 해석기하학(analytic geometry)의 핵심이며, 이는 3장에서 다룬다.
$\quad$ 4장에서는 행렬(matrix)과 행렬 분해(matrix decomposition)에 관한 기초적인 개념들을 소개한다. 행렬을 다루는 몇몇 특정 연산들은 머신러닝 분야에서 굉장히 유용하게 쓰이는데, 이러한 연산들을 활용하면 데이터를 직관적으로 해석할 수 있게 될 뿐만 아니라, 모델의 학습 효율 또한 크게 높일 수 있다.
$\quad$ 우리는 종종 데이터를 ‘진정한 신호(true underlying signal)’에 다소간의 ‘잡음(noise)’이 섞인 관측값으로 간주한다. 머신러닝을 적용함으로써 우리가 바라는 것은 이 잡음들 사이에서 진짜 신호만을 식별해내는 것이다. 이를 위해서는 도대체 ‘잡음’이란 무엇인지를 정량적으로 정의할 수 있는 언어가 필요하다. 또한 우리는 예측기(모델)가 단순히 결과값만 내놓는 것에 그치지 않고, 특정 데이터에 대한 예측 결과에 대해 얼마나 확신을 가지고 있는지(confidence), 즉 불확실성(uncertainty)을 함께 표현해주기를 원한다. 이처럼 불확실성을 수치로 정량화하는 영역이 바로 확률론(probability theory)이며, 이는 6장에서 다룬다.
$\quad$ 머신러닝 모델을 학습시킨다는 것은 일반적으로 특정 성능 지표(performance measure)를 최대화할 수 있는 파라미터를 찾아내는 과정이다. 수많은 최적화(optimization) 기법들은 해답을 찾기 위해 탐색해야 할 방향을 알려주는 ‘기울기(gradient)’ 개념을 필요로 한다. 5장에서는 벡터 미적분(vector calculus)을 다루며, 여기서 이 기울기(gradient)의 개념을 상세히 설명한다. 이어서 7장에서는 이 기울기 개념을 활용하여 함수의 최댓값이나 최솟값을 찾아내는 최적화(optimization)에 대해 본격적으로 논의한다.
Part II는 머신러닝에 관한 내용이다
$\quad$ 이 책의 2부(Part II)에서는 앞서 그림 1.1에서 소개한 머신러닝의 4대 기둥을 본격적으로 다룬다. 우리는 1부에서 다진 수학적 개념들이 이 네 가지 기둥을 지탱하는 토대가 됨을 보여줄 것이다. 대체로 각 챕터는 뒤로 갈수록 난이도가 높아지도록 구성되었다.
$\quad$ 8장에서는 머신러닝의 3대 핵심 요소인 데이터(data), 모델(model), 그리고 파라미터 추정(parameter estimation)을 수학적 언어로 다시 한번 명확히 정의한다. 이에 더해, 머신러닝 시스템의 성능을 지나치게 낙관적으로 평가하는 오류를 범하지 않도록 견고한 실험 환경을 구축하는 가이드라인도 제공한다. 다시 한번 강조하지만, 우리의 목표는 학습 과정에서 보지 못한 새로운 데이터(unseen data)에 대해서도 훌륭한 성능을 발휘하는 예측기(predictor)를 만드는 것이다.
$\quad$ 9장에서는 선형 회귀(linear regression)를 면밀히 살펴본다. 여기서 우리의 목표는 입력 $x \in \mathbb{R}^D$ 를 그에 상응하는 관측값 $y \in \mathbb{R}$ 로 매핑(mapping)하는 함수를 찾는 것이다. 이때 $y$ 는 각 입력에 대한 정답 라벨(label)로 해석할 수 있다. 우리는 최대 우도 추정(maximum likelihood)과 최대 사후 확률 추정(maximum a posteriori)을 통해 파라미터를 추정하는 고전적인 모델 피팅(model fitting) 방법을 논의할 것이다. 나아가 파라미터를 최적화하여 하나의 값을 찾는 대신, 파라미터를 적분하여 소거(integrate out)하는 방식인 베이지안 선형 회귀(Bayesian linear regression)도 함께 다룬다.
$\quad$ 10장에서는 그림 1.1의 두 번째 기둥인 차원 축소(dimensionality reduction)에 초점을 맞추며, 주성분 분석(PCA)을 활용한다. 차원 축소의 핵심 목표는 고차원 데이터 $x \in \mathbb{R}^D$ 에 대해, 원본보다 분석하기 쉬운 압축된 저차원 표현(representation)을 찾아내는 것이다. 회귀(regression)와 달리, 차원 축소는 오직 데이터 자체를 모델링하는 데에만 관심이 있으며 데이터 포인트 $x$ 에 연관된 라벨(label)은 존재하지 않는다.
$\quad$ 11장에서는 세 번째 기둥인 밀도 추정(density estimation)으로 넘어간다. 밀도 추정의 핵심 목표는 주어진 데이터셋의 분포 특성을 가장 잘 설명하는 확률 분포(probability distribution)를 찾아내는 것이다. 우리는 이를 위해 가우시안 혼합 모델(Gaussian Mixture Models, GMM)에 집중할 것이며, 이 모델의 최적 파라미터를 찾아내는 반복적인 알고리즘(iterative scheme)에 대해서도 논의할 것이다. 앞서 다룬 차원 축소와 마찬가지로, 밀도 추정에서도 데이터 포인트 $x \in \mathbb{R}^D$ 에는 정답 라벨(label)이 붙어있지 않다. 하지만 차원 축소와 달리, 여기서는 데이터를 저차원으로 압축하여 표현하는 것에는 관심이 없다. 대신 우리는 데이터가 어떻게 분포되어 있는지를 묘사하는 밀도 모델 그 자체를 찾는 데 주력한다.
$\quad$ 마지막으로 12장에서는 네 번째 기둥인 분류(classification)를 심도 있게 다루며 이 책을 마무리한다. 우리는 서포트 벡터 머신(Support Vector Machines, SVM)이라는 맥락에서 분류 문제를 논의할 것이다. 9장의 회귀(regression)와 비슷하게 분류 문제에서도 입력값 $x$ 와 그에 대응하는 정답 라벨 $y$ 가 주어진다. 하지만 실수값(real-valued)을 출력하던 회귀와 달리, 분류에서의 라벨은 정수(integer) 형태를 띠므로 이를 다루기 위해서는 특별한 주의와 접근 방식이 필요하다.