실무에서의 PCA 주요 단계
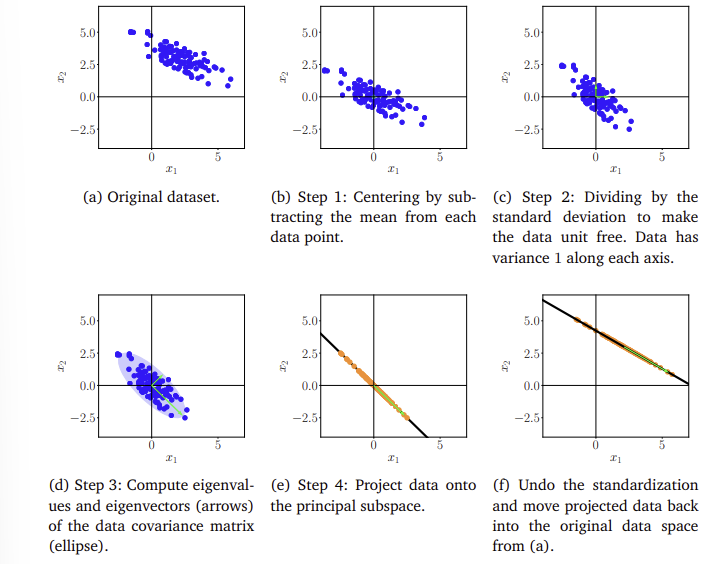
다음에서는 그림 10.11에 요약된 실행 예제를 통해 PCA의 개별 단계를 살펴본다. 2차원 데이터셋(그림 10.11(a))이 주어졌을 때, PCA를 사용하여 이를 1차원 부분공간으로 사영하고자 한다.
- 평균 빼기 (Mean subtraction): 데이터셋의 평균 $\boldsymbol{\mu}$ 를 계산하고 모든 데이터 포인트에서 이를 빼서 데이터를 중심화(centering)하는 것으로 시작한다. 이는 데이터셋의 평균이 $\boldsymbol{0}$ 이 되도록 보장한다(그림 10.11(b)). 평균 빼기가 엄격하게 필수적인 것은 아니지만, 수치적 문제의 위험을 줄여준다.
- 표준화 (Standardization): 모든 차원 $d = 1, \dots, D$ 에 대해 데이터 포인트를 데이터셋의 표준편차 $\sigma_d$ 로 나눈다. 이제 데이터는 단위가 없어지며(unit free), 각 축을 따라 분산 1을 갖게 된다. 이는 그림 10.11(c)의 두 화살표로 표시된다. 이 단계로 데이터의 표준화가 완료된다.
- 공분산 행렬의 고유값 분해 (Eigendecomposition of the covariance matrix): 데이터 공분산 행렬과 그 고윳값 및 대응하는 고유벡터를 계산한다. 공분산 행렬은 대칭이므로, 스펙트럼 정리(정리 4.15)에 의해 고유벡터들의 정규 직교 기저(ONB)를 찾을 수 있다. 그림 10.11(d)에서 고유벡터들은 대응하는 고윳값의 크기에 따라 스케일링되어 있다. 더 긴 벡터가 주 부분공간을 생성하며, 이를 $U$ 로 표시한다. 데이터 공분산 행렬은 타원으로 표현된다.
- 사영 (Projection): 임의의 데이터 포인트 $\boldsymbol{x}_* \in \mathbb{R}^D$ 를 주 부분공간으로 사영할 수 있다. 이를 정확히 수행하려면, 훈련 데이터의 $d$ 번째 차원의 평균 $\mu_d$ 와 표준편차 $\sigma_d$ 를 사용하여 $\boldsymbol{x}*$ 를 다음과 같이 표준화해야 한다.
여기서 $x\_\*^{(d)}$ 는 $\boldsymbol{x}\_\*$ 의 $d$ 번째 성분이다. 사영된 결과는 다음과 같이 얻는다.
주 부분공간의 기저에 대한 좌표는 다음과 같다.
여기서 $\boldsymbol{B}$ 는 데이터 공분산 행렬의 가장 큰 고윳값들과 연관된 고유벡터들을 열로 포함하는 행렬이다. PCA는 사영 결과인 $\tilde{\boldsymbol{x}}\_\*$ 가 아니라 좌표 (10.60)을 반환한다.
$\quad$ 데이터셋을 표준화했을 때, (10.59)는 표준화된 데이터셋의 맥락에서의 사영만을 제공한다. 원본 데이터 공간(즉, 표준화 전)에서의 사영을 얻으려면, 표준화 (10.58)를 취소하고 평균을 더하기 전에 표준편차를 곱해야 한다. 즉, 다음을 얻는다.
그림 10.11(f)는 원본 데이터 공간에서의 사영을 보여준다.
$\to$ 표준화(Standardization)는 데이터의 분포를 특정 형태( $\mu=0, \sigma=1$ )로 재구성하는 과정이다. 데이터의 척도(scale)를 통일하여 각 변수가 통계적으로 동일한 가중치를 갖게 한다. 변환 후 데이터의 평균은 항상 0, 분산은 항상 1이 되며, 데이터의 원래 분포 형태는 유지되나 단위가 제거된다. 표준화를 통해 분산이 큰 특정 변수가 주성분을 독점하는 현상을 방지한다.
정규화(Normalization)는 문맥에 따라 두 가지 의미로 사용되나, 본질적으로는 데이터를 특정 범위나 크기로 제한하는 연산이다.
첫 번째로 데이터 전처리에서의 정규화(min-max scaling)로, 데이터의 범위를 $[0, 1]$ 사이로 압축한다.
데이터의 최소/최대치를 고정하여 모든 변수를 동일한 범위 내에 배치한다. 이상치가 적은 데이터셋에서 유용하다. 만약 이상치가 있을 경우 분모인 $(x_{max} - x_{min})$ 이 과도하게 커지게 되며, 때문에 정상 범위의 데이터가 0 근처의 좁은 구간으로 압축된다. 대안적으로 중앙값이나 사분위수를 사용하여 스케일링할 수 있다.
두 번째로 벡터 $\boldsymbol{v}$ 를 자신의 노름(Norm, 크기)으로 나누는 연산이다.
벡터의 크기 정보를 제거하여 방향성만 고려하기 위함이다. 변환된 벡터의 길이는 항상 1( $\Vert \hat{\boldsymbol{v}}\Vert =1$ )이 되며, 이를 unit vector라고 한다.
주성분 축에 대해 정규화를 하여 데이터를 직교 사영할 기저로 사용한다.
예제 10.4 (MNIST 숫자: 재구성)
다음에서는 0부터 9까지의 손글씨 숫자 예제 60,000개를 포함하는 MNIST 숫자 데이터셋에 PCA를 적용할 것이다. 각 숫자는 $28 \times 28$ 크기의 이미지로, 784개의 픽셀을 포함하므로 이 데이터셋의 모든 이미지를 벡터 $\boldsymbol{x} \in \mathbb{R}^{784}$ 로 해석할 수 있다. 이러한 숫자들의 예시는 그림 10.3에 나와 있다.
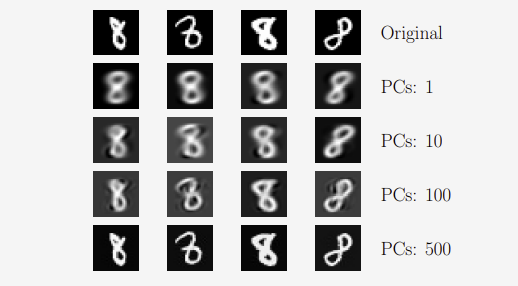
$\quad$ 설명을 목적으로 MNIST 숫자의 일부에 PCA를 적용하며, 숫자 “8”에 집중한다. 숫자 “8”에 해당하는 5,389개의 훈련 이미지를 사용했으며, 이 장에서 상세히 설명한 대로 주 부분공간을 결정했다. 그런 다음 학습된 투영 행렬을 사용하여 테스트 이미지 세트를 재구성했으며, 이는 그림 10.12에 시각화되어 있다. 그림 10.12의 첫 번째 행은 테스트 세트에서 가져온 4개의 원본 숫자 세트를 보여준다. 다음 행들은 주 부분공간의 차원을 각각 1, 10, 100, 500으로 사용했을 때 바로 이 숫자들을 재구성한 결과를 보여준다. 단일 차원 주 부분공간( $M=1$ )만으로도 원본 숫자의 꽤 괜찮은 재구성을 얻을 수 있지만, 흐릿하고 일반적인(generic) 형태임을 알 수 있다. 주성분(PC)의 개수가 증가함에 따라 재구성은 더 선명해지고 더 많은 세부 사항이 반영된다. 500개의 주성분을 사용하면 사실상 거의 완벽한 재구성을 얻게 된다. 만약 784개의 주성분을 선택한다면, 압축 손실 없이 정확한 숫자를 복원할 수 있을 것이다.
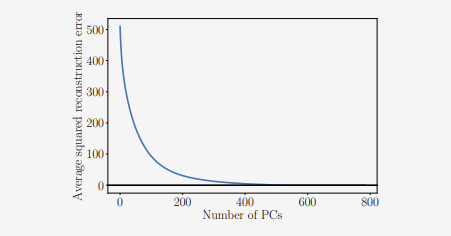
$\quad$ 그림 10.13은 주성분의 개수 $M$ 의 함수로서 평균 제곱 재구성 오차를 보여준다.
우리는 주성분의 중요도가 매우 빠르게 급감하며, 주성분을 더 추가함으로써 얻는 이득은 미미하다는 것을 확인할 수 있다. 이는 사영된 데이터 분산의 대부분이 단 몇 개의 주성분만으로도 포착된다는 것을 발견했던 그림 10.5의 관찰과 정확히 일치한다. 약 550개의 주성분이 있으면 숫자 “8”을 포함하는 훈련 데이터를 본질적으로 완전히 재구성할 수 있다 (경계 주변의 일부 픽셀은 항상 검은색이므로 데이터셋 전체에서 변동을 보이지 않기 때문이다).
MSE의 변화가 미미한 부분까지의 주성분을 사용하여 데이터를 압축하는 것이, 실제 데이터의 비선형적인 관계를 제거하진 않을까? 선형 관계를 일부 보존한 상태에서 이후 분석을 진행해도 타당한가?
선형 투영에 의한 정보 왜곡이 있지는 않을까? PCA는 데이터가 선형 부분공간에 존재한다는 가정이 내포되었으므로, 비선형 구조에 대한 비가역적인 정보 손실이 발생할 수 있다. 가령 스위스 롤처럼 말려 있는 비선형 매니폴드 구조에서 PCA는 곡률을 단지 평면에서 벗어난 오차로 간주한다.
또한 MSE 감소 폭이 적은 하위 주성분( $\lambda_{M+1}, \dots, \lambda_D$ )들은 대개 노이즈를 포함하지만, 동시에 데이터의 미세한 비선형적 패턴을 담고 있을 가능성도 있다.
각 주성분 축이 무슨 의미를 가지는지 해석할 수 있는가?
주성분은 원래 축(기존 변수)들의 선형결합이다. 만약 성적 데이터(국어, 영어, 수학, 과학)를 1차원( $PC_1$ )으로 압축했다고 가정해보자. 이때 $PC_1$ 는 다음과 같은 선형결합이다.
각 축에 곱해진 가중치를 부하량이라고 부른다. 만약 계산된 제1 주성분( $PC_1$ )과 제2 주성분( $PC_2$ )의 부하량이 다음과 같다고 가정해보자.
$PC_1 = 0.1(\text{국어}) + 0.1(\text{영어}) + \mathbf{0.7(\text{수학})} + \mathbf{0.7(\text{과학})}$
$PC_2 = \mathbf{0.7(\text{국어})} + \mathbf{0.7(\text{영어})} - 0.1(\text{수학}) - 0.1(\text{과학})$
이때 $PC_1$ 축을 ‘수리/탐구 능력’, $PC_2$ 를 ‘문과적 어학 능력’으로 해석할 수 있다.
이미지의 경우에 각 feature는 픽셀의 밝기 값일 뿐인데, 이때 각 주성분의 의미는 어떻게 해석하는가?
주성분 벡터를 다시 이미지의 형태로 렌더링하는 것이다.