역전파와 자동 미분
많은 머신러닝 응용 분야에서 우리는 모델의 파라미터에 대한 학습 목적 함수의 그래디언트를 계산할 수 있다는 사실에 의존하는 경사 하강법(섹션 7.1)을 수행하여 좋은 모델 파라미터를 찾는다. 주어진 목적 함수에 대해, 우리는 미적분학을 사용하고 연쇄 법칙을 적용하여 모델 파라미터에 대한 그래디언트를 얻을 수 있다; 섹션 5.2.2를 보라. 우리는 선형 회귀 모델의 파라미터에 대한 제곱 손실의 그래디언트를 살펴보았을 때 섹션 5.3에서 이미 맛을 보았다.
$\quad$ 다음 함수를 고려하자.
연쇄 법칙을 적용하고 미분이 선형적이라는 점에 주목하여, 우리는 다음 그래디언트를 계산한다.
이러한 명시적인 방식으로 그래디언트를 적어내는 것은 흔히 미분에 대한 매우 긴 표현식을 초래하기 때문에 비실용적인 경우가 많다. 실제로는, 우리가 주의하지 않으면, 그래디언트의 구현이 함수를 계산하는 것보다 훨씬 더 큰 비용이 들 수 있으며, 이는 불필요한 오버헤드를 부과한다는 것을 의미한다. 심층 신경망 모델을 훈련하기 위해, 역전파 알고리즘(Kelley, 1960; Bryson, 1961; Dreyfus, 1962; Rumelhart et al., 1986)은 모델의 파라미터에 대한 오차 함수의 그래디언트를 계산하는 효율적인 방법이다.
$\to$ 자동 미분과 역전파 알고리즘은 신경망처럼 층이 깊어지고 변수가 늘어나면, 어떤 함수를 명시적으로 푸는 것은 오랜 시간이 걸릴 수 있다. 반면 연쇄 법칙을 단계별로 쪼개어 국소적인 미분값을 저장하고 곱해나가는 방식을 쓰면 연산량을 획기적으로 줄여 효율적으로 그래디언트를 구할 수 있다.
5.6.1 심층 신경망에서의 그래디언트
연쇄 법칙이 극단적으로 사용되는 분야는 딥러닝이며, 여기서 함수값 $y$ 는 다층 함수 합성으로 계산된다.
여기서 $x$ 는 입력(예: 이미지), $y$ 는 관측값(예: 클래스 레이블)이며, 모든 함수 $f_i, i = 1, \dots, K$ 는 고유한 파라미터를 가진다.( $\to$ ‘고유한 파라미터’는 각 layer의 파라미터들이 서로 독립적이라는 의미이며, 때문에 모델이 더 풍부한 표현 또는 특징 학습, 유연한 분리가 가능하다.)
다중 레이어를 가진 신경망에서, 우리는 $i$ 번째 레이어에 함수 $f_i(x_{i-1}) = \sigma(A_{i-1} x_{i-1} + b_{i-1})$ 를 가진다. 여기서 $x_{i-1}$ 은 레이어 $i-1$ 의 출력이고 $\sigma$ 는 로지스틱 시그모이드 $\frac{1}{1+e^{-x}}$ , $\tanh$ , 또는 정류 선형 유닛(ReLU)과 같은 활성화 함수이다. 이러한 모델들을 훈련시키기 위해, 우리는 $j = 1, \dots, K$ 에 대한 모든 모델 파라미터 $A_j, b_j$ 와 관련하여 손실 함수 $L$ 의 그래디언트를 요구한다. 이는 또한 각 레이어의 입력에 대한 $L$ 의 그래디언트를 계산할 것을 우리에게 요구한다. 예를 들어, 만약 우리가 입력 $x$ 와 관측값 $y$ , 그리고 다음과 같이 정의된 네트워크 구조를 가진다면
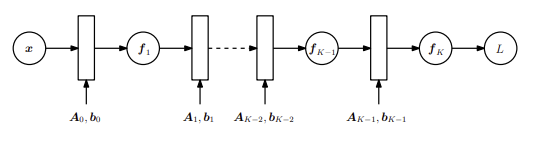
$\to$ 그림 5.8 입력 $x$ 와 파라미터 $A_i, b_i$ 의 함수로서 손실 $L$ 을 계산하기 위한 다층 신경망에서의 순전파.
시각화를 위해 그림 5.8도 참조하라, 우리는 다음의 제곱 손실이 최소화되도록 하는 $j = 0, \dots, K-1$ 에 대한 $A_j, b_j$ 를 찾는 데 관심이 있을 수 있다.
여기서 $\theta = {A_0, b_0, \dots, A_{K-1}, b_{K-1}}$ 이다.
$\quad$ 파라미터 집합 $\theta$ 에 대한 그래디언트를 얻기 위해, 우리는 각 레이어 $j = 0, \dots, K-1$ 의 파라미터 $\theta_j = {A_j, b_j}$ 에 대한 $L$ 의 편미분을 요구한다. 연쇄 법칙은 우리가 편미분을 다음과 같이 결정할 수 있게 해준다.
주황색 항들은 레이어의 입력에 대한 레이어 출력의 편미분이고, 반면에 파란색 항들은 레이어의 파라미터에 대한 레이어 출력의 편미분이다. 우리가 이미 편미분 $\partial L/\partial \theta_{i+1}$ 을 계산했다고 가정하면, 계산의 대부분(주황색 항들의 곱)은 $\partial L/\partial \theta_i$ 를 계산하기 위해 재사용될 수 있다. 우리가 추가로 계산해야 하는 항들은 상자로 표시되어 있다. 그림 5.9는 그래디언트가 네트워크를 통해 역방향으로 전달되는 것을 시각화한다.
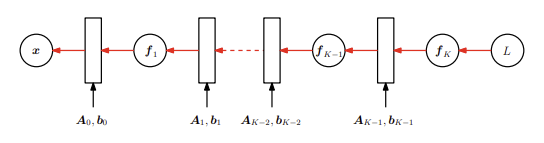
그림 5.9 다층 신경망에서 손실 함수의 그래디언트를 계산하기 위한 역전파.
5.6.2 자동 미분
역전파는 수치 해석에서 자동 미분(automatic differentiation)이라고 불리는 일반적인 기법의 특수한 경우로 밝혀졌다. 우리는 자동 미분을 기호적(symbolic)인 방식과 대조적으로, 중간 변수들을 다루고 연쇄 법칙을 적용하여 함수의 정확한(기계 정밀도 내에서) 그래디언트를 수치적으로 평가하는 일련의 기법들로 생각할 수 있다. 자동 미분은 덧셈과 곱셈 같은 일련의 기초 산술 연산들과 $\sin, \cos, \exp, \log$ 같은 기초 함수들을 적용한다. 이러한 연산들에 연쇄 법칙을 적용함으로써, 꽤 복잡한 함수들의 그래디언트가 자동으로 계산될 수 있다. 자동 미분은 일반적인 컴퓨터 프로그램에 적용되며 전진 모드(forward mode)와 후진 모드(reverse mode)를 가진다. Baydin et al. (2018)은 머신러닝에서의 자동 미분에 대한 훌륭한 개요를 제공한다.
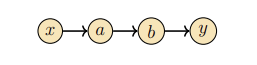
그림 5.10 일부 중간 변수 $a, b$ 를 경유하여 $x$ 에서 $y$ 로의 데이터 흐름을 설명하는 단순한 그래프.
$\quad$ 그림 5.10은 일부 중간 변수 $a, b$ 를 경유하여 입력 $x$ 에서 출력 $y$ 로의 데이터 흐름을 나타내는 단순한 그래프를 보여준다. 만약 우리가 도함수 $dy/dx$ 를 계산하려고 한다면, 우리는 연쇄 법칙을 적용하여 다음을 얻을 것이다.
직관적으로, 전진 모드와 후진 모드는 곱셈의 순서에서 차이가 난다. 행렬 곱셈의 결합 법칙으로 인해, 우리는 다음 사이에서 선택할 수 있다.
식 (5.120)은 그래디언트가 그래프를 통해 역방향으로, 즉 데이터 흐름과 반대로 전달되기 때문에 후진 모드가 될 것이다. 식 (5.121)은 그래디언트가 그래프를 통해 왼쪽에서 오른쪽으로 데이터와 함께 흐르는 전진 모드가 될 것이다.
$\quad$ 다음에서, 우리는 역전파인 후진 모드 자동 미분에 초점을 맞출 것이다. 입력 차원이 종종 레이블의 차원보다 훨씬 더 높은 신경망의 문맥에서, 후진 모드는 전진 모드보다 계산적으로 상당히 더 저렴하다. 유익한 예제부터 시작해 보자.
예제 5.14
(5.109)의 함수
를 고려하자. 만약 우리가 컴퓨터에 함수 $f$ 를 구현한다면, 중간 변수들을 사용하여 계산을 다소 절약할 수 있을 것이다.
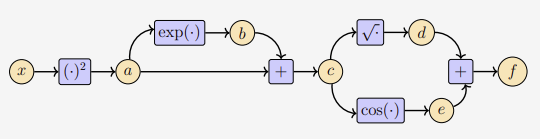
$\quad$ 이것은 연쇄 법칙을 적용할 때 일어나는 사고 과정과 동일한 종류이다. 앞선 일련의 방정식들은 (5.109)에 정의된 함수 $f(x)$ 의 직접적인 구현보다 더 적은 연산을 필요로 한다는 점에 주목하라. 그림 5.11의 해당하는 계산 그래프는 함수값 $f$ 를 얻기 위해 요구되는 데이터의 흐름과 계산들을 보여준다.
$\quad$ 중간 변수들을 포함하는 일련의 방정식들은 계산 그래프로 생각될 수 있으며, 이는 신경망 소프트웨어 라이브러리들의 구현에서 널리 사용되는 표현이다. 우리는 기본 함수들의 미분 정의를 상기함으로써, 중간 변수들의 미분을 그에 대응하는 입력들에 대해 직접 계산할 수 있다. 우리는 다음을 얻는다.
그림 5.11의 계산 그래프를 살펴봄으로써, 우리는 출력에서부터 역방향으로 작업하여 $\partial f / \partial x$ 를 계산할 수 있고 다음을 얻는다.
$\partial f / \partial x$ 를 얻기 위해 우리가 연쇄 법칙을 암묵적으로 적용했음에 주목하라. 기본 함수들의 미분 결과들을 대입함으로써, 우리는 다음을 얻는다.
위 미분들 각각을 하나의 변수로 생각함으로써, 미분을 계산하는 데 요구되는 연산이 함수 자체의 연산과 비슷한 복잡도를 가진다는 것을 우리는 관찰한다. 이는 $\frac{\partial f}{\partial x}$ 의 수학적 표현식 (5.110)이 (5.109)에 있는 함수 $f(x)$ 의 수학적 표현식보다 훨씬 더 복잡하기 때문에 꽤 직관에 반한다.
$\quad$ 자동 미분은 예제 5.14의 공식화이다. $x_1, \dots, x_d$ 를 함수의 입력 변수, $x_{d+1}, \dots, x_{D-1}$ 을 중간 변수, 그리고 $x_D$ 를 출력 변수라고 하자. 그러면 계산 그래프는 다음과 같이 표현될 수 있다.
여기서 $g_i(\cdot)$ 는 기본 함수들이고 $x_{\text{Pa}(x_i)}$ 는 그래프에서 변수 $x_i$ 의 부모 노드들이다. 이런 방식으로 정의된 함수가 주어지면, 우리는 연쇄 법칙을 사용하여 단계적인 방식으로 함수의 도함수를 계산할 수 있다. 정의에 의해 $f = x_D$ 이므로 다음이 성립함을 상기하자.
다른 변수들 $x_i$ 에 대해, 우리는 연쇄 법칙을 적용한다.
여기서 $\text{Pa}(x_j)$ 는 계산 그래프에서 $x_j$ 의 부모 노드들의 집합이다. 식 (5.143)은 함수의 순전파인 반면, (5.145)는 계산 그래프를 통과하는 그래디언트의 역전파이다. 신경망 훈련을 위해, 우리는 레이블에 대한 예측 오차를 역전파한다.
$\quad$ 위의 자동 미분 접근법은 우리가 기본 함수들이 미분 가능한 계산 그래프로 표현될 수 있는 함수를 가질 때마다 작동한다. 사실, 함수는 수학적 함수가 아니라 컴퓨터 프로그램일 수도 있다. 하지만 모든 컴퓨터 프로그램이 자동으로 미분될 수 있는 것은 아니다, 예컨대 만약 우리가 미분 가능한 기본 함수들을 찾을 수 없다면 말이다. for 루프나 if 문 같은 프로그래밍 구조들도 더 많은 주의를 요구한다.
$\to$ 신경망의 그래디언트 계산의 본질은 무수한 야코비안 행렬들의 연쇄적인 곱셈이다. 여기서 행렬 곱셈의 결합 법칙이 성립한다는 대수적 전제가 반드시 포함되어야 한다. 덕분에 미분 연산의 순서를 자유롭게 바꿀 수 있다.
$\to$ 대부분의 목적 함수는 방대한 파라미터(다변수)를 단 하나의 오차값(스칼라)으로 매핑한다. 결합 법칙을 이용하여 입력에서 출력 방향(전진 모드)으로 행렬을 곱해 나가면, 거대한 야코비안 행렬 간의 행렬-행렬 곱셈이 발생하여 연산 복잡도가 폭발한다. 반면, 출력에서 입력 방향(후진 모드)으로 곱해 나가면, 스칼라에서 시작된 행벡터와 야코비안 행렬간의 벡터-야코비안 곱(VJP)만을 연쇄적으로 수행하게 된다. 이는 무의미한 0의 곱셈을 배제하여 효율적인 연산을 가능케 한다.