벡터 값을 가지는 함수의 그래디언트
지금까지 우리는 실수( $\mathbb{R}$ )로 매핑되는 함수 $f: \mathbb{R}^n \rightarrow \mathbb{R}$ 의 편미분과 그라디언트를 논의했다. 이제부터는 그라디언트의 개념을 벡터 값을 가지는 함수(벡터 장) $f: \mathbb{R}^n \rightarrow \mathbb{R}^m$ (여기서 $n \ge 1, m > 1$ )로 일반화할 것이다.
$\quad$ 함수 $f: \mathbb{R}^n \rightarrow \mathbb{R}^m$ 과 벡터 $x = [x_1, \dots, x_n]^\top \in \mathbb{R}^n$ 에 대하여, 이에 대응하는 함숫값들의 벡터는 다음과 같이 주어진다.
벡터 값을 가지는 함수를 이런 식으로 작성하면, 함수 $f: \mathbb{R}^n \rightarrow \mathbb{R}^m$ 를 실수로 매핑되는 함수들 $f_i: \mathbb{R}^n \rightarrow \mathbb{R}$ 의 벡터 $[f_1, \dots, f_m]^\top$ 으로 볼 수 있다. 모든 $f_i$ 에 대한 미분 규칙은 우리가 5.2절에서 논의했던 것과 정확히 동일하다.
$\quad$ 따라서, 벡터 함수 $f: \mathbb{R}^n \rightarrow \mathbb{R}^m$ 를 $x_i \in \mathbb{R} (i = 1, \dots, n)$ 에 대해 편미분한 결과는 다음과 같은 벡터가 된다.
$\to$ 식 (5.55)의 극한 표현은 각 입력값( $x_i$ )이 $h$ 만큼 변했을 때, 또한 그 변화량 $h$ 가 0에 가까운 값일 때 특정 출력( $f$ )이 얼마나 변하는가를 열로 쌓은 것이다. 이를 특정 $x_i$ 가 아닌 모든 입력에 대해 표기한 것이 (5.56b)이다.
식 (5.40)으로부터, 우리는 벡터에 대한 $f$ 의 그라디언트가 편미분들의 행 벡터라는 것을 알고 있다. 식 (5.55)에서 각 편미분 $\partial f / \partial x_i$ 는 그 자체가 열 벡터이다. 따라서 우리는 이러한 편미분들을 모아서 $x \in \mathbb{R}^n$ 에 대한 $f: \mathbb{R}^n \rightarrow \mathbb{R}^m$ 의 그라디언트를 다음과 같이 얻는다.
정의 5.6 (야코비안). 벡터 값을 가지는 함수 $f: \mathbb{R}^n \rightarrow \mathbb{R}^m$ 의 모든 1차 편미분들의 모음을 야코비안(Jacobian)이라고 부른다. 야코비안 $J$ 는 $m \times n$ 행렬이며, 우리는 이를 다음과 같이 정의하고 배열한다.
$\quad$ (5.58)의 특수한 경우로서, 벡터 $x \in \mathbb{R}^n$ 를 스칼라(예: $f(x) = \sum_{i=1}^n x_i$ )로 매핑하는 함수 $f: \mathbb{R}^n \rightarrow \mathbb{R}^1$ 는 행 벡터(차원이 $1 \times n$ 인 행렬)인 야코비안을 가진다 (5.40 참조).
참고. 이 책에서 우리는 미분의 분자 중심 표기법(numerator layout)을 사용한다. 즉, $f \in \mathbb{R}^m$ 의 $x \in \mathbb{R}^n$ 에 대한 미분 $df/dx$ 는 $m \times n$ 행렬이며, 여기서 $f$ 의 원소들은 행(row)을 정의하고 $x$ 의 원소들은 대응하는 야코비안의 열(column)을 정의한다 (5.58 참조). 분자 중심 표기법의 전치(transpose)인 분모 중심 표기법(denominator layout)도 존재한다. 이 책에서는 분자 중심 표기법을 사용할 것이다.
$\quad$ 우리는 6.7절에서 확률 분포에 대한 변수 변환(change-of-variable) 방법에서 야코비안이 어떻게 사용되는지 보게 될 것이다. 변수의 변환으로 인한 스케일링(크기 변화)의 양은 행렬식(determinant)에 의해 제공된다.
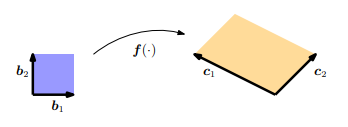
$\to$ 그림 5.5: $f$ 의 야코비안의 행렬식은 파란색 영역과 주황색 영역 사이의 확대 비율(magnifier)을 계산하는 데 사용될 수 있다.
$\quad$ 4.1절에서 우리는 행렬식이 평행사변형의 넓이를 계산하는 데 사용될 수 있음을 보았다. 만약 단위 정사각형(그림 5.5의 파란색)의 변으로 두 벡터 $b_1 = [1, 0]^\top, b_2 = [0, 1]^\top$ 이 주어진다면, 이 정사각형의 넓이는 다음과 같다.
만약 우리가 변이 $c_1 = [-2, 1]^\top, c_2 = [1, 1]^\top$ 인 평행사변형(그림 5.5의 주황색)을 취한다면, 그 넓이는 행렬식의 절댓값으로 주어진다 (4.1절 참조).
즉, 이 평행사변형의 넓이는 단위 정사각형 넓이의 정확히 3배이다. 우리는 단위 정사각형을 다른 정사각형(또는 평행사변형)으로 변환하는 매핑(mapping)을 찾음으로써 이 스케일링 팩터(확대 비율)를 찾을 수 있다. 선형대수 용어로 말하자면, 우리는 $(b_1, b_2)$ 에서 $(c_1, c_2)$ 로의 변수 변환을 효과적으로 수행하는 것이다. 우리의 경우, 매핑은 선형이며 이 매핑의 행렬식의 절댓값은 우리가 찾고 있는 스케일링 팩터를 정확하게 제공한다.
$\quad$ 우리는 이 매핑을 식별하기 위한 두 가지 접근 방식을 설명할 것이다. 첫째, 매핑이 선형이라는 점을 이용하여 2장의 도구를 사용해 매핑을 식별한다. 둘째, 이번 장에서 논의해 온 도구인 편미분을 사용하여 매핑을 찾는다.
접근법 1 (선형대수적 접근)
선형대수 접근법을 시작하기 위해, 우리는 ${b_1, b_2}$ 와 ${c_1, c_2}$ 를 모두 $\mathbb{R}^2$ 의 기저(basis)로 간주한다(복습은 2.6.1절 참조). 우리가 효과적으로 수행하려는 것은 $(b_1, b_2)$ 에서 $(c_1, c_2)$ 로의 기저 변환(change of basis)이며, 우리는 이 기저 변환을 구현하는 변환 행렬을 찾고 있는 것이다. 2.7.2절의 결과를 사용하여, 우리는 원하는 기저 변환 행렬을 다음과 같이 식별할 수 있다.
이 행렬은 $Jb_1 = c_1$ 그리고 $Jb_2 = c_2$ 를 만족한다. 우리가 찾고 있는 스케일링 팩터(확대 비율)를 제공하는 $J$ 의 행렬식 절댓값은 $\vert \det(J)\vert = 3$ 으로 주어지며, 이는 $(c_1, c_2)$ 에 의해 생성된 정사각형의 넓이가 $(b_1, b_2)$ 에 의해 생성된 넓이보다 3배 더 크다는 것을 의미한다.
접근법 2 (미분적 접근)
선형대수 접근법은 선형 변환에 대해서만 작동한다. 비선형 변환(이는 6.7절에서 중요해진다)의 경우, 우리는 편미분을 사용하는 더 일반적인 접근법을 따른다.
$\quad$ 이 접근법에서는 변수 변환을 수행하는 함수 $f: \mathbb{R}^2 \rightarrow \mathbb{R}^2$ 를 고려한다. 우리 예제에서, $f$ 는 $(b_1, b_2)$ 에 대한 임의의 벡터 $\mathbf{x} \in \mathbb{R}^2$ 의 좌표 표현을 $(c_1, c_2)$ 에 대한 좌표 표현 $\mathbf{y} \in \mathbb{R}^2$ 로 매핑한다. 우리는 $f$ 에 의해 변환될 때 면적(또는 부피)이 어떻게 변하는지 계산할 수 있도록 이 매핑을 식별하고자 한다. 이를 위해, 우리는 $x$ 를 아주 조금 수정했을 때 $f(x)$ 가 어떻게 변하는지 알아내야 한다. 이 질문에 대한 정확한 답은 야코비안 행렬 $\frac{df}{dx} \in \mathbb{R}^{2 \times 2}$ 가 제공한다. 우리는 다음과 같이 쓸 수 있으므로,
$x$ 와 $y$ 사이의 함수적 관계를 얻게 되고, 이를 통해 편미분을 구할 수 있다.
그리고 다음과 같이 야코비안을 구성한다.
야코비안은 우리가 찾고 있는 좌표 변환을 나타낸다. 좌표 변환이 선형인 경우(우리의 예제처럼) 이는 정확하며, (5.66)은 (5.62)의 기저 변환 행렬을 정확하게 복원한다. 만약 좌표 변환이 비선형이라면, 야코비안은 이 비선형 변환을 국소적으로(locally) 선형 변환으로 근사한다. 야코비안 행렬식의 절댓값 $\vert \det(J)\vert$ 는 좌표가 변환될 때 면적이나 부피가 스케일링되는 비율이다. 우리의 경우 $\vert \det(J)\vert = 3$ 이다.
$\to$ 기하학적으로, 야코비안 행렬식은 우리가 면적이나 부피를 변환할 때 확대/스케일링 팩터를 제공한다.
$\quad$ 야코비안 행렬식과 변수 변환은 6.7절에서 확률 변수와 확률 분포를 변환할 때 관련이 깊어진다. 이러한 변환은 머신러닝에서 재파라미터화 트릭(reparametrization trick) 또는 무한 섭동 분석(infinite perturbation analysis)을 사용하여 심층 신경망을 학습시키는 문맥에서 매우 중요하다.
$\quad$ 이 장에서 우리는 함수의 미분들을 접했다. 그림 5.6은 이러한 미분들의 차원을 요약한 것이다. 만약 $f: \mathbb{R} \rightarrow \mathbb{R}$ 이면 그라디언트는 단순히 스칼라이다(왼쪽 위). $f: \mathbb{R}^D \rightarrow \mathbb{R}$ 인 경우 그라디언트는 $1 \times D$ 행 벡터이다(오른쪽 위). $f: \mathbb{R} \rightarrow \mathbb{R}^E$ 인 경우 그라디언트는 $E \times 1$ 열 벡터이고, $f: \mathbb{R}^D \rightarrow \mathbb{R}^E$ 인 경우 그라디언트는 $E \times D$ 행렬이다.
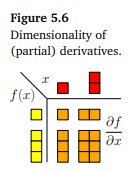
$\to$ 그림 5.6 : (편)미분의 차원성.
예제 5.9 (벡터 값을 가지는 함수의 그라디언트)
다음과 같은 조건이 주어졌다고 하자.
그라디언트 $df/dx$ 를 계산하기 위해 먼저 $df/dx$ 의 차원을 결정한다. $f: \mathbb{R}^N \rightarrow \mathbb{R}^M$ 이므로, $df/dx \in \mathbb{R}^{M \times N}$ 임이 도출된다. 두 번째로, 그라디언트를 계산하기 위해 모든 $x_j$ 에 대한 $f$ 의 편미분을 구한다.
( $i$ 번째 출력 $f_i$ 는 $A$ 의 $i$ 번째 행과 $x$ 의 내적이다. 또한 $f_i$ 의 편미분은 $A$ 의 행과 같다. $i,j$ 를 추적하는 것보다 간단한 수를 대입해서 풀자.)
우리는 이 편미분들을 야코비안에 모아 다음과 같은 그라디언트를 얻는다.
$\to$ 예제 5.9의 함수 $f$ 의 각 변수들은 독립적으로 덧셈으로만 연결된 선형적인 관계를 가진다.
$\to$ 함수 $f=Ax$ 양변에 전미분 연산자 $d$ 를 취하면 A는 상수 행렬이므로 미분 연산자 밖으로 빠져나올 수 있다.
다변수 함수의 전미분 공식은 기본적으로 $df = J dx$ (이때 $J$ 는 야코비 행렬)의 형태를 가진다. 도출해 낸 두 식의 형태를 대수적으로 비교하면, 중간에 끼어있는 행렬이 곧 야코비 행렬임을 알 수 있다.
또, 기하학적으로 $f(x) = Ax$ 는 1차 선형 변환이다. 단일 변수 함수 $y = mx$ 의 미분값이 기울기 상수 $m$ 인 것처럼, 행렬 차원의 완벽한 선형 함수인 $Ax$ 를 $x$ 로 미분하면( $\frac{\partial (Ax)}{\partial x}$ ) 그 기울기 역할을 하는 변환 행렬 $A$ 자체가 튀어나와야 한다는 기하학적 직관과 일치한다.
예제 5.10 (연쇄 법칙)
함수 $h: \mathbb{R} \rightarrow \mathbb{R}, h(t) = (f \circ g)(t)$ 를 고려하자. 여기서 각 함수는 다음과 같이 정의된다.
그리고 $t$ 에 대한 $h$ 의 그라디언트를 계산하라. $f: \mathbb{R}^2 \rightarrow \mathbb{R}$ 이고 $g: \mathbb{R} \rightarrow \mathbb{R}^2$ 이므로 우리는 다음의 차원을 가짐을 알 수 있다.
$\quad$ 우리가 구하고자 하는 그라디언트는 연쇄 법칙을 적용하여 다음과 같이 계산된다.
여기서 $x_1 = t \cos t$ 이고 $x_2 = t \sin t$ 이다 (5.72 참조).
$\to$ 식 (5.74b)에서 $[\exp(x_1x_2)x_2 \quad \exp(x_1x_2)x_1] \begin{bmatrix} \cos t - t \sin t \ \sin t + t \cos t \end{bmatrix}$ 를 $J$ 로 두면 아래와 같이 표기할 수 있다:
이를 해석해보면 단순히 식 (5.74b)의 양변에 $dt$ 를 곱한 것처럼 보인다. 예제 5.11에서 더 자세히 다뤄보자.
예제 5.11 (선형 모델에서 최소 제곱 손실의 그라디언트)
다음과 같은 선형 모델을 고려해 보자.
여기서 $\theta \in \mathbb{R}^D$ 는 파라미터 벡터, $\Phi \in \mathbb{R}^{N \times D}$ 는 입력 특징(input features), 그리고 $y \in \mathbb{R}^N$ 는 그에 대응하는 관측값이다. 우리는 다음의 함수들을 정의한다.
우리는 $\frac{\partial L}{\partial \theta}$ 를 구하고자 하며, 이를 위해 연쇄 법칙을 사용할 것이다. $L$ 은 최소 제곱 손실 함수(least-squares loss function)라고 불린다.
$\quad$ 계산을 시작하기 전에, 다음과 같이 그라디언트의 차원을 결정한다.
연쇄 법칙을 통해 우리는 그라디언트를 다음과 같이 계산할 수 있다( $\to$ 이 연산은 $1 \times D = (1 \times N) \times (N \times D)$ 의 행렬 곱이다).
여기서 $d$ 번째 원소는 다음과 같이 주어진다.
( $\to$ 식 (5.80)은 파라미터( $\theta$ )중 $d$ 번째 원소인 $\theta_d$ 가 변할 때, 최종 손실 $L$ 이 얼마나 변하는지를 뜻한다. 전체의 그라디언트 $\frac{\partial L}{\partial \theta}$ 는 $1 \times D$ 행 벡터이므로, $d$ 번째 열에 해당하는 원소는 $\frac{\partial L}{\partial \theta}[1, d]$ 로 표기할 수 있다. 또한 $\theta_d$ 는 중간에 $e_1, e_2, \dots, e_N$ 에도 영향을 미치기 때문에 $\frac{\partial L}{\partial \theta_d}$ 의 전미분($\frac{\partial L}{\partial \theta_d} = \left( \frac{\partial L}{\partial e_1} \cdot \frac{\partial e_1}{\partial \theta_d} \right) + \left( \frac{\partial L}{\partial e_2} \cdot \frac{\partial e_2}{\partial \theta_d} \right) + \dots + \left( \frac{\partial L}{\partial e_N} \cdot \frac{\partial e_N}{\partial \theta_d} \right) $)을 구해야 한다. 이를 시그마를 사용하여 표현하면$ \frac{\partial L}{\partial \theta_d} = \sum_{n=1}^N \frac{\partial L}{\partial e_n} \frac{\partial e_n}{\partial \theta_d}$인며 이를 행렬의 인덱스 표기법으로 변환하면 식 (5.80)이 유도된다.)
우리는 $\Vert e\Vert ^2 = e^\top e$ 임을 알고 있으며 (3.2절 참조), 다음을 결정할 수 있다.
나아가, 다음을 얻는다.
따라서 우리가 원하는 도함수는 다음과 같다.
참고. 우리는 함수를 즉시 전개하여 연쇄 법칙을 사용하지 않고도 동일한 결과를 얻을 수 있었을 것이다.
이러한 접근법은 $L_2$ 와 같이 단순한 함수에 대해서는 여전히 실용적이지만, 깊은 합성 함수(deep function compositions)에 대해서는 비실용적이 된다.
$\to$ Remark는 함수를 전개하여 도함수를 구하는 것을 말한다. 때문에 이 방법은 깊은 합성 함수에서 비실용적이며, chain rule 자체를 쓸 필요가 없어진다. 예제의 풀이 방법은 아래 첨자를 추적해야 하므로 식이 조금만 복잡해져도 따라가기 쉽지 않다.
따라서 미분 기호( $d$ )를 활용한 Differential form을 생각해 볼 수 있다. 이 방법은 행렬과 벡터를 쪼개지 않고 전체 덩어리의 미세 변화량 $d$ 를 다룬다(예: $df = d(Ax)$ ). 대수학의 규칙(행렬 곱셈 순서 유지 등)만 잘 지키면서 수식을 전개하면, 마지막에 $df = [\text{네모}] dx$ 형태로 정리될 때 저 $[\text{네모}]$ 자리에 있는 덩어리가 수학적으로 완벽하게 차원이 맞춰진 야코비안(그라디언트)으로 자동 유도된다.
$\to$ [적용] 목표는 손실 함수 $L(\theta) = (y - \Phi\theta)^\top (y - \Phi\theta)$ 를 파라미터 $\theta$ 로 미분하는 것이다. $e = y - \Phi\theta$ 로 치환하면 $L$ 을 $e$ 에 대한 함수( $L = e^\top e$ )로 표기할 수 있다.
그 다음 양변에 미분 기호 $d$ 를 취한다:
이때 $e$ 는 열 벡터이므로, $(de)^\top e$ 는 두 벡터의 내적, 즉 스칼라이다. 스칼라는 전치를 취해도 자기 자신과 똑같다. 따라서 $((de)^\top e)^\top = e^\top (de)$ 가 성립하므로, 두 항은 사실 완벽히 같은 항이다.
속함수( $e = y - \Phi\theta$ )의 미세 변화량 $de$ 를 구하면 관측값 $y$ 와 $\Phi$ 는 상수이므로 다음과 같다:
(이때 $-\Phi$ 은 출력 벡터 $e$ 가 입력 벡터 $\theta$ 에 의해 변할 때, 두 미세 변화량의 관계( $\frac{\partial e}{\partial \theta}$ )를 나타내는 야코비안 행렬( $J$ )이다.)
(2)를 (1)에 대입하면 다음과 같다:
원래의 $e = y - \Phi\theta$ 를 대입하면:
야코비안의 정의 $dL = \left(\frac{\partial L}{\partial \theta}\right)d\theta$ 와 비교하여 패턴 매칭을 하면 최종 그라디언트를 얻을 수 있다.
식 (5)는 인덱스 전개를 사용한 예제 5.11의 결과와 완벽하게 똑같다.