요약 통계량 및 독립성
우리는 종종 확률 변수들의 집합을 요약하고 확률 변수 쌍들을 비교하는 데 관심을 가진다. 확률 변수의 통계량(statistic)은 해당 확률 변수에 대한 결정론적 함수(deterministic function)이다. 분포의 요약 통계량(summary statistics)은 확률 변수가 어떻게 행동하는지에 대한 하나의 유용한 관점을 제공하며, 이름에서 알 수 있듯이 분포를 요약하고 특징짓는 숫자들을 제공한다. 우리는 잘 알려진 두 가지 요약 통계량인 평균(mean)과 분산(variance)에 대해 설명한다. 그런 다음 두 확률 변수 쌍을 비교하는 두 가지 방법에 대해 논의한다. 첫째, 두 확률 변수가 독립(independent)이라고 말하는 방법, 둘째, 그들 사이의 내적(inner product)을 계산하는 방법이다.
6.4.1 Means and Covariances
평균과 공분산
평균(mean)과 (공)분산((co)variance)은 확률 분포의 성질(기댓값과 퍼짐 정도)을 묘사하는 데 종종 유용하다. 우리는 6.6절에서 확률 변수의 통계량들이 모든 가능한 정보를 포착하는 유용한 분포족(지수족, exponential family)이 있음을 보게 될 것이다.
$\quad$ 기댓값(expected value)의 개념은 머신러닝에서 중심적이며, 확률 자체의 근본적인 개념들도 기댓값으로부터 도출될 수 있다 (Whittle, 2000).
정의 6.3 (기댓값, Expected Value). 일변량 연속 확률 변수 $X \sim p(x)$ 에 대한 함수 $g : \mathbb{R} \to \mathbb{R}$ 의 기댓값은 다음과 같이 주어진다.
이와 유사하게, 이산 확률 변수 $X \sim p(x)$ 에 대한 함수 $g$ 의 기댓값은 다음과 같이 주어진다.
여기서 $\mathcal{X}$ 는 확률 변수 $X$ 의 가능한 결과들의 집합(목표 공간)이다.
$\quad$ 이 절에서 우리는 이산 확률 변수들이 수치적(numerical) 결과들을 가진다고 고려한다. 이는 함수 $g$ 가 실수를 입력으로 취한다는 것을 관찰함으로써 알 수 있다( $\to$ 함수 $g$ 는 어떤 비정형 데이터이든 수치적으로 변환해야함을 말한다.).
$\to$ 확률 변수에 대한 함수의 기댓값은 종종 무의식적인 통계학자의 법칙(law of the unconscious statistician)이라고 불린다 (Casella and Berger, 2002, Section 2.2).
주목 (Remark). 우리는 다변량 확률 변수 $X$ 를 일변량 확률 변수들의 유한한 벡터 $[X_1, \dots, X_D]^\top$ 로 간주한다. 다변량 확률 변수에 대하여, 우리는 기댓값을 원소별(element wise)로 정의한다.
여기서 아래첨자 $\mathbb{E}_{X_d}$ 는 우리가 벡터 $\boldsymbol{x}$ 의 $d$ 번째 원소에 대하여 기댓값을 취하고 있음을 나타낸다.
$\to$ 다변량 확률 변수에 대한 기대값 연산에서 관심 대상인 변수 $X_i$ 와 관련 없는 나머지 모든 변수들( $x_{\setminus i}$ )에 대한 적분을 먼저 수행하면, 오직 $X_i$ 단 하나에 대한 주변 확률 밀도 함수인 $p(x_i)$ 만 남게 된다.
즉, 원소별로 기댓값을 정의한다는 것은 다차원 공간의 복잡한 결합 확률을 한 번에 다룰 필요 없이, 각 차원 축으로 투영시켜 얻은 1차원 주변 분포들만으로 각각의 평균을 따로 구해도 동일한 결과를 얻음을 의미한다.
$\to$ 기댓값을 선형 결합으로 보았을 떄, 선형 대수학의 내적 공간으로 확장하여 해석할 수 있다. 확률변수 $X$ 가 가질 수 있는 값들을 하나의 열벡터 $\mathbf{x}$ 로 정의하고, 각 값이 나타날 확률을 확률벡터 $\mathbf{p}$ 로 정의해보자.
이때 기댓값 $E[X]$ 는 두 벡터의 내적으로 치환된다.
이는 기댓값이 데이터 공간과 확률 공간 사이의 기하학적 투영 관계임을 의미한다.
또한 이 선형 결합에서 계수(여기서는 확률 $p_i$ )의 합이 1이고 모두 양수( $p_i \ge 0$ )이므로 이 특수한 선형 결합을 볼록 결합(convex combination)이라 한다. 볼록 결합의 기하학적 성질에 의해, 이 결합의 결과는 반드시 볼록 폐포(convex hull) 내부에 존재해야 한다. 가령, 공정한 주사위를 한 번 던지는 실험에서 각 사건 $\set{1, 2, 3, 4, 5, 6}$ 의 선형 결합(볼록 결합, 각 사건들이 일어나는 사건들의 가중합) 결과는 1과 6을 양 끝점으로 하는 1차원 선분(볼록 폐포) 내부의 반드시 존재한다. 전체 상태 공간 자체가 볼록 집합이라는 것이 아니라, 전체 상태 공간의 이산적인 점들을 모두 포함하는 가장 작은 연속적 볼록 집합(볼록 폐포)을 만들었을 때, 기댓값은 반드시 그 폐포 내부에 속한다.
$\quad$ 정의 6.3은 표기법 $\mathbb{E}_X$ 의 의미를 확률 밀도에 대한 적분(연속 분포의 경우) 또는 모든 상태에 대한 합(이산 분포의 경우)을 취해야 함을 나타내는 연산자(operator)로 정의한다. 평균(mean)의 정의(정의 6.4)는 $g$ 를 항등 함수(identity function, $g(x)=x$ )로 선택하여 얻어지는 기댓값의 특별한 경우이다.
정의 6.4 (평균, Mean). 상태 $\boldsymbol{x} \in \mathbb{R}^D$ 를 가지는 확률 변수 $X$ 의 평균은 기댓값(average)이며 다음과 같이 정의된다.
여기서 $d = 1, \dots, D$ 에 대하여,
이며, 아래첨자 $d$ 는 $\boldsymbol{x}$ 의 대응하는 차원(dimension)을 나타낸다. 적분과 합산은 확률 변수 $X$ 의 목표 공간의 상태 $\mathcal{X}$ 에 대해 이루어진다.
$\to$ $D$ 차원 확률 변수 벡터 $\boldsymbol{X}$ 의 평균을 구하기 위해 다차원 결합 확률 분포를 직접 다룰 필요 없이, 각 차원 축 $d$ 로 투영시켜 얻은 1차원 주변 확률 분포 $p(x_d)$ 를 사용하여 각각의 스칼라 평균 $\mathbb{E}_{X_d}[x_d]$ 를 구하고, 이를 단순히 열벡터로 쌓아 올리면 된다.
$\quad$ 1차원에서는 “평균(average)”에 대한 다른 두 가지 직관적인 개념이 존재하는데, 바로 중앙값(median)과 최빈값(mode)이다. 중앙값은 우리가 값들을 정렬했을 때의 “중간(middle)” 값이다. 즉, 값들의 $50\%$ 는 중앙값보다 크고, $50\%$ 는 중앙값보다 작다. 이 아이디어는 누적 분포 함수(cdf, 정의 6.2)가 $0.5$ 가 되는 값을 고려함으로써 연속적인 값으로 일반화될 수 있다. 비대칭적이거나 긴 꼬리(long tails)를 가지는 분포의 경우, 중앙값은 평균(mean)보다 인간의 직관에 더 가까운 전형적인 값의 추정치를 제공한다. 게다가 중앙값은 평균보다 이상치(outliers)에 대해 더 강건하다(robust). 1차원 이상에서는 “정렬(sort)”할 수 있는 명백한 방법이 존재하지 않기 때문에, 중앙값을 고차원으로 일반화하는 것은 자명하지 않다(non-trivial) (Hallin et al., 2010; Kong and Mizera, 2012).
최빈값은 가장 빈번하게 발생하는 값이다. 이산 확률 변수의 경우, 최빈값은 가장 높은 발생 빈도를 가지는 $x$ 의 값으로 정의된다. 연속 확률 변수의 경우, 최빈값은 밀도 $p(\boldsymbol{x})$ 의 피크(peak)로 정의된다. 특정 밀도 $p(\boldsymbol{x})$ 는 하나 이상의 최빈값을 가질 수 있으며, 더 나아가 고차원 분포에서는 매우 많은 수의 최빈값이 존재할 수 있다. 따라서 분포의 모든 최빈값을 찾는 것은 계산적으로 매우 어려울 수 있다(computationally challenging).
$\to$ 최빈값은 확률 밀도 함수 $p(\boldsymbol{x})$ 의 그래디언트가 영벡터가 되는 지점( $\nabla p(\boldsymbol{x}) = 0$ )들 중 극댓값들을 의미한다. 아래 예제 6.4처럼 함수가 쌍봉형 구조를 가질 경우, 공간상에 여러 개의 국소 최적점이 존재하며, 수백만 차원의 딥러닝 손실 함수 평면에서는 이러한 안장점과 극댓값이 매우 많기 때문에 모든 최빈값을 찾는 것은 어렵다.
예제 6.4
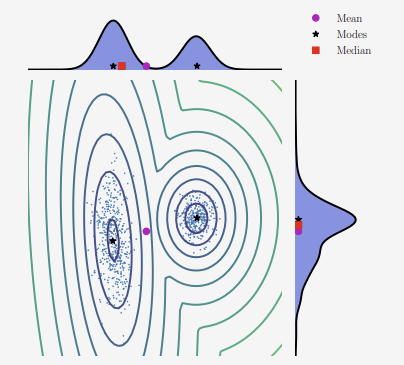
그림 6.4에 묘사된 2차원 분포를 고려해 보자.
가우시안 분포 $\mathcal{N}(\mu, \sigma^2)$ 는 6.5절에서 정의할 것이다. 각 차원에서의 대응하는 주변 분포(marginal distribution) 역시 나타나 있다. 해당 분포는 쌍봉형(bimodal, 두 개의 최빈값을 가짐)이지만, 주변 분포 중 하나는 단봉형(unimodal, 하나의 최빈값을 가짐)임을 관찰하라. 수평으로 놓인 쌍봉형 일변량 분포는 평균과 중앙값이 서로 다를 수 있음을 보여준다. 2차원 중앙값을 각 차원에서의 중앙값들의 결합(concatenation)으로 정의하고 싶은 유혹이 들지만, 2차원 점들에 대한 순서(ordering)를 정의할 수 없다는 사실이 이를 어렵게 만든다. 우리가 “순서를 정의할 수 없다”고 말하는 것은, $\begin{bmatrix} 3 \ 0 \end{bmatrix} < \begin{bmatrix} 2 \ 3 \end{bmatrix}$ 이 성립하도록 관계 $<$ 를 정의하는 방법이 한 가지 이상 존재한다는 것을 의미한다.
$\to$ 두 확률 밀도 함수(가우시안, $\mathcal{N}$ )를 더했을 때 전체 적분값이 $1$ 이 되기 위해 가중치들의 총합( $0.4+0.6$ )이 $1$ 이 되어야 한다. $\begin{bmatrix} 10 \ 2 \end{bmatrix}$ , $\begin{bmatrix} 0 \ 0 \end{bmatrix}$ 은 각 분포의 평균 벡터이며, $\begin{bmatrix} 1 & 0 \ 0 & 1 \end{bmatrix}$ , $\begin{bmatrix} 8.4 & 2.0 \ 2.0 & 1.7 \end{bmatrix}$ 은 각 분포의 공분산 행렬이다.
$\to$ 고차원에서의 중앙값은 1차원 중앙값처럼 완벽하게 해석학적, 기하학적 특성을 모두 보존하는 유일한 공식이 존재하지 않는다. 따라서 목적에 따라 각 차원별 중앙값을 구하거나 유클리드 거리의 합을 최소화하기도 한다.
주목 (Remark). 기댓값(정의 6.3)은 선형 연산자(linear operator)이다. 예를 들어, 실숫값 함수 $f(\boldsymbol{x}) = a g(\boldsymbol{x}) + b h(\boldsymbol{x})$ (단, $a, b \in \mathbb{R}$ 이고 $\boldsymbol{x} \in \mathbb{R}^D$ )가 주어졌을 때, 우리는 다음을 얻는다.
$\quad$ 두 확률 변수에 대하여, 우리는 서로에 대한 대응 관계(correspondence)를 특징짓고 싶을 수 있다. 공분산(covariance)은 직관적으로 확률 변수들이 서로 얼마나 종속적(dependent)인지에 대한 개념을 나타낸다.
정의 6.5 (공분산 (일변량), Covariance (Univariate)). 두 일변량 확률 변수 $X, Y \in \mathbb{R}$ 사이의 공분산(covariance)은 각각의 평균으로부터 떨어진 편차(deviation)들의 곱에 대한 기댓값으로 주어지며, 다음과 같다.
$\to$ 식 (6.35) $\mathbb{E}[(x - \mu_x)(y - \mu_y)]$ 는 데이터 $X$ 와 $Y$ 가 각각 자신의 평균( $\mu$ )으로부터 얼마나 떨어져 있는지를 곱한 것이다.
주목 (Remark). 기댓값이나 공분산과 연관된 확률 변수가 그 인자(arguments)를 통해 명확할 때, 아래첨자는 종종 생략된다 (예를 들어, $\mathbb{E}_X[x]$ 는 종종 $\mathbb{E}[x]$ 로 쓰인다).
$\quad$ 기댓값의 선형성(linearity of expectations)을 사용함으로써, 정의 6.5의 수식은 곱의 기댓값에서 기댓값들의 곱을 뺀 것으로 다시 쓸 수 있으며, 다음과 같다.
$\to$ 식 (6.35)의 유도 과정을 따라가 보자. 식 (6.35)에서 기댓값 연산자 $\mathbb{E}$ 내부의 괄호를 분배 법칙을 사용하여 전개하면 다음과 같다.
이를 원래 식에 대입한다.
기댓값 연산자가 덧셈과 뺄셈에 대해 찢어질 수 있는 선형 연산자이므로 다음이 성립한다.
이때 $x$ 나 $y$ 자체는 무작위성을 가지는 확률 변수이지만, 그 변수들의 전체 공간을 적분하여 얻어낸 ‘기댓값’ $\mathbb{E}[x]$ 와 $\mathbb{E}[y]$ 는 무작위성이 없어진 스칼라(상수)이다. 상수는 기댓값 연산자 $\mathbb{E}$ 의 영향을 받지 않고 그대로 밖으로 빠져나올 수 있다. 따라서 다음과 같이 식을 정리할 수 있다.
변수 자기 자신과의 공분산 $\text{Cov}[x, x]$ 는 분산(variance)이라고 불리며 $\mathbb{V}_X[x]$ 로 표기된다. 분산의 제곱근(square root)은 표준편차(standard deviation)라고 불리며 종종 $\sigma(x)$ 로 표기된다. 공분산의 개념은 다변량 확률 변수로 일반화될 수 있다.
정의 6.6 (공분산 (다변량), Covariance (Multivariate)). 우리가 각각 상태 $\boldsymbol{x} \in \mathbb{R}^D$ 와 $\boldsymbol{y} \in \mathbb{R}^E$ 를 가지는 두 다변량 확률 변수 $X$ 와 $Y$ 를 고려한다면, $X$ 와 $Y$ 사이의 공분산은 다음과 같이 정의된다.
$\to$ 두 다변량 확률 변수(랜덤 벡터) $X$ 와 $Y$ 가 통계적으로 독립이라면, 이들의 결합 확률 분포 $p(\boldsymbol{x}, \boldsymbol{y})$ 가 각각의 주변 확률 분포의 단순한 곱으로 쪼개질 수 있다.
이는 변수 $\boldsymbol{x}$ 의 값이 무엇으로 정해지든 간에, 그것이 변수 $\boldsymbol{y}$ 가 생성되는 확률적 위상 공간에 어떠한 수학적 영향(조건부 확률의 변화)도 미치지 못함을 의미한다. 확률 밀도 함수가 곱으로 쪼개진다는 것은, 기댓값 연산자 $\mathbb{E}$ 또한 분해될 수 있다.
$X$ 와 $Y$ 가 독립일 때, 두 벡터의 외적(Outer product)에 대한 기댓값은 각각의 기댓값의 외적은 다음과 같이 분리된다.
이를 식 (6.37)에 대입하면
의 결과는 모든 원소가 $0$ 인 $D \times E$ 차원의 영행렬이 된다.
즉, 두 벡터 공간 사이에 어떠한 선형적인 얽힘이 없다는 것이다.
$\quad$ 정의 6.6은 두 인자 모두에 동일한 다변량 확률 변수를 넣어 적용될 수 있으며, 이는 확률 변수의 “퍼짐 정도(spread)”를 직관적으로 포착하는 유용한 개념을 낳는다. 다변량 확률 변수의 경우, 분산은 확률 변수의 개별 차원들 사이의 관계를 설명한다.
정의 6.7 (분산, Variance). 상태 $\boldsymbol{x} \in \mathbb{R}^D$ 와 평균 벡터 $\boldsymbol{\mu} \in \mathbb{R}^D$ 를 가지는 확률 변수 $X$ 의 분산은 다음과 같이 정의된다.
$\quad$ (6.38c)의 $D \times D$ 행렬은 다변량 확률 변수 $X$ 의 공분산 행렬(covariance matrix)이라고 불린다. 공분산 행렬은 대칭 행렬(symmetric)이며 양의 준정부호(positive semidefinite)이고 데이터의 퍼짐(spread)에 대한 어떤 정보를 우리에게 알려준다. 공분산 행렬의 주대각선에는 주변 분포(marginals)의 분산들이 포함되어 있다.
여기서 “ $\setminus i$ “는 “ $i$ 를 제외한 모든 변수”를 나타낸다. 비대각선 성분들은 $i, j = 1, \dots, D$ 이고 $i \neq j$ 일 때 교차 공분산(cross-covariance) 항 $\text{Cov}[x_i, x_j]$ 이다.
주목 (Remark). 이 책에서 우리는 더 나은 직관을 위해 일반적으로 공분산 행렬이 양의 정부호(positive definite)라고 가정한다. 따라서 우리는 양의 준정부호(낮은 계수, low-rank) 공분산 행렬을 초래하는 극단적인 사례(corner cases)는 논의하지 않는다.
$\to$ 양의 정부호와 양의 준정부호를 나누는 기주는 등호의 포함 여부이다. 모든 영이 아닌 벡터 $\boldsymbol{v}$ 에 대해 $\boldsymbol{v}^\top \boldsymbol{\Sigma} \boldsymbol{v} > 0$ 이면 $\boldsymbol{\Sigma}$ 를 양의 정부호 행렬이라 하고, 모든 영이 아닌 벡터 $\boldsymbol{v}$ 에 대해 $\boldsymbol{v}^\top \boldsymbol{\Sigma} \boldsymbol{v} \ge 0$ 이면 $\boldsymbol{\Sigma}$ 를 양의 준정부호 행렬이라 한다. 양의 준정부호 행렬은 $\boldsymbol{v}^\top \boldsymbol{\Sigma} \boldsymbol{v} = 0$ 이 되는 특정한 방향 $\boldsymbol{v}$ 가 최소 하나 이상 존재한다는 것을 의미하는데, 이는 그 축 방향으로 투영된 데이터의 분산이 0이라는 것이다. 따라서 양의 준정부호 행렬인 $\boldsymbol{\Sigma}$ 는 역행렬이 존재하지 않고, 행렬식 $\vert \boldsymbol{\Sigma}\vert$ 이 0이다. 이는 다변량 가우시안 분포를 계산할 때 분모가 0이 되어 확률 밀도 값이 무한대로 폭발한다.
만약 실제 데이터가 PSD라면, 차원 축소를 하여 해당 차원을 없앤 후 확률 모델을 유도해야 한다.
$\quad$ 우리가 서로 다른 확률 변수 쌍들 사이의 공분산을 비교하고자 할 때, 각 확률 변수의 분산이 공분산의 값에 영향을 미친다는 것이 밝혀졌다. 공분산의 정규화된(normalized) 버전을 상관관계(correlation)라고 부른다.
정의 6.8 (상관관계, Correlation). 두 확률 변수 $X, Y$ 사이의 상관관계는 다음과 같이 주어진다.
$\quad$ 상관 행렬(correlation matrix)은 표준화된 확률 변수들 $x/\sigma(x)$ 의 공분산 행렬이다. 다시 말해, 상관 행렬에서 각 확률 변수는 자신의 표준편차(분산의 제곱근)로 나뉜다.
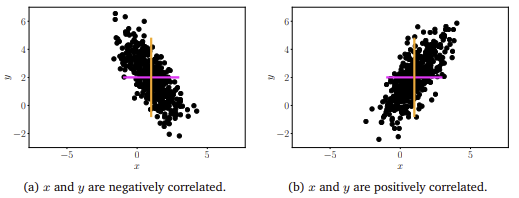
$\quad$ 공분산(그리고 상관관계)은 두 확률 변수가 어떻게 연관되어 있는지를 나타낸다 (그림 6.5 참조). 양의 상관관계 $\text{corr}[x, y]$ 는 $x$ 가 커질 때 $y$ 역시 커질 것으로 기대된다는 것을 의미한다. 음의 상관관계는 $x$ 가 증가함에 따라 $y$ 가 감소함을 의미한다.
공분산으로써 두 변수의 관계(방향성)는 파악할 수 있지만, 공분산의 절댓값 크기는 두 변수 사이의 실제 연관성 강도를 대변하지 않는다. ‘분산’이라함은 편차 제곱의 합이고, 표준편차는 분산의 제곱근인데, 실제 데이터의 단위와 ‘(공)분산’의 단위는 다르다. 때문에 (공)분산을 실제 데이터에 대입해서 해석하려면 표준편차로 나눠 단위를 맞춰야 비로소 옳은 해석을 할 수 있다. 가령 남성의 평균키가 173cm이고, 표준편차가 7cm라고 한다면, 분산은 49cm로 쓰는게 아닌 그냥 49로 해석해야 한다.
6.4.2 Empirical Means and Covariances
경험적 평균과 공분산
6.4.1절의 정의들은 종종 모평균(population mean) 및 모공분산(population covariance)이라고 불리는데, 이는 모집단에 대한 진정한(true) 통계량을 지칭하기 때문이다. 머신러닝에서 우리는 데이터의 경험적 관측(empirical observations)으로부터 학습해야 한다. 확률 변수 $X$ 를 고려해 보자. 모수 통계량에서 경험적 통계량의 실현(realization)으로 넘어가기 위한 두 가지 개념적 단계가 있다. 첫째, 우리는 유한한 개수의 동일한 확률 변수들 $X_1, \dots, X_N$ 의 함수인 경험적 통계량을 구성하기 위해 유한한 데이터셋(크기 $N$ )을 가지고 있다는 사실을 사용한다. 둘째, 우리는 데이터를 관측한다. 즉, 각 확률 변수의 실현값 $x_1, \dots, x_N$ 을 보고 경험적 통계량을 적용한다.
$\quad$ 구체적으로, 평균(정의 6.4)의 경우, 특정 데이터셋이 주어지면 우리는 평균의 추정치(estimate)를 얻을 수 있으며, 이를 경험적 평균(empirical mean) 또는 표본 평균(sample mean)이라고 부른다. 동일한 논리가 경험적 공분산에도 적용된다.
정의 6.9 (경험적 평균과 공분산, Empirical Mean and Covariance). 경험적 평균 벡터는 각 변수에 대한 관측치들의 산술 평균(arithmetic average)이며 다음과 같이 정의된다.
여기서 $\boldsymbol{x}_n \in \mathbb{R}^D$ 이다.
$\quad$ 경험적 평균과 유사하게, 경험적 공분산 행렬은 $D \times D$ 행렬이다.
$\quad$ 특정 데이터셋에 대한 통계량을 계산하기 위해, 우리는 실현값(관측치) $x_1, \dots, x_N$ 을 사용하고 식 (6.41)과 (6.42)를 사용할 것이다. 경험적 공분산 행렬은 대칭 행렬(symmetric)이며 양의 준정부호(positive semidefinite)이다 (3.2.3절 참조).
$\to$ 이 책 전반에 걸쳐 우리는 편향된 추정치(biased estimate)인 경험적 공분산을 사용한다. 편향이 없는(unbiased, 때로는 보정된(corrected)이라고 불리는) 공분산은 분모에 $N$ 대신 $N - 1$ 이라는 인자(factor)를 가진다. 유도 과정은 이 장 끝의 연습 문제에 있다.
6.4.3 Three Expressions for the Variance
분산에 대한 세 가지 표현
우리는 이제 단일 확률 변수 $X$ 에 초점을 맞추고, 앞서 다룬 경험적 공식들을 사용하여 분산에 대해 가능한 세 가지 표현식을 유도한다. 적분을 처리해야 한다는 점만 제외하면, 이어지는 유도 과정은 모분산(population variance)에 대해서도 동일하다. 공분산의 정의(정의 6.5)에 대응하는 분산의 표준 정의는 확률 변수 $X$ 가 자신의 기댓값 $\mu$ 로부터 떨어진 편차의 제곱에 대한 기댓값이다. 즉,
식 (6.43)의 기댓값과 평균 $\mu = \mathbb{E}_X(x)$ 는 $X$ 가 이산 확률 변수인지 연속 확률 변수인지에 따라 식 (6.32)를 사용하여 계산된다. 식 (6.43)에 표현된 분산은 새로운 확률 변수 $Z := (X - \mu)^2$ 의 평균이다.
$\quad$ 식 (6.43)의 분산을 경험적으로 추정할 때, 우리는 2-패스 알고리즘(two-pass algorithm)에 의존해야 한다. 즉, 식 (6.41)을 사용하여 평균 $\mu$ 를 계산하기 위해 데이터를 한 번 순회(pass)하고, 이 추정치 $\hat{\mu}$ 를 사용하여 분산을 계산하기 위해 두 번째 순회를 거쳐야 한다. 항들을 재배열함으로써 이 두 번의 순회를 피할 수 있음이 밝혀졌다. 식 (6.43)의 공식은 이른바 분산의 원점수(raw-score) 공식으로 변환될 수 있다.
식 (6.44)의 표현식은 “제곱의 평균 빼기 평균의 제곱”으로 기억될 수 있다. 이 방식은 데이터의 $i$ 번째 관측치인 $x_i$ 에 대해 $x_i$ (평균을 계산하기 위해)와 $x_i^2$ 을 동시에 누적할 수 있으므로, 데이터를 단 한 번만 순회(one pass)하여 경험적으로 계산될 수 있다. 불행히도, 이 방식으로 구현될 경우 수치적으로 불안정(numerically unstable)할 수 있다. 분산의 원점수 버전은 머신러닝에서 편향-분산 분해(bias-variance decomposition)를 유도할 때 유용할 수 있다 (Bishop, 2006).
$\to$ 만약 식 (6.44)의 두 항이 매우 크고 서로 대략적으로 같다면, 우리는 부동소수점 연산(floating-point arithmetic)에서 불필요한 수치적 정밀도의 손실을 겪을 수 있다.
$\quad$ 분산을 이해하는 세 번째 방법은 그것이 모든 관측치 쌍들 사이의 쌍대 차이(pairwise differences)의 합이라고 보는 것이다. 확률 변수 $X$ 의 실현값들의 표본 $x_1, \dots, x_N$ 을 고려하고, $x_i$ 와 $x_j$ 쌍 사이의 제곱된 차이를 계산해 보자. 제곱을 전개함으로써, 우리는 $N^2$ 개의 쌍대 차이들의 합이 관측치들의 경험적 분산이 됨을 보일 수 있다.
우리는 식 (6.45)가 원점수 표현식 (6.44)의 두 배임을 알 수 있다. 이는 우리가 쌍대 거리의 합(이것들은 $N^2$ 개가 존재한다)을 평균으로부터의 편차들의 합(이것들은 $N$ 개가 존재한다)으로 표현할 수 있음을 의미한다. 기하학적으로, 이는 쌍대 거리들과 점 집합의 중심으로부터의 거리들 사이에 동치(equivalence)가 존재함을 의미한다. 계산적 관점에서는, 평균을 계산하고(합산에서 $N$ 개의 항) 그다음 분산을 계산함으로써(다시 합산에서 $N$ 개의 항), $N^2$ 개의 항을 가지는 표현식(식 (6.45)의 좌변)을 얻을 수 있음을 의미한다.
$\to$ 식 (6.45)에서 $\frac{1}{N^2}$ 을 제외한 좌변을 다음과 같이 전개하여 유도할 수 있다.
여기서 첫 번째 항의 $x_i^2$ 은 $j$ 와 무관하므로 $N$ 번 더해지며, 세 번째 항 역시 $i$ 와 무관하므로 $N$ 번 더해진다. 두 번째 항은 $i$ 와 $j$ 의 합산을 분리할 수 있다.
이때 첫 번째 항과 세 번째 항은 동일하며, 두 번째 항의 괄호 두 개 역시 동일하다.
원래 식의 좌변에 있던 $\frac{1}{N^2}$ 로 나누면
이는 원점수 표현식의 2배이다.
기하학적으로 100개의 점이 있을 때, 중심(평균)을 구해서 100개 거리를 재는 것과, 100개 점들끼리 모든 짝을 지어 10,000(N^2)의 쌍대 거리를 재는 것은 동일한 ‘퍼짐’의 척도이다. 연산 복잡도의 관점에서 $\mathcal{O}(N^2)$ 의 시간이 걸리는 쌍대 거리를 계산하지 않고, $\mathcal{O}(N)$ 만에 끝나는 평균과 분산을 구하는게 이득임을 알 수 있다.
6.4.4 Sums and Transformations of Random Variables
확률 변수의 합과 변환
우리는 교과서적인 분포들(6.5절과 6.6절에서 일부를 소개할 것이다)로는 잘 설명되지 않는 현상을 모델링하고 싶을 수 있으며, 따라서 확률 변수들에 대한 간단한 조작(예를 들어, 두 확률 변수의 덧셈)을 수행할 수 있다.
$\quad$ 상태 $\boldsymbol{x}, \boldsymbol{y} \in \mathbb{R}^D$ 를 가지는 두 확률 변수 $X, Y$ 를 고려해 보자. 그러면 다음이 성립한다.
$\quad$ 평균과 (공)분산은 확률 변수의 아핀 변환(affine transformation)에 관하여 몇 가지 유용한 성질들을 보여준다. 평균이 $\boldsymbol{\mu}$ 이고 공분산 행렬이 $\boldsymbol{\Sigma}$ 인 확률 변수 $X$ 와, $\boldsymbol{x}$ 에 대한 (결정론적) 아핀 변환 $\boldsymbol{y} = \boldsymbol{A}\boldsymbol{x} + \boldsymbol{b}$ 를 고려해 보자. 그러면 $\boldsymbol{y}$ 그 자체로 확률 변수가 되며, 그것의 평균 벡터와 공분산 행렬은 각각 다음과 같이 주어진다.
더 나아가,
여기서 $\boldsymbol{\Sigma} = \mathbb{E}[\boldsymbol{x}\boldsymbol{x}^\top] - \boldsymbol{\mu}\boldsymbol{\mu}^\top$ 는 $X$ 의 공분산(행렬)이다.
$\to$ 위 식들의 증명은 다른 문서에 기술하였다.
6.4.5 Statistical Independence
통계적 독립
정의 6.10 (독립, Independence). 두 확률 변수 $X, Y$ 가 다음을 만족할 때, 그리고 오직 그때만 두 확률 변수는 통계적으로 독립(statistically independent)이다.
$\quad$ 직관적으로, 만약 $\boldsymbol{y}$ 의 값(일단 알려졌을 때)이 $\boldsymbol{x}$ 에 대한 어떠한 추가적인 정보도 제공하지 않는다면(그 역도 마찬가지), 두 확률 변수 $X$ 와 $Y$ 는 독립이다. 만약 $X, Y$ 가 (통계적으로) 독립이라면, 다음이 성립한다.
- $p(\boldsymbol{y} \mid \boldsymbol{x}) = p(\boldsymbol{y})$
- $p(\boldsymbol{x} \mid \boldsymbol{y}) = p(\boldsymbol{x})$
- $\mathbb{V}_{X,Y}[\boldsymbol{x} + \boldsymbol{y}] = \mathbb{V}_X[\boldsymbol{x}] + \mathbb{V}_Y[\boldsymbol{y}]$
- $\text{Cov}_{X,Y}[\boldsymbol{x}, \boldsymbol{y}] = \boldsymbol{0}$
마지막 항목의 역은 성립하지 않을 수 있다. 즉, 두 확률 변수의 공분산이 영(zero)이더라도 통계적으로 독립이 아닐 수 있다. 그 이유를 이해하기 위해, 공분산은 오직 선형적 종속성(linear dependence)만을 측정한다는 사실을 상기하라. 따라서 비선형적으로 종속된(nonlinearly dependent) 확률 변수들은 공분산이 영이 될 수 있다.
$\to$ 통계학에서 공분산이 0이면 두 변수가 무상관(Uncorrelated)이라고 부른다. 이를 선형대수학에서 선형 종속(두 변수 사이에 선형적인 관계가 있음)임을 의미한다.
또한 통계적 독립은 두 변수간에 선형적인 관계와 비선형적인 관계 모두 없는 경우이지만 무상관(공분산이 0)인 경우는 두 변수간의 비선형 관계는 있을 수 있다.
예제 6.5
평균이 영( $\mathbb{E}_X[x] = 0$ )이고 또한 $\mathbb{E}_X[x^3] = 0$ 인 확률 변수 $X$ 를 고려해 보자. $y = x^2$ 이라고 두고(따라서 $Y$ 는 $X$ 에 종속적이다) $X$ 와 $Y$ 사이의 공분산 (6.36)을 고려해 보자. 이는 다음을 부여한다.
$\quad$ 머신러닝에서 우리는 종종 독립 항등 분포(independent and identically distributed, i.i.d.)인 확률 변수들 $X_1, \dots, X_N$ 으로 모델링될 수 있는 문제들을 고려한다. 두 개 이상의 확률 변수들에 대하여, “독립(independent)”이라는 단어(정의 6.10)는 보통 모든 부분 집합(subsets)이 독립인 상호 독립적(mutually independent) 확률 변수들을 지칭한다. “항등 분포(identically distributed)”라는 구절은 모든 확률 변수들이 동일한 분포에서 왔음을 의미한다.
$\quad$ 머신러닝에서 중요한 또 다른 개념은 조건부 독립(conditional independence)이다.
정의 6.11 (조건부 독립, Conditional Independence). $Z$ 가 주어졌을 때(given $Z$ ), 두 확률 변수 $X$ 와 $Y$ 가 다음을 만족할 때 그리고 오직 그때만 조건부 독립(conditionally independent)이다.
여기서 $\mathcal{Z}$ 는 확률 변수 $Z$ 의 상태들의 집합이다. 우리는 $X$ 가 $Z$ 가 주어졌을 때 $Y$ 와 조건부 독립이라는 것을 나타내기 위해 $X \perp!!!\perp Y \mid Z$ 로 적는다.
$\quad$ 정의 6.11은 (6.55)의 관계가 $\boldsymbol{z}$ 의 모든 값에 대해 참으로 성립해야 함을 요구한다. (6.55)의 해석은 “ $\boldsymbol{z}$ 에 대한 지식이 주어졌을 때, $\boldsymbol{x}$ 와 $\boldsymbol{y}$ 의 분포는 인수분해(factorize)된다”로 이해될 수 있다. 만약 우리가 $X \perp!!!\perp Y \mid \emptyset$ 로 적는다면, 독립은 조건부 독립의 특별한 경우로 캐스팅될 수 있다. 확률의 곱의 법칙(6.22)을 사용함으로써, 우리는 (6.55)의 좌변을 전개하여 다음을 얻을 수 있다.
(6.55)의 우변과 (6.56)을 비교함으로써, 우리는 $p(\boldsymbol{y} \mid \boldsymbol{z})$ 가 양쪽 모두에 나타남을 알 수 있으며 따라서 다음이 성립한다.
식 (6.57)은 조건부 독립, 즉 $X \perp!!!\perp Y \mid Z$ 에 대한 대안적인 정의를 제공한다. 이 대안적인 제시는 “우리가 $\boldsymbol{z}$ 를 알고 있다는 조건하에, $\boldsymbol{y}$ 에 대한 지식은 $\boldsymbol{x}$ 에 대한 우리의 지식을 바꾸지 않는다”라는 해석을 제공한다.
$\to$ 이는 은닉 마르코프 모델(HMM)에서 미래( $\boldsymbol{x}$ )는 오직 현재( $\boldsymbol{z}$ )에만 의존하며, 과거( $\boldsymbol{y}$ )와는 단절된다. 이를 조건부 확률로 쓰면 위와 같다.
즉, 현재 $z$ 를 알고 있다면, 과거 $y$ 가 무엇이었든 간에 미래 $x$ 를 예측하는데 아무런 추가 정보도 주지 않는다는 것이다.
여기서 현재 $z$ 는 과거 $y$ 로부터 파생되었으니 $p(z \mid y)$ 가 수식 어딘가 있어야 할법한데, 이는 다음과 같이 유도할 수 있다.
모든 시점에서의 결합 확률은 다음과 같다.
우리가 구하고 싶은건 현재 $z$ 가 고정되었을 때(주어졌을 때), 과거와 미래의 결합 확률인 $p(\boldsymbol{x}, \boldsymbol{y} \mid \boldsymbol{z})$ 이다.
여기에 모든 시점에서의 결합 확률을 대입하면
식을 약간 정리하면 다음과 같다.
괄호 안은 $p(\boldsymbol{y} \mid \boldsymbol{z})$ 로 치환되며, 앞서 의문이었던 전이 확률 $p(z\vert y)$ 은 사라진다.
따라서 현재( $z$ )를 관측했을 때 과거와 미래가 조건부 독립임을 알 수 있다.
6.4.6 Inner Products of Random Variables
확률 변수의 내적
3.2절에서 다룬 내적의 정의를 상기해 보자. 우리는 확률 변수들 사이의 내적(inner product)을 정의할 수 있으며, 이 절에서 이를 간략히 설명한다. 만약 우리가 두 무상관(uncorrelated) 확률 변수 $X, Y$ 를 가지고 있다면, 다음이 성립한다.
분산은 제곱된 단위로 측정되므로, 이는 직각 삼각형에 대한 피타고라스의 정리(Pythagorean theorem) $c^2 = a^2 + b^2$ 과 매우 유사해 보인다.
$\quad$ 이하에서는, (6.58)에 있는 무상관 확률 변수들의 분산 관계에 대한 기하학적 해석을 찾을 수 있는지 살펴본다.
확률 변수는 벡터 공간의 벡터로 간주될 수 있으며, 우리는 내적을 정의하여 확률 변수의 기하학적 성질들을 얻을 수 있다 (Eaton, 2007). 만약 평균이 영(zero mean)인 확률 변수 $X$ 와 $Y$ 에 대하여 다음과 같이 내적을 정의한다면,
우리는 내적을 얻게 된다. 공분산은 대칭적(symmetric)이고, 양의 정부호(positive definite)이며, 각각의 전달인자(argument)에 대해 선형적(linear)임을 알 수 있다. 확률 변수의 길이는
즉, 그것의 표준편차이다. 확률 변수가 “길수록” 그것은 더 불확실하다(분산이 크다); 그리고 길이가 $0$ 인 확률 변수는 결정론적(deterministic)이다(모든 데이터가 평균과 같아 분산이 0인 경우 이 확률 변수는 같은 값만을 가진다).
$\to$ 만약 어떤 확률 변수의 결과가 영이 아닌 결정론적이라면, 분산은 0이 된다. 이때 앞서 자기 자신과 (공)분산을 내적으로 정의하였는데, 그 결과값이 0이므로 내적으로 사용할 수 없다.
기계학습 모델(특히 PCA나 SVM 등 기하학적 모델)에 데이터를 넣기 전에, mean-centering을 하는 근본적인 이유가 데이터로 내적과 같은 연산들을 하기 위함이다.
$\quad$ 만약 우리가 두 확률 변수 $X, Y$ 사이의 각도 $\theta$ 를 살펴본다면, 다음을 얻는다.
이는 두 확률 변수 사이의 상관관계(정의 6.8)이다. 이것은 우리가 확률 변수들을 기하학적으로 고려할 때, 상관관계를 두 확률 변수 사이 각도의 코사인(cosine)으로 생각할 수 있음을 의미한다. 우리는 정의 3.7로부터 $X \perp Y \iff \langle X, Y \rangle = 0$ 임을 안다. 우리의 경우, 이는 $\text{Cov}[x, y] = 0$ 일 때, 즉 그들이 무상관(uncorrelated)일 때 그리고 오직 그때만 $X$ 와 $Y$ 가 직교(orthogonal)함을 의미한다. 그림 6.6은 이 관계를 설명한다.
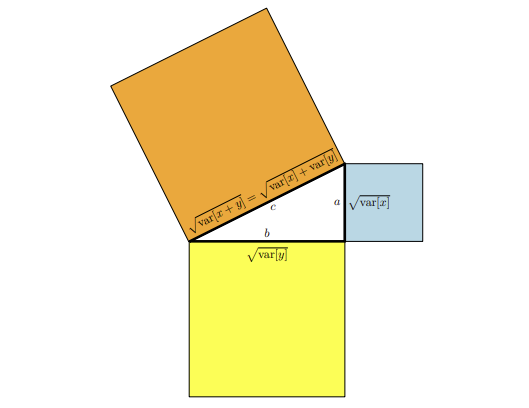
$\to$ 상관관계 $\text{corr}[x, y]$ 가 무조건 $[-1, 1]$ 사이의 폐구간에 갇히는 이유는, 그것이 본질적으로 $N$ 차원 공간에서 두 데이터 벡터가 이루는 ‘각도의 코사인값( $\cos\theta$ )’이기 때문이다.
주목 (Remark). 확률 분포들을 비교하기 위해 (앞선 내적의 정의로부터 구성된) 유클리드 거리(Euclidean distance)를 사용하는 것이 유혹적이긴 하지만, 불행히도 그것은 분포들 사이의 거리를 얻는 가장 좋은 방법이 아니다. 확률 질량(또는 밀도)은 양수이며 그 합이 1이 되어야 한다는 것을 상기하라. 이러한 제약 조건들은 분포들이 통계적 다양체(statistical manifold)라고 불리는 것 위에 존재함을 의미한다. 확률 분포들의 이 공간에 대한 연구를 정보 기하학(information geometry)이라고 부른다. 분포들 사이의 거리를 계산하는 것은 종종 쿨백-라이블러 발산(Kullback-Leibler divergence)을 사용하여 수행되는데, 이는 통계적 다양체의 성질들을 설명하는 거리들의 일반화이다. 유클리드 거리가 거리 공간(metric, 3.3절)의 특수한 경우인 것과 마찬가지로, 쿨백-라이블러 발산은 브레그만 발산(Bregman divergences) 및 $f$ -발산( $f$ -divergences)이라고 불리는 두 가지 더 일반적인 발산 클래스들의 특수한 경우이다. 발산에 대한 연구는 이 책의 범위를 벗어나며, 더 자세한 내용은 정보 기하학 분야의 창시자 중 한 명인 Amari (2016)의 최근 저서를 참조하기 바란다.