기댓값 최대화 알고리즘
불행히도, (11.20), (11.30), (11.42)의 업데이트 식들은 혼합 모델의 파라미터 $\boldsymbol{\mu}_k, \boldsymbol{\Sigma}_k, \pi_k$ 업데이트를 위한 닫힌 형태의 해(closed-form solution)를 구성하지 않는다. 왜냐하면 책임값 $r_{nk}$ 가 해당 파라미터들에 복잡한 방식으로 의존하기 때문이다. 그러나 이 결과들은 최대 우도(maximum likelihood)를 통해 파라미터 추정 문제의 해를 찾기 위한 단순한 반복 기법(iterative scheme)을 시사한다. 기댓값 최대화 알고리즘(expectation maximization algorithm, EM algorithm)은 Dempster et al. (1977)에 의해 제안되었으며, 혼합 모델 및 더 일반적으로는 잠재 변수 모델(latent-variable models)에서 파라미터(최대 우도 또는 MAP)를 학습하기 위한 일반적인 반복 기법이다.
$\quad$ 우리의 가우시안 혼합 모델 예제에서, 우리는 $\boldsymbol{\mu}_k, \boldsymbol{\Sigma}_k, \pi_k$ 의 초기값을 선택하고 다음 두 단계 사이를 수렴할 때까지 번갈아 수행한다:
- E-단계(E-step): 책임값 $r_{nk}$ (데이터 포인트 $n$ 이 혼합 성분 $k$ 에 속할 사후 확률)를 평가한다.
- M-단계(M-step): 업데이트된 책임값을 사용하여 파라미터 $\boldsymbol{\mu}_k, \boldsymbol{\Sigma}_k, \pi_k$ 를 재추정한다.
EM 알고리즘의 모든 단계는 로그 우도 함수를 증가시킨다 (Neal and Hinton, 1999). 수렴(convergence) 여부를 판단하기 위해, 우리는 로그 우도나 파라미터를 직접 확인할 수 있다. GMM의 파라미터를 추정하기 위한 EM 알고리즘의 구체적인 구현은 다음과 같다:- $\boldsymbol{\mu}_k, \boldsymbol{\Sigma}_k, \pi_k$ 를 초기화한다.
- E-단계: 현재 파라미터 $\pi_k, \boldsymbol{\mu}_k, \boldsymbol{\Sigma}_k$ 를 사용하여 모든 데이터 포인트 $\boldsymbol{x}_n$ 에 대한 책임값 $r_{nk}$ 를 평가한다:
- M-단계: (E-단계에서 구한) 현재 책임값 $r_{nk}$ 를 사용하여 파라미터 $\pi_k, \boldsymbol{\mu}_k, \boldsymbol{\Sigma}_k$ 를 재추정한다:
(11.54)에서 평균 $\boldsymbol{\mu}_k$ 를 업데이트하고 나면, 이들은 후속적으로 (11.55)에서 해당하는 공분산을 업데이트하는 데 사용된다.
예제 11.6 (GMM 적합)
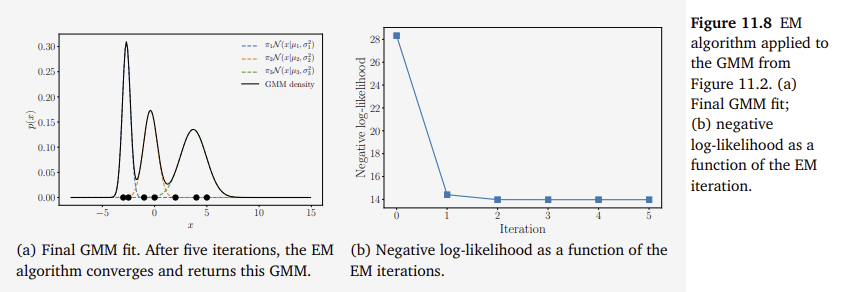
(그림 11.8): 그림 11.2의 GMM에 적용된 EM 알고리즘. (a) 최종 GMM 적합; (b) EM 반복(iteration) 횟수에 따른 음의 로그 우도(negative log-likelihood).
$\quad$ 그림 11.3의 예제에 EM을 실행하면, 5번의 반복 후에 그림 11.8(a)에 나타난 최종 결과를 얻게 되며, 그림 11.8(b)는 EM 반복 횟수에 따라 음의 로그 우도가 어떻게 전개되는지 보여준다. 최종 GMM은 다음과 같이 주어진다.
$\to$ 식 (11.57)의 각 색상에 해당하는 가우시안은 그림 11.8에 표시되어 있다.
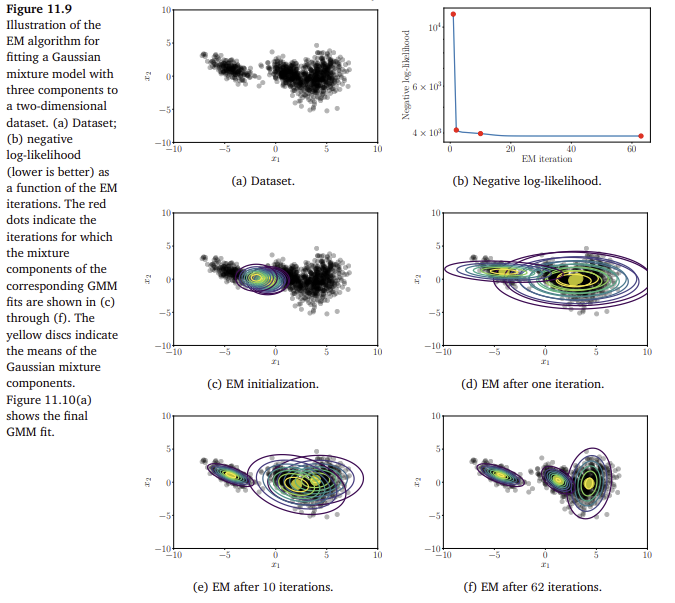
(그림 11.9): 2차원 데이터셋에 3개의 성분을 가진 가우시안 혼합 모델을 적합하기 위한 EM 알고리즘의 예시. (a) 데이터셋; (b) EM 반복 횟수에 따른 음의 로그 우도 (낮을수록 좋음). 빨간 점들은 (c)부터 (f)까지 보여지는 해당 GMM 적합의 혼합 성분들이 나타내는 반복 지점들을 가리킨다. 노란색 원반(disc)은 가우시안 혼합 성분의 평균을 나타낸다. 그림 11.10(a)는 최종 GMM 적합을 보여준다.
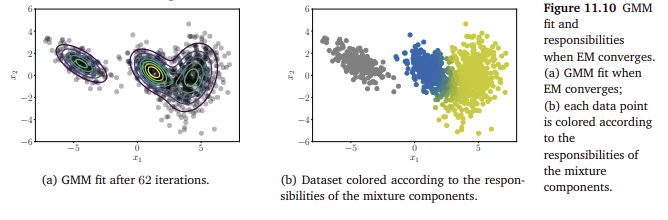
(그림 11.10): EM이 수렴했을 때의 GMM 적합과 책임값. (a) EM이 수렴했을 때의 GMM 적합; (b) 각 데이터 포인트는 혼합 성분의 책임값에 따라 색칠됨.
$\quad$ 우리는 그림 11.1에 표시된 2차원 데이터셋에 $K=3$ 개의 혼합 성분을 사용하여 EM 알고리즘을 적용했다. 그림 11.9는 EM 알고리즘의 몇 가지 단계들을 예시하며, EM 반복 횟수에 따른 음의 로그 우도를 보여준다 (그림 11.9(b)). 그림 11.10(a)는 그에 상응하는 최종 GMM 적합을 보여준다. 그림 11.10(b)는 데이터 포인트들에 대한 혼합 성분들의 최종 책임값(responsibilities)을 시각화한다. 데이터셋은 EM이 수렴했을 때 혼합 성분들의 책임값에 따라 색칠되어 있다. 왼쪽의 데이터에 대해서는 단일 혼합 성분이 명확하게 책임을 지고 있는 반면, 오른쪽의 두 데이터 군집이 겹치는 부분은 두 개의 혼합 성분에 의해 생성되었을 가능성이 있다. 단일 성분(파란색 또는 노란색)에 고유하게 할당할 수 없는 데이터 포인트들이 존재하며, 이러한 포인트들에 대한 이 두 군집의 책임값은 $0.5$ 부근이 된다는 것이 분명해진다.
아래 영상은 초기 4개의 클러스터가 데이터에 적합되는 과정을 시각화하였다.