이산 확률과 연속 확률
6.1절에서 소개한 사건의 확률을 묘사하는 방법들에 주의를 집중해 보자. 목표 공간이 이산적인지 또는 연속적인지에 따라, 분포를 지칭하는 자연스러운 방법은 다르다. 목표 공간 $\mathcal{T}$ 가 이산적일 때, 우리는 확률 변수 $X$ 가 특정 값 $x \in \mathcal{T}$ 를 가질 확률을 명시할 수 있으며, 이를 $P(X = x)$ 로 표기한다. 이산 확률 변수 $X$ 에 대한 표현식 $P(X = x)$ 는 확률 질량 함수(probability mass function)로 알려져 있다. 목표 공간 $\mathcal{T}$ 가 연속적일 때 (예를 들어, 실수선 $\mathbb{R}$ ), 확률 변수 $X$ 가 특정 구간 안에 존재할 확률을 명시하는 것이 더 자연스러우며, 이는 $a < b$ 에 대해 $P(a \le X \le b)$ 로 표기된다. 관례적으로 우리는 확률 변수 $X$ 가 특정 값 $x$ 보다 작거나 같을 확률을 명시하며, 이를 $P(X \le x)$ 로 표기한다. 연속 확률 변수 $X$ 에 대한 표현식 $P(X \le x)$ 는 누적 분포 함수(cumulative distribution function)로 알려져 있다. 우리는 연속 확률 변수에 대해 6.2.2절에서 논의할 것이다. 명명법을 다시 살펴보고 이산 확률 변수와 연속 확률 변수를 대조하는 내용은 6.2.3절에서 다룰 것이다.
주목 (Remark). 우리는 단일 확률 변수(그 상태들은 볼드체가 아닌 $x$ 로 표기됨)의 분포를 지칭하기 위해 일변량(univariate) 분포라는 구문을 사용할 것이다. 우리는 하나 이상의 확률 변수들에 대한 분포를 다변량(multivariate) 분포라고 지칭할 것이며, 대개 확률 변수들의 벡터(그 상태들은 볼드체 $\boldsymbol{x}$ 로 표기됨)를 고려할 것이다.
6.2.1 이산 확률
목표 공간이 이산적일 때, 우리는 여러 확률 변수들의 확률 분포를 숫자로 이루어진 (다차원) 배열을 채우는 것으로 상상할 수 있다.
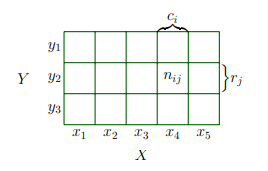
그림 6.2는 한 가지 예를 보여준다. 결합 확률(joint probability)의 목표 공간은 각 확률 변수의 목표 공간들의 데카르트 곱(Cartesian product)이다. 우리는 두 값이 동시에 발생할 결합 확률을 다음과 같이 정의한다:
여기서 $n_{ij}$ 는 상태가 $x_i$ 이고 $y_j$ 인 사건의 수이며, $N$ 은 전체 사건의 수이다. 결합 확률은 두 사건의 교집합에 대한 확률이다. 즉, $P(X = x_i, Y = y_j) = P(X = x_i \cap Y = y_j)$ 이다. 그림 6.2는 이산 확률 분포의 확률 질량 함수(probability mass function, pmf)를 시각적으로 보여준다. 두 확률 변수 $X$ 와 $Y$ 에 대해, $X = x$ 이고 $Y = y$ 일 확률은 (lazily) $p(x, y)$ 로 표기되며 이를 결합 확률이라고 부른다. 우리는 확률을 상태 $x$ 와 $y$ 를 받아 실수를 반환하는 함수로 생각할 수 있으며, 이것이 우리가 $p(x, y)$ 라고 쓰는 이유이다. 확률 변수 $Y$ 의 값과 무관하게(irrespective of) $X$ 가 $x$ 값을 가질 주변 확률(marginal probability)은 (lazily) $p(x)$ 로 표기된다. 우리는 확률 변수 $X$ 가 $p(x)$ 에 따라 분포됨을 나타내기 위해 $X \sim p(x)$ 라고 쓴다. 만약 우리가 오직 $X = x$ 인 경우들만 고려한다면, 그중에서 $Y = y$ 인 인스턴스들의 비율(조건부 확률, conditional probability)은 (lazily) $p(y\vert x)$ 로 표기된다.
$\to$ 데카르트 곱은 각 집합의 원소를 각 성분으로 하는 튜플들의 집합이다. 다시 말해, 두 집합의 원소들을 짝지어 만들 수 있는 모든 가능한 순서쌍의 집합을 의미한다. 예를 들어, 두 집합 $A, B$ 의 곱집합 $A \times B$ 는 $\set{(a,b) \vert a \in A, b \in B}$ 이다.
두 확률 변수 $X$ 와 $Y$ 의 목표 공간이 각각 $\mathcal{T}_X = \set{x_1, x_2}$ 이고 $\mathcal{T}_Y = \set{y_1, y_2, y_3}$ 라고 가정해보자. 이 두 공간의 데카르트 곱 $\mathcal{T}_X \times \mathcal{T}_Y$ 는 다음과 같이 전개된다.
“결합 확률의 목표 공간은 각 확률 변수의 목표 공간들의 데카르트 곱이다”라는 뜻은 다변수 확률 모델이 고려해야 하는 전체 표본 공간의 크기가 각 확률 변수의 목표 공간들의 모든 조합인 다차원 텐서임을 말한다.
$\to$ “변수 $Y$ 의 값과 무관하게”라는 표현은, 오직 특정 열 $X = x_3$ 의 확률만 구하고 싶을 때, 그 열에 있는 모든 $Y$ 의 확률들을 세로로 다 더하면 된다.
$\to$ “오직 $X=x$ 인 경우들만 고려한다면”이라는 문장은 확률 연산의 기준이 되는 전체 표본 공간 $\Omega$ 가 축소됨을 뜻한다. 그럼 6.2에서 $X = x_3$ 인 경우들만 고려한다면, 전체 데이터는 전체 사각형 $N$ 이 아니라, 이 $x_3$ 열 안에 있는 데이터 뿐이다. 이 열 안에서 특정 $Y = y_2$ 가 차지하는 비율을 구하는 것이 조건부 확률이다(결합 확률과 조건부 확률은 예제 6.2에서 다룬다).
$\to$ ‘lazily’는 직역하면 ‘게으른’인데 이 표현이 쓰여진 이유는 다음과 같다. 원래 특정 사건이 발생할 확률은 $P(X=x)$ 로 적어야 하며 여기서 대문자 $X$ 는 함수(확률 변수)이고 소문자 $x$ 는 대입할 숫자(상태)이다. 이를 단순 $p(x)$ 라고 적는다면 식에 $p(x)$ 와 $p(y)$ 가 등장했을 때, 같은 함수 $p$ 에 입력값만 다르게 넣은 것처럼 보인다. 하지만 실제 $X$ 의 확률 질량 함수와 $Y$ 의 확률 질량 함수는 완전히 별개의 다항식이나 룩업 테이블을 가진 다른 함수일 수 있다.
예제 6.2
그림 6.2에 나타난 바와 같이, $X$ 는 5개의 가능한 상태를 가지고 $Y$ 는 3개의 가능한 상태를 가지는 두 확률 변수 $X$ 와 $Y$ 를 고려해 보자. 상태가 $X = x_i$ 이고 $Y = y_j$ 인 사건의 수를 $n_{ij}$ 로 표기하고, 전체 사건의 수를 $N$ 으로 표기한다. 값 $c_i$ 는 $i$ 번째 열(column)에 대한 개별 빈도들의 합이다. 즉, $c_i = \sum_{j=1}^3 n_{ij}$ 이다. 유사하게, 값 $r_j$ 는 행(row)의 합이다. 즉, $r_j = \sum_{i=1}^5 n_{ij}$ 이다. 이러한 정의들을 사용하여, 우리는 $X$ 와 $Y$ 의 분포를 간결하게 표현할 수 있다.
$\quad$ 각 확률 변수의 확률 분포인 주변 확률(marginal probability)은 행 또는 열에 대한 합으로 볼 수 있다.
그리고
여기서 $c_i$ 와 $r_j$ 는 각각 확률 표의 $i$ 번째 열과 $j$ 번째 행이다. 관례적으로, 유한한 수의 사건을 가지는 이산 확률 변수에 대해 우리는 확률들의 합이 $1$ 이 된다고 가정한다. 즉,
$\quad$ 조건부 확률(conditional probability)은 특정 셀이 행 또는 열에서 차지하는 비율이다. 예를 들어, $X$ 가 주어졌을 때 $Y$ 의 조건부 확률은 다음과 같다.
그리고 $Y$ 가 주어졌을 때 $X$ 의 조건부 확률은 다음과 같다.
$\to$ 주변 확률의 덧셈 연산이 확률 변수의 영향력을 소거한다는 것이 무슨 의미인가. 결합 확률 $P(X=x, Y=y)$ 는 $X$ 와 $Y$ 의 상태가 동시에 고정된 교집합을 의미한다. 만약 우리가 오직 ‘ $X=x_i$ 일 확률’만을 묻는다면, 변수 $Y$ 는 $y_1$ 이 되든 $y_2$ 가 되든 $y_3$ 이 되든 전혀 상관이 없기 때문에, 이는 ‘서로 배반인 사건들의 합집합’으로 정의되며 교집합이 없는 배반 사건들의 합집합 확률은 단순 덧셈으로 전개된다.
때문에 최종 결과 값에는 확률 변수 $Y$ 의 영향력이 소거된다. 이는 변수 $X$ 와 $Y$ 의 상관관계를 다룬게 아닌 우리가 관찰하고자 하는 관심 대상에서 $Y$ 의 구체적인 상태를 배제한다는 뜻이다.
$\to$ 특정 조건 $X=x_i$ 가 주어졌을 때, 모든 가능한 $Y$ 에 대한 조건부 확률을 더해보자.
여기서 앞서 정의한 $c_i = \sum_{j=1}^3 n_{ij}$ 를 대입하면 $\frac{c_i}{c_i} = 1$ 이 된다. 즉, 조건부 확률 역시 그 자체로 확률의 총합이 $1$ 이 되는 완벽하게 독립적이고 콜모고로프 3공리를 만족하는 1차원 확률 분포 함수임을 보장한다.
$\quad$ 머신러닝에서 우리는 범주형 변수(categorical variables), 즉 순서가 없는 유한한 값들의 집합을 취하는 변수를 모델링하기 위해 이산 확률 분포를 사용한다. 이것들은 사람의 연봉을 예측할 때 사용되는 대학교 학위와 같은 범주형 특성(features)일 수도 있고, 필기 인식(handwriting recognition)을 수행할 때 알파벳 글자와 같은 범주형 라벨(labels)일 수도 있다. 이산 분포는 유한한 수의 연속 분포들을 결합하는 확률적 모델을 구성하는 데에도 종종 사용된다 (11장).
6.2.2 연속 확률
이 절에서 우리는 실수형 확률 변수들을 고려한다. 즉, 목표 공간이 실수선 $\mathbb{R}$ 의 구간(intervals)인 경우를 고려한다. 이 책에서 우리는 유한한 상태를 가지는 이산 확률 공간을 다룰 때처럼 실수형 확률 변수에 대해서도 연산을 수행할 수 있는 것처럼 가정(pretend)할 것이다. 하지만 이러한 단순화는 두 가지 상황, 즉 무언가를 무한히 자주 반복할 때와 구간에서 한 점을 추출하고자 할 때 정확하지 않다. 첫 번째 상황은 머신러닝에서 일반화 오차(generalization errors)를 논의할 때 발생한다(8장). 두 번째 상황은 가우시안(Gaussian)과 같은 연속 분포를 논의하고자 할 때 발생한다([6.5절]). 우리의 목적상 이러한 정밀도의 부족은 확률에 대한 더 간결한 소개를 가능하게 한다.
주목 (Remark). 연속 공간에는 직관에 반하는 두 가지 추가적인 기술적 문제(technicalities)가 있다. 첫째, (6.1절에서 사건 공간 $\mathcal{A}$ 를 정의하는 데 사용된) 모든 부분집합들의 집합은 충분히 잘 작동(well behaved)하지 않는다. $\mathcal{A}$ 는 집합의 여집합, 교집합, 합집합 하에서 잘 작동하도록 제한될 필요가 있다. 둘째, 집합의 크기(이산 공간에서는 원소들을 세어서 얻을 수 있음)를 구하는 것이 까다로워진다. 집합의 크기를 측도(measure)라고 부른다. 예를 들어, 이산 집합의 기수(cardinality), $\mathbb{R}$ 에서의 구간의 길이, 그리고 $\mathbb{R}^d$ 에서의 영역의 부피는 모두 측도이다. 집합 연산 하에서 잘 작동하며 추가적으로 위상(topology)을 가지는 집합들을 보렐 시그마 대수(Borel $\sigma$ -algebra)라고 부른다.
$\quad$ 이 책에서 우리는 실수형 확률 변수들이 그에 상응하는 보렐 시그마 대수를 가진다고 고려한다. $\mathbb{R}^D$ 의 값을 가지는 확률 변수는 실수형 확률 변수들의 벡터로 간주한다.
$\to$ 어떤 집합이 위상을 가진다는 것은, 그 집합 내의 원소들 사이에 서로 ‘가깝다’, 또는 ‘연속적으로 이어져 있다’라는 성질을 대수적으로 정의할 수 있는 수학적 구조가 부여되어 있음을 의미한다.
실수 공간 $\mathbb{R}$ 에서는 개구간(Open interval) $(a, b)$ 들이 이 위상을 형성한다. 이 개구간들이 존재해야만, 우리는 극한(Limit, $\lim_{x \to a} f(x)$ )과 미분 가능성이라는 연산을 모순 없이 전개할 수 있다.
반대로 위상이 부여되지 않은 집합은 오직 원소의 포함 여부( $\in$ )만을 다룰 뿐이다. 이 공간에는 원소 간의 거리, 경계, 극한점이라는 개념이 부재하므로 극한 연산이나 미분 연산을 전개할 수 없다.
정의 6.1 (확률 밀도 함수, Probability Density Function). 함수 $f : \mathbb{R}^D \to \mathbb{R}$ 가 다음을 만족하면 확률 밀도 함수(pdf)라고 불린다.
-
$\forall x \in \mathbb{R}^D : f(x) \ge 0$
-
적분이 존재하며, 다음 식을 만족한다.
이산 확률 변수의 확률 질량 함수(pmf)의 경우, 식 (6.15)의 적분은 합(6.12)으로 대체된다.
$\quad$ 연속 공간의 확률 밀도 함수는 음수가 아니며 적분하여 $1$ 이 되는 임의의 함수 $f$ 임을 관찰하라. 우리는 확률 변수 $X$ 를 다음 식을 통해 이 함수 $f$ 와 연관시킨다.
여기서 $a, b \in \mathbb{R}$ 이고 $x \in \mathbb{R}$ 는 연속 확률 변수 $X$ 의 결과들이다. 상태 $\boldsymbol{x} \in \mathbb{R}^D$ 는 $x \in \mathbb{R}$ 의 벡터를 고려함으로써 유사하게 정의된다. 이 연관성 (6.16)을 확률 변수 $X$ 의 법칙(law) 또는 분포(distribution)라고 부른다.
주목 (Remark). 이산 확률 변수와 대조적으로, 연속 확률 변수 $X$ 가 특정한 값 $x$ 를 가질 확률 $P(X=x)$ 는 $0$ 이다. 이는 식 (6.16)에서 $a=b$ 인 구간을 명시하려는 것과 같다.( $P(X = a) = \int_a^a f(x)dx = 0$ )
정의 6.2 (누적 분포 함수, Cumulative Distribution Function, CDF). 상태 $\boldsymbol{x} \in \mathbb{R}^D$ 를 가지는 다변량 실수형 확률 변수 $X$ 의 누적 분포 함수(cdf)는 다음과 같이 주어진다.
여기서 $X = [X_1, \dots, X_D]^\top$ , $\boldsymbol{x} = [x_1, \dots, x_D]^\top$ 이며, 우변은 확률 변수 $X_i$ 가 $x_i$ 보다 작거나 같은 값을 가질 확률을 나타낸다.
$\quad$ cdf는 확률 밀도 함수 $f(\boldsymbol{x})$ 의 적분으로도 표현될 수 있으므로 다음과 같다.
주목 (Remark). 분포에 대해 이야기할 때 사실 두 가지 구별되는 개념이 존재함을 다시 한번 강조한다. 첫 번째는 pdf(기호 $f(x)$ 로 표기됨)의 개념으로, 이는 합하여 $1$ 이 되는 비음수(nonnegative) 함수이다. 두 번째는 확률 변수 $X$ 의 법칙, 즉 확률 변수 $X$ 를 pdf $f(x)$ 와 연관시키는 것이다.
$\quad$ 이 책의 대부분에서 우리는 pdf와 cdf를 구별할 필요가 거의 없기 때문에 $f(x)$ 와 $F_X(x)$ 표기법을 사용하지 않을 것이다. 하지만 6.7절에서는 pdf와 cdf에 대해 주의해야 할 것이다.
$\to$ 정의 6.2에 따르면, 2차원 결합 CDF는 다음과 같이 두 사건의 교집합으로 정의된다.
여기서 변수 $x_2$ 에 극한을 취해 양의 무한대( $\infty$ )로 보낸다고 가정해보자.
수학적으로 확률 변수 $X_2$ 가 ‘무한대보다 작거나 같다( $X_2 \le \infty$ )’는 조건은 실수 공간 전체를 포괄하므로, 확률 공간 $\Omega$ 에서 반드시 일어나는 전사건(certain event)이 된다. 전사건과의 교집합 연산( $A \cap \Omega = A$ )은 대수적으로 자기 자신을 반환한다. 따라서 $X_2$ 에 대한 제약 조건이 소거되어, 오직 $X_1$ 에 대한 제약만 남게 된다.
이를 미적분의 관점에서 보자. 2차원 결함 CDF는 다음과 같이 pdf의 적분 꼴로 정의할 수 있다.
이 식에서 상한선 $x_2$ 를 $\infty$ 로 극한을 취하면 다음과 같다.
여기서 안쪽 괄호의 적분 $\int_{-\infty}^{\infty} f(z_1, z_2) dz_2$ 를 보자. 이전 6.2.1절에서 이산 공간의 주변 확률을 구할 때, 필요 없는 변수에 대해 $\sum$ 로 특정 확률 변수의 모든 가능한 상태를 전부 더해서 소거했다. 연속 공간에서는 그 $\sum$ 연산이 $\int_{-\infty}^{\infty}$ 연산으로 대치된다.
즉, 결합 밀도 함수 $f(z_1, z_2)$ 를 $z_2$ 의 전체 공간( $-\infty$ 부터 $\infty$ 까지)에 대해 적분(합산)해 버리면, 변수 $z_2$ 의 차원은 완전히 소거되고 오직 $z_1$ 만의 1차원 주변 확률 밀도 함수인 $f_{X_1}(z_1)$ 이 도출된다.
$\to$ 적분이 변수를 소거하는지 확인하기 위해, 적분의 두 가지 형태를 구분해야 한다. 다변수 함수 $f(x, y) = xy^2$ 을 예로 들어보자.
부정적분(indefinite integral): 구간이 정해지지 않은 역도함수 연산이다.
부정적분에서는 상한선과 하한선이 없으므로(indefinite) 변수 $y$ 가 그대로 남아있다. 즉, 변수가 소거되지 않는다.
정적분(definite integral): 특정 구간 $[a,b]$ 에 대한 적분이다.
이때 변수 $y$ 의 자리에 상수인 상한선 $b$ 와 하한선 $a$ 가 대입되면서, 결과식에는 오직 변수 $x$ 만 남게 된다. 함수 $f(x, y)$ 가 $g(x)$ 라는 1변수 함수로 붕괴(또는 축소)된다.
정적분이 변수를 소거한다는 것은 기하학적으로 해당 변수의 축을 따라 존재하는 모든 함숫값을 합산하여 한 차원 낮은 공간으로 투영시키는 행위이다. 이를 확률 밀도 함수 $f(x, y)$ 에 가져와 적분 구간을 $(-\infty, \infty)$ 로 설정한 것이 바로 주변 확률 밀도 함수 $f_X(x) = \int_{-\infty}^{\infty} f(x, y)dy$ 이다.
6.2.3 이산 확률과 연속 확률의 대조
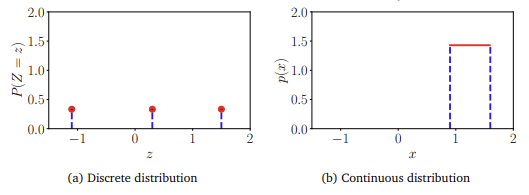
6.1.2절에서 확률은 양수이며 전체 확률의 합은 $1$ 이 된다는 것을 상기해 보자. 이산 확률 변수의 경우 (식 (6.12) 참조), 이는 각 상태의 확률이 반드시 구간 $[0, 1]$ 내에 있어야 함을 암시한다. 하지만 연속 확률 변수의 경우, 정규화(식 (6.15) 참조)가 곧 밀도의 값이 모든 값에 대해 $1$ 보다 작거나 같아야 함을 암시하지는 않는다. 우리는 이산 확률 변수와 연속 확률 변수 모두에 대해 균등 분포(uniform distribution)를 사용하여 그림 6.3에서 이를 설명한다.
예제 6.3
각 상태가 발생할 가능성이 동일한 균등 분포의 두 가지 예를 고려해 보자. 이 예제는 이산 확률 분포와 연속 확률 분포 사이의 몇 가지 차이점을 보여준다.
$\quad$ $Z$ 를 세 가지 상태 ${z = -1.1, z = 0.3, z = 1.5}$ 를 가지는 이산 균등 확률 변수라고 하자. 확률 질량 함수는 확률값들의 표로 나타낼 수 있다:
대안적으로, 우리는 이를 그래프(그림 6.3(a))로 생각할 수 있으며, 여기서 우리는 상태들이 $x$ 축에 위치할 수 있고 $y$ 축이 특정 상태의 확률을 나타낸다는 사실을 사용한다. 그림 6.3(a)의 $y$ 축은 그림 6.3(b)와 동일하게 보이도록 의도적으로 연장되었다.
$\quad$ $X$ 를 그림 6.3(b)에 표현된 바와 같이 $0.9 \le X \le 1.6$ 범위의 값을 가지는 연속 확률 변수라고 하자. 밀도의 높이가 $1$ 보다 클 수 있음을 관찰하라. 하지만 다음 식은 반드시 성립해야 한다:
주목 (Remark). 이산 확률 분포와 관련하여 추가적인 미묘함(subtlety)이 존재한다. 상태들 $z_1, \dots, z_d$ 는 원칙적으로 어떠한 구조도 가지지 않는다. 즉, 예를 들어 $z_1 = \text{red}$ , $z_2 = \text{green}$ , $z_3 = \text{blue}$ 와 같이 이들을 비교할 방법이 대개 존재하지 않는다. 하지만 많은 머신러닝 응용 분야에서 이산 상태들은 숫자 값을 취하며 (예: $z_1 = -1.1, z_2 = 0.3, z_3 = 1.5$ ), 이 경우 우리는 $z_1 < z_2 < z_3$ 라고 말할 수 있다. 숫자 값을 취하는 이산 상태들은 우리가 종종 확률 변수의 기댓값(expected values, 6.4.1절)을 고려하기 때문에 특히 유용하다.
$\to$ 범주형 데이터를 숫자로 매핑할 때, 임의로 할당된 숫자의 크기가 분포의 의미를 왜곡하는지 확인해야 한다. 가령 직업군을 모델링할 때 $1=\text{교사}, 2=\text{의사}, 3=\text{개발자}$ 로 숫자를 매핑하고 평균(기댓값)을 구하면 $2.5$ 와 같은 무의미한 숫자가 도출된다. 의사가 개발자보다 대수적으로 ‘크다’는 구조는 존재하지 않는다. 위에서 $z_1 = -1.1, z_2 = 0.3$ 과 같이 숫자로 표현되어 대소 비교가 가능해야 유용하다고 한 것은, 그 변수 자체가 애초에 온도나 주식 수익률처럼 수학적 서열과 간격을 본질적으로 가지고 있는 이산 데이터일 경우에만 기댓값 연산이 수학적으로 타당성을 지닌다는 점을 전제하고 있는 것이다.
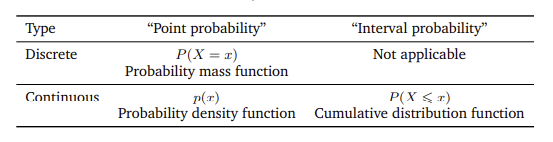
$\quad$ 안타깝게도 머신러닝 문헌들은 표본 공간 $\Omega$ , 목표 공간 $\mathcal{T}$ , 그리고 확률 변수 $X$ 사이의 구분을 숨기는 표기법과 명명법을 사용한다. 확률 변수 $X$ 의 가능한 결과들의 집합 내의 어떤 값 $x$ , 즉 $x \in \mathcal{T}$ 에 대하여, $p(x)$ 는 확률 변수 $X$ 가 결과 $x$ 를 가질 확률을 나타낸다. (사이드바: 우리는 결과 $x$ 를 확률 $p(x)$ 를 도출하는 인자(argument)로 생각한다.) 이산 확률 변수의 경우, 이는 $P(X = x)$ 로 쓰이며 확률 질량 함수(probability mass function)로 알려져 있다. pmf는 종종 “분포(distribution)”라고 불린다. 연속 변수의 경우, $p(x)$ 는 확률 밀도 함수(probability density function, 종종 밀도라고 불림)라고 불린다. 상황을 더욱 혼란스럽게 만드는 것은, 누적 분포 함수 $P(X \le x)$ 역시 종종 “분포(distribution)”라고 불린다는 점이다. 이 장에서 우리는 일변량(univariate) 및 다변량(multivariate) 확률 변수 모두를 지칭하기 위해 표기법 $X$ 를 사용할 것이며, 상태들은 각각 $x$ 와 $\boldsymbol{x}$ 로 표기할 것이다. 우리는 표 6.1에 명명법을 요약한다.
주목 (Remark). 우리는 엄밀히 따지면 틀린 것이지만, 이산 확률 질량 함수뿐만 아니라 연속 확률 밀도 함수에 대해서도 “확률 분포(probability distribution)”라는 표현을 사용할 것이다. 대부분의 머신러닝 문헌과 마찬가지로, 우리는 확률 분포라는 구문의 서로 다른 용법들을 구별하기 위해 문맥(context)에 의존한다.
$\to$ 표 6.1을 보면 이산 변수는 구간 확률 연산을 정의하지 않는다. “주사위를 던졌을 때 2 이상 4 이하가 나올 구간 확률 $P(2 \le X \le 4)$ 를 구할 수 있지 않은가?”라고 생각할 수 있다.
해당 이산 공간에서 위 질문에 대한 구간 확률은 $P(2 \le X \le 4) = P(X=2) + P(X=3) + P(X=4)$ 이다. 즉, 새로운 ‘누적 구간 함수’를 정의할 필요 없이, 단순히 ‘점 확률(PMF)’들의 덧셈 연산( $\sum$ )만으로 구간 확률 연산을 정의할 수 있기 때문이다.
$\to$ 분포, 질량, 밀도, 누적은 위상과 차원이 완전히 다른 별개의 함수들이지만, 머신러닝에서 이를 단순히 $p(x)$ 또는 ‘분포’라고 통일해서 부르는 이유로 음의 로그 우도(negative log-likelihood)를 꼽을 수 있다.
이 최적화 파이프라인 안에서 데이터가 이산적이어서 $p(x)$ 가 PMF이든, 연속적인 센서 데이터여서 $p(x)$ 가 PDF이든 텐서 연산은 동일하게 작용된다. 컴퓨터 메모리 위에서는 어차피 둘 다 스칼라 실수값을 반환하는 목적 함수일 뿐이므로, 실무적으로 이 둘의 차이를 매번 구분하는 것이 불필요하다고 판단한 것이다.