행렬 근사
우리는 SVD를 $A = U \Sigma V^\top \in \mathbb{R}^{m \times n}$ 과 같이 세 행렬의 곱으로 분해하는 방법으로 고찰했다. 여기서 $U \in \mathbb{R}^{m \times m}$ 과 $V \in \mathbb{R}^{n \times n}$ 은 직교 행렬이고 $\Sigma$ 는 주대각선에 특이값들을 포함한다. 전체 SVD 분해를 수행하는 대신, 우리는 이제 SVD가 행렬 $A$ 를 더 간단한(low-rank) 행렬들 $A_i$ 의 합으로 표현하게 해주는 방법을 조사할 것이다. 이는 전체 SVD보다 계산 비용이 저렴한 행렬 근사 기법으로 이어진다.
$\quad$ 우리는 랭크-1 행렬 $A_i \in \mathbb{R}^{m \times n}$ 을 다음과 같이 구성한다.
이는 $U$ 와 $V$ 의 $i$ 번째 직교 열벡터들의 외적(outer product)에 의해 형성된다. 그림 4.11은 스톤헨지(Stonehenge) 이미지를 보여주는데, 이는 행렬 $A \in \mathbb{R}^{1432 \times 1910}$ 으로 표현될 수 있으며, (4.90)에서 정의된 몇몇 외적 $A_i$ 들도 보여준다.
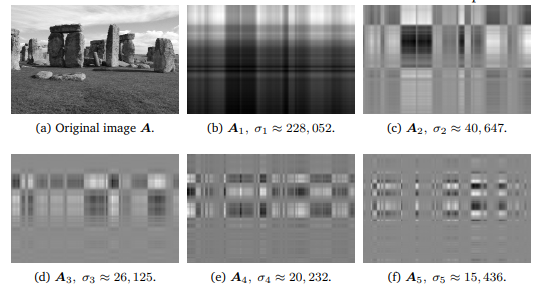
$\to$ 그림 4.11 (SVD를 이용한 이미지 처리). (a) 원본 흑백 이미지는 0(검정)과 1(흰색) 사이의 값을 갖는 $1,432 \times 1,910$ 행렬이다. (b)-(f) 랭크-1 행렬들 $A_1, \dots, A_5$ 와 그들에 대응하는 특이값 $\sigma_1, \dots, \sigma_5$ . 각 랭크-1 행렬의 격자(grid) 같은 구조는 좌측 및 우측 특이벡터의 외적(outer-product)에 의해 부과된 것이다.
$\quad$ 랭크가 $r$ 인 행렬 $A \in \mathbb{R}^{m \times n}$ 은 랭크-1 행렬들 $A_i$ 의 합으로 다음과 같이 쓰일 수 있다.
여기서 외적 행렬 $A_i$ 는 $i$ 번째 특이값 $\sigma_i$ 에 의해 가중치가 부여된다. 우리는 왜 (4.91)이 성립하는지 알 수 있다. 특이값 행렬 $\Sigma$ 의 대각 구조는 오직 짝이 맞는 좌/우 특이벡터 $u_i v_i^\top$ 끼리만 곱해지게 하며, 그들을 대응하는 특이값 $\sigma_i$ 로 스케일링한다. $i \neq j$ 인 모든 항 $\Sigma_{ij} u_i v_j^\top$ 는 $\Sigma$ 가 대각 행렬이기 때문에 사라진다. $i > r$ 인 항들도 대응하는 특이값이 0이기 때문에 사라진다.
$\quad$ (4.90)에서, 우리는 랭크-1 행렬 $A_i$ 를 도입했다. 우리는 $r$ 개의 개별적인 랭크-1 행렬들을 모두 더하여 랭크- $r$ 행렬 $A$ 를 얻었다(식 4.91 참조). 만약 이 합이 모든 행렬 $A_i (i=1, \dots, r)$ 에 대해 수행되지 않고 중간값 $k < r$ 까지만 수행된다면, 우리는 다음과 같은 $A$ 의 랭크- $k$ 근사(rank- $k$ approximation)를 얻는다.
이때 $\text{rk}(\widehat{A}(k)) = k$ 이다. 그림 4.12는 스톤헨지 원본 이미지 $A$ 의 저랭크 근사들 $\widehat{A}(k)$ 를 보여준다.
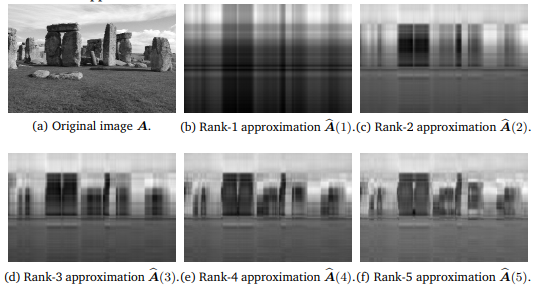
그림 4.12 (SVD를 이용한 이미지 복원). (a) 원본 이미지. (b)-(f) SVD의 저랭크 근사를 이용한 이미지 복원. 랭크- $k$ 근사는 $\widehat{A}(k) = \sum_{i=1}^{k} \sigma_i A_i$ 로 주어진다.
바위의 형상은 랭크-5 근사에서 점차 가시화되고 명확하게 인식 가능해진다. 원본 이미지는 $1,432 \times 1,910 = 2,735,120$ 개의 숫자를 필요로 하는 반면, 랭크-5 근사는 오직 5개의 특이값과 5개의 좌/우 특이벡터들( $1,432$ 차원과 $1,910$ 차원 각각)만 저장하면 되므로, 총 $5 \cdot (1,432 + 1,910 + 1) = 16,715$ 개의 숫자만 필요하다. 이는 원본의 겨우 0.6% 수준이다.
$\quad$ $A$ 와 그 랭크- $k$ 근사 $\widehat{A}(k)$ 사이의 차이(오차)를 측정하기 위해, 우리는 노름(norm)의 개념이 필요하다. 3.1절에서 우리는 벡터의 길이를 측정하는 벡터 노름을 이미 사용했다. 유추를 통해 우리는 행렬에 대한 노름도 정의할 수 있다.
정의 4.23 (행렬의 스펙트럴 노름). $x \in \mathbb{R}^n \setminus {0}$ 에 대해, 행렬 $A \in \mathbb{R}^{m \times n}$ 의 스펙트럴 노름(spectral norm)은 다음과 같이 정의된다.
$\to$ 행렬의 스펙트럴 노름이 왜 (4.93)처럼 정의되는지에 대해 적은 글이 있으니 참고하라.Matrix norm
우리는 행렬 노름의 아래첨자 표기(좌변)를 도입하는데, 이는 벡터의 유클리드 노름(우변, 아래첨자 2)과 유사하다. 스펙트럴 노름 (4.93)은 어떤 벡터 $x$ 가 $A$ 와 곱해졌을 때 최대로 얼마나 길어질 수 있는지를 결정한다.
정리 4.24. $A$ 의 스펙트럴 노름은 그것의 가장 큰 특이값 $\sigma_1$ 이다. (증명은 연습문제로 남김).
정리 4.25 (에카트-영 정리, Eckart and Young, 1936). 랭크가 $r$ 인 행렬 $A \in \mathbb{R}^{m \times n}$ 과 랭크가 $k$ 인 행렬 $B \in \mathbb{R}^{m \times n}$ 를 고려하자. $\widehat{A}(k) = \sum_{i=1}^{k} \sigma_i u_i v_i^\top$ 인 임의의 $k \le r$ 에 대하여 다음이 성립한다.
$\to$ (4.94)는 랭크가 $k$ 인 수많은 후보 행렬 $B$ 중에서, 원본( $A$ )과의 차이를 가장 적게 만드는 최적의 행렬 $B$ 가 무엇인가를 묻는다. i.e., $\Vert A - B\Vert _2$ (오차) 값을 최소로 만드는 $B$ 를 찾는 것이 목표이며, 그 정답은 바로 SVD를 통해 상위 $k$ 개의 정보만 남긴 행렬 $\widehat{A}(k)$ 이다.
$\to$ 오차 행렬은 원본에서 $\widehat{A}(k)$ 를 뺀 나머지 부분, 즉 $E = \sigma_{k+1} A_{k+1} + \sigma_{k+2} A_{k+2} + \dots + \sigma_r A_r$ 이다. 특이값은 내림차순( $\sigma_{k+1} \ge \sigma_{k+2} \ge \dots$ )으로 정렬되어 있고, 스펙트럴 노름은 ‘가장 큰 특이값’으로 정의되므로, 전체 오차 행렬의 크기 $\Vert E\Vert _2$ 는 가장 앞에 있는 $\sigma_{k+1}$ 이 된다.
$\quad$ 에카트-영 정리는 우리가 랭크- $k$ 근사를 사용하여 $A$ 를 근사할 때 발생하는 오차가 얼마인지 명시적으로 말해준다. 우리는 SVD를 통해 얻은 랭크- $k$ 근사를, 전체 랭크(full-rank) 행렬 $A$ 를 ‘랭크가 최대 $k$ 인 행렬들의 저차원 공간’으로 사영(projection)시킨 것으로 해석할 수 있다. 가능한 모든 사영 중에서, SVD는 $A$ 와 임의의 랭크- $k$ 근사 사이의 오차(스펙트럴 노름에 관하여)를 최소화한다.
$\quad$ 우리는 (4.95)가 왜 성립해야 하는지 이해하기 위해 몇 가지 단계를 되짚어 볼 수 있다. 우리는 $A - \widehat{A}(k)$ 의 차이가 나머지 랭크-1 행렬들의 합을 포함하는 행렬임을 관찰한다.
정리 4.24에 의해, 우리는 즉시 차이 행렬(difference matrix)의 스펙트럴 노름으로서 $\sigma_{k+1}$ 을 얻는다. 이제 (4.94)를 좀 더 자세히 살펴보자. 만약 $\text{rk}(B) \le k$ 인 또 다른 행렬 $B$ 가 존재하여 다음을 만족한다고 가정해보자.
그러면 $x \in Z$ 이면 $Bx = 0$ 을 만족하는 적어도 $(n-k)$ 차원의 영공간(null space) $Z \subseteq \mathbb{R}^n$ 이 존재한다. 그러면 다음이 따른다.
그리고 행렬의 노름을 포함하는 코시-슈바르츠 부등식(3.17)의 버전을 사용하여 우리는 다음을 얻는다.
하지만, $\Vert Ax\Vert _2 \ge \sigma_{k+1} \Vert x\Vert _2$ 인 $(k+1)$ 차원 부분공간이 존재하며, 이는 $A$ 의 우-특이벡터들 $v_j (j \le k+1)$ 에 의해 스팬된다. 이 두 공간( $Z$ 와 우-특이벡터 공간)의 차원을 더하면 $n$ 보다 큰 숫자가 나오는데, 이는 두 공간 모두에 속하는 0이 아닌 벡터가 있어야 함을 의미한다. 이것은 2.7.3절의 랭크-널리티 정리(정리 2.24)에 모순된다.
$\to$ $A - \widehat{A}(k)$ 의 차이가 나머지 랭크-1 행렬들의 합(4.96)이다. $A - \widehat{A}(k)=E$ (오차 행렬)이라 했을 때 $\Vert E\Vert _2=\sigma_{k+1}$ 이다(정의 4.23). 이때 이보다 오차를 더 줄일 수 있는 행렬 $B$ 가 존재한다고 해보자(4.97). $rk(B)=k$ 이며, $B$ 는 $(n-k)$ 차원 영공간을 가지며, 그 영공간에 속한 어떤 벡터 $x$ 에 대해 $Bx=0$ 을 만족한다. B가 A와 얼마나 다른지 확인하기 위해 이 $x$ 가 행렬 $(A-B)$ 에 작용했을 때 크기 $\Vert (A - B)x\Vert _2$ 를 분배법칙을 통해 풀어쓰면 $\Vert Ax - Bx\Vert _2=\Vert Ax\Vert$ 이다(4.98). 여기까지는 이해했는데, (4.99)가 어떻게 도출되는지는 아직 와닿지 않음.
이유 1. 영공간에 대한 직관 부족, 이유 2. 행렬 norm의 정의에 대한 이해 부족, 이유 3. 행렬간의 차이(A-B)가 어떻게 오차를 의미하는지
$\quad$ 에카트-영 정리는 우리가 랭크- $r$ 행렬 $A$ 를 랭크- $k$ 행렬 $\widehat{A}$ 로 줄일 때, 원칙에 입각하여 최적의 방식(스펙트럴 노름의 의미에서)으로 SVD를 사용할 수 있음을 시사한다. 우리는 랭크- $k$ 행렬에 의한 $A$ 의 근사를 손실 압축(lossy compression)의 한 형태로 해석할 수 있다. 따라서, 행렬의 저랭크 근사는 이미지 처리, 노이즈 필터링, 그리고 불량 설정 문제(ill-posed problems)의 정규화(regularization) 등 많은 머신러닝 응용 분야에 등장한다. 게다가 이것은 우리가 10장에서 보게 될 차원 축소(dimensionality reduction)와 주성분 분석(PCA)에서 핵심적인 역할을 수행한다.
예제 4.15 (영화 평점과 소비자에서의 구조 찾기 - 계속)
영화 평점 예제로 돌아와서, 우리는 이제 원본 데이터 행렬을 근사하기 위해 저랭크 근사의 개념을 적용할 수 있다. 우리의 첫 번째 특이값이 영화에서의 공상과학(SF) 테마와 SF 애호가들의 개념을 포착했음을 상기하자. 따라서, 영화 평점 행렬의 랭크-1 분해에서 오직 첫 번째 특이값 항만을 사용함으로써, 우리는 다음과 같은 예측된 평점들을 얻는다.
(참고: 위 식은 $A_1$ 자체의 계산이며, 실제 근사값은 여기에 $\sigma_1 \approx 9.64$ 를 곱해야 합니다. 책의 서술 흐름상 패턴(구조)을 먼저 보여주는 것입니다.)
이 첫 번째 랭크-1 근사 $A_1$ 은 통찰력을 준다. 이것은 우리에게 Ali와 Beatrix가 스타워즈와 블레이드 러너 같은 SF 영화를 좋아한다고(성분들의 값이 0.4보다 큼) 말해준다. 하지만 Chandra의 다른 영화들에 대한 평점을 포착하는 데는 실패한다. 이는 놀라운 일이 아닌데, 왜냐하면 Chandra의 영화 취향은 첫 번째 특이값(SF 테마)에 의해 포착되지 않기 때문이다. 두 번째 특이값은 우리에게 그러한 영화 테마 애호가들을 위한 더 나은 랭크-1 근사를 제공한다.
이 두 번째 랭크-1 근사 $A_2$ 에서, 우리는 Chandra의 평점과 영화 유형들을 잘 포착하지만, SF 영화들은 그렇지 못하다. 이것은 우리가 첫 두 개의 랭크-1 근사들을 결합하는 랭크-2 근사 $\widehat{A}(2)$ 를 고려하도록 이끈다.
$\widehat{A}(2)$ 는 원본 영화 평점 테이블 $A$ 와 유사하다.
그리고 이것은 우리가 $A_3$ 의 기여를 무시할 수 있음을 시사한다. 우리는 이것을 데이터 테이블 안에 제3의 영화 테마나 영화 애호가 카테고리에 대한 증거가 없다는 것으로 해석할 수 있다. 이것은 또한 우리 예제에서의 영화 테마/애호가들의 전체 공간이 SF와 프랑스 예술 영화 및 애호가들에 의해 스팬(span)되는 2차원 공간임을 의미한다.