우리는 두 가지 관점에서 PCA를 유도했다. (a) 투영된 공간에서의 분산을 최대화하는 것, (b) 평균 재구성 오차를 최소화하는 것이 그것이다. 그러나 PCA는 다른 관점에서도 해석될 수 있다. 우리가 수행한 작업을 요약해 보자. 우리는 고차원 데이터 $\boldsymbol{x} \in \mathbb{R}^D$ 를 가져와 행렬 $\boldsymbol{B}^\top$ 를 사용해 저차원 표현 $\boldsymbol{z} \in \mathbb{R}^M$ 을 찾아냈다. $\boldsymbol{B}$ 의 열은 가장 큰 고윳값과 연관된 데이터 공분산 행렬 $\boldsymbol{S}$ 의 고유벡터들이다. 일단 저차원 표현 $\boldsymbol{z}$ 를 얻으면, 원래 데이터 공간에서의 고차원 버전인 $\boldsymbol{x} \approx \tilde{\boldsymbol{x}} = \boldsymbol{Bz} = \boldsymbol{BB}^\top \boldsymbol{x} \in \mathbb{R}^D$ 를 얻을 수 있으며, 여기서 $\boldsymbol{BB}^\top$ 는 투영 행렬이다.
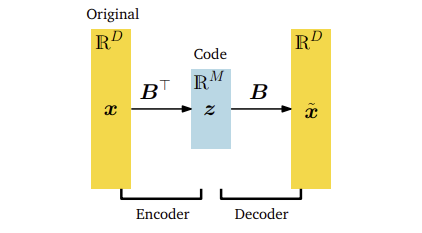
그림 10.16 PCA는 선형 오토인코더로 볼 수 있다. 이는 고차원 데이터 $\boldsymbol{x}$ 를 저차원 표현(코드) $\boldsymbol{z} \in \mathbb{R}^M$ 으로 인코딩하고 디코더를 사용하여 $\boldsymbol{z}$ 를 디코딩한다. 디코딩된 벡터 $\tilde{\boldsymbol{x}}$ 는 원래 데이터 $\boldsymbol{x}$ 를 $M$ 차원 주 부분공간(principal subspace) 위로 직교 사영한 결과이다.
$\quad$ 우리는 또한 그림 10.16에 묘사된 것처럼 PCA를 선형 오토인코더(linear auto-encoder)로 생각할 수 있다. 오토인코더는 데이터 $\boldsymbol{x}_n \in \mathbb{R}^D$ 를 코드 $\boldsymbol{z}_n \in \mathbb{R}^M$ 으로 인코딩하고 이를 $\boldsymbol{x}_n$ 과 유사한 $\tilde{\boldsymbol{x}}_n$ 으로 디코딩한다. 데이터에서 코드로의 매핑을 인코더(encoder)라 부르고, 코드에서 원래 데이터 공간으로 되돌리는 매핑을 디코더(decoder)라 부른다. 만약 코드가 $\boldsymbol{z}_n = \boldsymbol{B}^\top \boldsymbol{x}_n \in \mathbb{R}^M$ 으로 주어지고 데이터 $\boldsymbol{x}_n$ 과 그 재구성 $\tilde{\boldsymbol{x}}_n = \boldsymbol{Bz}_n, n=1,\dots,N$ 사이의 평균 제곱 오차를 최소화하는 데 관심이 있다면, 다음을 얻는다.
이는 우리가 10.3절에서 논의했던 것과 동일한 목적 함수를 갖게 됨을 의미하므로, 제곱 오토인코딩 손실을 최소화할 때 PCA 해를 얻게 된다. 만약 PCA의 선형 매핑을 비선형 매핑으로 대체하면 비선형 오토인코더를 얻는다. 이것의 두드러진 예시는 선형 함수가 심층 신경망으로 대체된 심층 오토인코더(deep auto-encoder)이다. 이러한 맥락에서 인코더는 인식 네트워크(recognition network) 또는 추론 네트워크(inference network)로도 알려져 있으며, 디코더는 생성기(generator)라고도 불린다.
$\quad$ PCA의 또 다른 해석은 정보 이론과 관련이 있다. 우리는 코드를 원래 데이터 포인트의 더 작거나 압축된 버전으로 생각할 수 있다. 코드를 사용해 원래 데이터를 재구성할 때 정확히 동일한 데이터 포인트를 얻지는 못하지만, 약간 왜곡되거나 노이즈가 섞인 버전을 얻게 된다. 이는 우리의 압축이 손실이 있음(lossy)을 의미한다. 직관적으로 우리는 원래 데이터와 저차원 코드 사이의 상관관계를 최대화하기를 원한다. 더 엄밀하게는, 이는 정보 이론의 핵심 개념인 상호 정보량(mutual information)을 최대화하는 것과 관련이 있다(MacKay, 2003). 상호 정보량을 최대화함으로써 10.3절에서 논의한 것과 동일한 PCA 해를 얻게 될 것이다.
$\quad$ PPCA에 대한 논의에서 우리는 모델의 파라미터인 $\boldsymbol{B}, \boldsymbol{\mu}$ 및 우도 파라미터 $\sigma^2$ 이 알려져 있다고 가정했다. Tipping과 Bishop (1999)은 PPCA 설정에서 이러한 파라미터들에 대한 최대 우도 추정치(MLE)를 유도하는 방법을 설명한다. $D$ 차원 데이터를 $M$ 차원 아평면으로 투영할 때의 최대 우도 해는 다음과 같다.
여기서 $\boldsymbol{T} \in \mathbb{R}^{D \times M}$ 은 데이터 공분산 행렬의 $M$ 개 고유벡터를 포함하고, $\boldsymbol{\Lambda} = \text{diag}(\lambda_1, \dots, \lambda_M) \in \mathbb{R}^{M \times M}$ 은 대각선에 주성분 축과 연관된 고윳값들을 가진 대각 행렬이며, $\boldsymbol{R} \in \mathbb{R}^{M \times M}$ 은 임의의 직교 행렬이다. 최대 우도 해 $\boldsymbol{B}_{ML}$ 은 임의의 직교 변환에 대해서만 유일하다. 예를 들어 $\boldsymbol{B}_{ML}$ 에 임의의 회전 행렬 $\boldsymbol{R}$ 을 우측 곱할 수 있으므로, (10.78)은 본질적으로 특이값 분해이다(4.5절 참조). 증명의 개요는 Tipping과 Bishop (1999)에 의해 주어져 있다.
(10.78)의 행렬 $\boldsymbol{\Lambda} - \sigma^2 \boldsymbol{I}$ 는 데이터 공분산 행렬의 가장 작은 고윳값이 노이즈 분산 $\sigma^2$ 에 의해 아래로 제한(bounded)되므로 양의 준정부호(positive semidefinite)임이 보장된다.
$\to$ 임의의 $M \times M$ 직교행렬 $\boldsymbol{R}$ 은 잠재 공간 내부에서 좌표축을 회전시키거나 반전시키는 역할을 한다.
PPCA 모델에서 잠재 변수 $\boldsymbol{z}$ 의 사전 분포(prior)는 평균이 0이고 공분산이 단위 행렬인 등방성 가우시안 분포( $p(\boldsymbol{z}) = \mathcal{N}(\mathbf{0}, \boldsymbol{I})$ )로 가정된다. 이 분포는 어느 방향으로든 대칭적인 구(sphere) 형태를 띠고 있어, 좌표축을 어떻게 회전시켜도 분포의 형태가 변하지 않는다. 따라서 다음과 같은 논리가 성립한다.
1.잠재 공간에서 $\boldsymbol{z}$ 를 $\boldsymbol{R}$ 만큼 회전시켜도 전체적인 확률 구조는 동일하다.
2.이에 대응하여 관측 공간으로 투영하는 행렬 $\boldsymbol{B}$ 역시 $\boldsymbol{R}$ 만큼 회전된 상태로 존재할 수 있다.
3.결과적으로 관측 데이터 $\boldsymbol{x}$ 가 나타날 확률(우도, Likelihood)은 $\boldsymbol{R}$ 의 값에 영향을 받지 않는다.
따라서 $\boldsymbol{R}$ 을 곱해도 관측 공간의 데이터 공분산 구조( $\boldsymbol{B}\boldsymbol{B}^\top$ )는 변하지 않는다. 이는 $\boldsymbol{B}_{ML}$ 의 해가 유일하지 않으며, 특정 방향으로 고정된 것이 아니라 직교 변환(회전)에 대해서만 유일함을 수학적으로 명시하기 위해 $\boldsymbol{R}$ 을 포함하는 것이다. 즉, 어떤 주성분(축)을 찾았을 때, 그 성분들이 이루는 $M$ 차원 평면은 유일하지만, 그 평면 위에서 $z_1, z_2, \dots$ 축을 어떤 각도로 놓을지는 선택사항이라는 것이다. 보통 계산의 편의를 위해 $\boldsymbol{R} = \boldsymbol{I}$ 로 두어 고유벡터 방향과 잠재 축의 방향을 일치시키지만, 일반적인 해의 형태를 정의할 때는 반드시 이 임의의 회전 성분을 고려해야 한다.
회전행렬을 곱했을 때 주성분들의 축이 어떻게 변하는가?
R로 주 부분공간을 변환함으로써 잠재 공간의 얽힘을 풀 수 있는가?(선형 얽힘에 한해)
$\quad$ (10.77)에 주어진 $\boldsymbol{\mu}$ 의 최대 우도 추정치는 데이터의 표본 평균이다. (10.79)에 주어진 관측 노이즈 분산 $\sigma^2$ 의 최대 우도 추정치는 주 부분공간의 직교 여공간에서의 평균 분산이다. 즉, 처음 $M$ 개의 주성분으로 포착할 수 없는 평균 잔여 분산이 관측 노이즈로 취급된다.
$\to$ 선택된 $M$ 개의 고윳값 중 어떤 것도 나머지 고윳값들의 평균( $\sigma^2$ )보다 작아질 수 없다( $\lambda_i - \sigma^2 \ge 0$ ).
데이터 공분산 행렬 $\boldsymbol{S}$ 의 고윳값들은 관측 공간의 각 주성분 축 방향으로의 분산을 의미하며, 크기순으로 정렬하여 표기하는 것이 일반적이다.
이때 $\lambda_1, \dots, \lambda_M$ 까지 선택한 주성분(신호) 영역이며, $\lambda_{M+1}, \dots, \lambda_D$ 는 버린 나머지(노이즈) 영역이다.
식 10.79에서 정의한 $\sigma^2$ 은 버려진 $D-M$ 개 고윳값들의 산술 평균이다.
어떤 집합의 평균은 반드시 그 집합의 최댓값보다 작거나 같고, 최솟값보다 크거나 같다.
따라서 $\lambda_1, \dots, \lambda_{M-1}$ 역시 $\sigma^2$ 보다 크다.
따라서 행렬 $\boldsymbol{\Lambda} - \sigma^2 \boldsymbol{I}$ 이 양의 준정부호임이 보장된다.
$\quad$ 노이즈가 없는 극한인 $\sigma \to 0$ 인 상황에서, PPCA와 PCA는 동일한 해를 제공한다. 데이터 공분산 행렬 $\boldsymbol{S}$ 는 대칭 행렬이므로 대각화가 가능하며(4.4절 참조), 따라서 다음과 같은 $\boldsymbol{S}$ 의 고유벡터 행렬 $\boldsymbol{T}$ 가 존재한다.
PPCA 모델에서 데이터 공분산 행렬은 가우시안 우도 $p(\boldsymbol{x} ,\vert , \boldsymbol{B}, \boldsymbol{\mu}, \sigma^2)$ 의 공분산 행렬이며, 이는 $\boldsymbol{B} \boldsymbol{B}^\top + \sigma^2 \boldsymbol{I}$ 이다((10.70b) 참조). $\sigma \to 0$ 에 대해 우리는 $\boldsymbol{B} \boldsymbol{B}^\top$ 를 얻으며, 이 데이터 공분산은 반드시 PCA 데이터 공분산(및 (10.80)에 주어진 분해)과 같아야 한다. 따라서 다음이 성립한다.
즉, 우리는 $\sigma = 0$ 에 대해 (10.78)에서의 최대 우도 추정치를 얻는다. (10.78)과 (10.80)으로부터 (P)PCA가 데이터 공분산 행렬의 분해를 수행한다는 점이 명확해진다.
$\to$ 앞서 우리가 선택한 주성분이 $M$ 개 이므로 $\boldsymbol{B}$ 는 $D \times M$ 행렬이다. 이때 $M < D$ 인 상황에서 $\boldsymbol{BB}^\top$ 의 rank는 최대 $M$ 일 수밖에 없으므로 일반적인 데이터 공분산 행렬 $\boldsymbol{S}$ 와 $\boldsymbol{BB}^\top$ 가 완전히 같아지는 것은 랭크의 차이 때문에 불가능해 보인다.
그러나 만약 $\sigma = 0$ 이라면, 모델은 $M$ 차원 주 부분공간 밖의 모든 고윳값( $\lambda_{M+1}, \dots, \lambda_D$ )이 0이라고 가정하는 셈이다. 이 경우 $\boldsymbol{S}$ 의 랭크는 $M$ 이 되고 $\boldsymbol{S} = \boldsymbol{BB}^\top$ 이 성립한다.
$\quad$ 데이터가 순차적으로 도착하는 스트리밍 환경에서는 최대 우도 추정을 위해 반복적인 기대값 최대화(EM) 알고리즘을 사용하는 것이 권장된다(Roweis, 1998).
$\quad$ 잠재 변수의 차원(코드의 길이, 데이터를 투영하는 저차원 부분공간의 차원)을 결정하기 위해, Gavish와 Donoho(2014)는 데이터의 노이즈 분산 $\sigma^2$ 을 추정할 수 있다면 $\frac{4 \sigma \sqrt{D}}{\sqrt{3}}$ 보다 작은 모든 특이값(singular values)을 버려야 한다는 휴리스틱을 제안한다. 대안적으로, 데이터의 고유 차원에 대한 좋은 추정치를 결정하기 위해 (중첩된) 교차 검증(8.6.1절)이나 베이지안 모델 선택 기준(8.6.2절에서 논의됨)을 사용할 수 있다(Minka, 2001b).
$\quad$ 9장에서의 선형 회귀에 대한 논의와 유사하게, 우리는 모델의 파라미터에 사전 분포를 설정하고 이를 적분하여 제거할 수 있다. 그렇게 함으로써 우리는 (a) 파라미터의 점 추정과 그에 따르는 문제들(8.6절 참조)을 피할 수 있고, (b) 잠재 공간의 적절한 차원 $M$ 을 자동으로 선택할 수 있게 된다. Bishop(1999)에 의해 제안된 이 베이지안 PCA(Bayesian PCA)에서는 모델 파라미터에 대해 사전 분포 $p(\boldsymbol{\mu}, \boldsymbol{B}, \sigma^2)$ 가 설정된다. 생성 과정에서 우리는 모델 파라미터에 대해 조건화를 하는 대신 이를 적분하여 제거하며, 이는 과적합 문제를 해결한다. 이 적분은 분석적으로 계산이 불가능하기 때문에, Bishop(1999)은 MCMC나 변분 추론(variational inference)과 같은 근사 추론 방법을 사용할 것을 제안한다. 이러한 근사 추론 기술에 대한 자세한 내용은 Gilks 등(1996)과 Blei 등(2017)의 연구를 참조하라.
$\quad$ PPCA에서 우리는 모든 관측 차원이 동일한 양의 노이즈에 의해 영향을 받는 사전 분포 $p(\boldsymbol{z}_n) = \mathcal{N}(\mathbf{0}, \boldsymbol{I})$ 를 가진 선형 모델 $p(\boldsymbol{x}_n \vert \boldsymbol{z}_n) = \mathcal{N}(\boldsymbol{x}_n \vert \boldsymbol{Bz}_n + \boldsymbol{\mu}, \sigma^2 \boldsymbol{I})$ 를 고려했다. 만약 우리가 각 관측 차원 $d$ 가 서로 다른 분산 $\sigma_d^2$ 을 갖도록 허용한다면, 우리는 요인 분석(factor analysis, FA)을 얻게 된다. 이는 FA가 PPCA보다 우도에 더 많은 유연성을 부여함을 의미하지만, 여전히 데이터가 모델 파라미터 $\boldsymbol{B}, \boldsymbol{\mu}$ 에 의해 설명되도록 강제한다. 그러나 FA는 더 이상 닫힌 형식(closed-form)의 최대 우도 해를 허용하지 않으므로, 모델 파라미터를 추정하기 위해 기대값 최대화(EM) 알고리즘과 같은 반복적인 체계를 사용할 필요가 있다. PPCA에서는 모든 정지점(stationary points)이 전역 최적점(global optima)인 반면, FA에서는 이것이 더 이상 유지되지 않는다. PPCA와 비교했을 때, FA는 데이터를 스케일링하더라도 변하지 않지만, 데이터를 회전시키면 서로 다른 해를 반환한다.
$\quad$ PCA와 밀접하게 연관된 또 다른 알고리즘은 독립 성분 분석(independent component analysis, ICA)이다. 잠재 변수 관점인 $p(\boldsymbol{x}_n \vert \boldsymbol{z}_n) = \mathcal{N}(\boldsymbol{x}_n \vert \boldsymbol{Bz}_n + \boldsymbol{\mu}, \sigma^2 \boldsymbol{I})$ 에서 다시 시작하여, 이제 $\boldsymbol{z}_n$ 에 대한 사전 분포를 비가우시안(non-Gaussian) 분포로 변경한다. ICA는 눈먼 소스 분리(blind-source separation)에 사용될 수 있다. 당신이 많은 사람이 이야기하고 있는 붐비는 기차역에 있다고 상상해 보라. 당신의 귀는 마이크 역할을 하며, 기차역 내의 서로 다른 음성 신호들을 선형적으로 혼합한다. 눈먼 소스 분리의 목표는 혼합된 신호의 구성 요소들을 식별하는 것이다. 앞서 PPCA의 최대 우도 추정 문맥에서 논의했듯이, 원래의 PCA 해는 어떠한 회전에도 불변한다. 그러므로 PCA는 신호들이 존재하는 최적의 저차원 부분공간을 식별할 수는 있지만, 신호 그 자체를 식별할 수는 없다. ICA는 잠재 소스에 대한 사전 분포 $p(\boldsymbol{z})$ 를 비가우시안 사전 분포가 되도록 수정함으로써 이 문제를 해결한다.
$\quad$ PCA, 요인 분석, 그리고 ICA는 선형 모델을 이용한 차원 축소의 세 가지 예시이다. Cunningham과 Ghahramani (2015)는 선형 차원 축소에 대한 더 넓은 조사를 제공한다.
$\quad$ 우리가 여기서 논의한 (P)PCA 모델은 몇 가지 중요한 확장을 허용한다. 10.5절에서 우리는 입력 차원 $D$ 가 데이터 포인트의 수 $N$ 보다 상당히 클 때 PCA를 수행하는 방법을 설명했다. PCA가 (많은) 내적을 계산함으로써 수행될 수 있다는 통찰을 활용하면, 무한 차원의 특징을 고려함으로써 이 아이디어를 극한으로 밀어붙일 수 있다. 커널 트릭(kernel trick)은 커널 PCA의 기초이며, 우리가 무한 차원의 특징들 사이의 내적을 암시적으로 계산할 수 있게 해준다.
$\quad$ PCA에서 유도된 비선형 차원 축소 기술들이 존재한다. 우리가 이 절의 앞부분에서 논의했던 PCA의 오토인코더 관점은 PCA를 심층 오토인코더(deep auto-encoder)의 특수한 사례로 표현하는 데 사용될 수 있다. 심층 오토인코더에서 인코더와 디코더는 모두 다층 피드포워드 신경망으로 표현되며, 이들은 그 자체로 비선형 매핑이다. 만약 우리가 이 신경망들의 활성화 함수를 항등 함수로 설정하면 모델은 PCA와 동일해진다. 비선형 차원 축소에 대한 다른 접근 방식은 Lawrence (2005)에 의해 제안된 가우시안 프로세스 잠재 변수 모델(GP-LVM)이다. GP-LVM은 PPCA를 유도하는 데 사용했던 잠재 변수 관점에서 시작하여, 잠재 변수 $\boldsymbol{z}$ 와 관측치 $\boldsymbol{x}$ 사이의 선형 관계를 가우시안 프로세스(GP)로 대체한다. 매핑의 파라미터를 추정하는 대신(PPCA에서 하듯이), GP-LVM은 모델 파라미터를 적분하여 제거하고 잠재 변수 $\boldsymbol{z}$ 에 대한 점 추정을 수행한다. 베이지안 PCA와 유사하게, Titsias와 Lawrence (2010)에 의해 제안된 베이지안 GP-LVM은 잠재 변수 $\boldsymbol{z}$ 에 대한 분포를 유지하고 근사 추론을 사용하여 이를 적분하여 제거한다.
요인 분석, ICA, GP-LVM