모델 선택
기계 학습에서 우리는 종종 모델의 성능에 결정적인 영향을 미치는 높은 수준의 모델링 결정을 내려야 한다. 우리가 내리는 선택(예: 우도 함수의 형태)은 모델 내 자유 매개변수(free parameters)의 수와 유형에 영향을 미치며, 따라서 모델의 유연성(flexibility)과 표현력(expressivity)에도 영향을 준다. 더 복잡한 모델은 더 많은 데이터 세트를 설명하는 데 사용될 수 있다는 의미에서 더 유연하다. 예를 들어, 차수가 1인 다항식(직선 $y = a_0 + a_1x$ )은 입력 $x$ 와 관측값 $y$ 사이의 선형 관계를 설명하는 데만 사용될 수 있다. 차수가 2인 다항식은 입력과 관측값 사이의 2차(quadratic) 관계를 추가로 설명할 수 있다.
다항식 $y = a_0 + a_1x + a_2x^2$ 은 $a_2 = 0$ 으로 설정하여 선형 함수도 설명할 수 있다. 즉, 1차 다항식보다 엄밀히 말해 더 표현력이 뛰어나다.
$\quad$ 이제 사람들은 매우 유연한 모델이 더 표현력이 좋기 때문에 일반적으로 단순한 모델보다 선호될 것이라고 생각할 것이다. 일반적인 문제는 훈련 시에는 모델의 성능을 평가하고 매개변수를 학습하기 위해 오직 훈련 세트(training set)만 사용할 수 있다는 것이다. 그러나 훈련 세트에서의 성능은 우리가 진정으로 관심 있는 것이 아니다. 8.3절에서 우리는 특히 훈련 데이터 세트가 작을 때 최대 우도 추정이 과적합(overfitting)으로 이어질 수 있음을 보았다. 이상적으로 우리 모델은 훈련 시에는 사용할 수 없는 테스트 세트(test set)에서도 (마찬가지로) 잘 작동해야 한다. 그러므로 우리는 모델이 본 적 없는 테스트 데이터에 어떻게 일반화(generalize)되는지 평가하기 위한 몇 가지 메커니즘이 필요하다. 모델 선택(Model selection)은 정확히 이 문제와 관련이 있다.
8.6.1 Nested Cross-Validation
중첩 교차 검증
우리는 8.2.4절에서 모델 선택에 사용될 수 있는 접근법(교차 검증)을 이미 보았다. 교차 검증은 데이터 세트를 훈련 세트와 검증 세트로 반복적으로 분할함으로써 일반화 오차의 추정치를 제공한다는 것을 상기하자. 우리는 이 아이디어를 한 번 더 적용할 수 있다. 즉, 각 분할에 대해 또 다른 라운드의 교차 검증을 수행할 수 있다. 이것은 종종 중첩 교차 검증(nested cross-validation)이라고 불린다; 그림 8.13 참조.
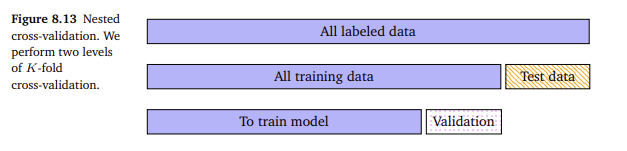
그림 8.13 중첩 교차 검증. 우리는 두 레벨의 $K$ -폴드 교차 검증을 수행한다.
내부 레벨(inner level)은 내부 검증 세트에서 특정 모델 선택이나 하이퍼파라미터의 성능을 추정하는 데 사용된다. 외부 레벨(outer level)은 내부 루프에 의해 선택된 최적의 모델에 대한 일반화 성능을 추정하는 데 사용된다. 우리는 내부 루프에서 다양한 모델 및 하이퍼파라미터 선택을 테스트할 수 있다. 두 레벨을 구별하기 위해, 일반화 성능을 추정하는 데 사용되는 세트를 흔히 테스트 세트(test set)라 부르고, 최적의 모델을 선택하는 데 사용되는 세트를 검증 세트(validation set)라고 부른다. 내부 루프는 주어진 모델에 대한 일반화 오차의 기댓값을 검증 세트에서의 경험적 오차를 사용하여 근사함으로써 추정한다 (8.39), 즉,
여기서 $\mathbf{R}(\mathcal{V} \mid M)$ 은 모델 $M$ 에 대한 검증 세트 $\mathcal{V}$ 에서의 경험적 위험(empirical risk, 예: 평균 제곱근 오차)이다. 우리는 모든 모델에 대해 이 절차를 반복하고 가장 성능이 좋은 모델을 선택한다. 교차 검증은 우리에게 예상되는 일반화 오차를 제공할 뿐만 아니라, 평균 추정치가 얼마나 불확실한지에 대한 추정치인 표준 오차와 같은 고차 통계량도 얻을 수 있게 해 준다는 점에 유의하라. 모델이 선택되면, 우리는 테스트 세트에서 최종 성능을 평가할 수 있다.
표준 오차는 $\frac{\sigma}{\sqrt{K}}$ 로 정의되며, 여기서 $K$ 는 실험 횟수이고 $\sigma$ 는 각 실험의 위험에 대한 표준 편차이다.
$\to$ 데이터 세트 $\mathcal{V}$ 안에 $N$ 개의 데이터( $x_i$ , $y_i$ )가 있다고 할 때, $\mathbf{R}$ 은 각 데이터에 대해 손실( $L$ )의 합을 평균내는 함수이다.
$\to$ 표준 오차는 왜 $\frac{\sigma}{\sqrt{K}}$ 인가?
먼저 표준 편차( $\sigma$ )는 개별 실험 결과( $X$ )들의 퍼짐 정도이고, 표준 오차(standard error, SE)는 우리가 구한 ‘평균값( $\bar{X}$ )’ 자체의 퍼짐 정도를 나타낸다.
교차 검증을 $K$ 번 수행하여 얻은 각각의 오차 점수를 확률 변수 $X_1, X_2, \dots, X_K$ 라고 하자. 이 개별 점수들의 분산을 $\sigma^2$ (표준 편차는 $\sigma$ )이라고 가정한다. 종국에 우리가 계산할 것은 모델의 평균 점수( $\bar{X}$ )이며, 이는 식 8.39의 우변과 같다.
이 $\bar{X}$ 의 분산과 표준 편차를 구해보려 한다.
먼저 분산의 성질 두가지를 리마인드하면, 확률 변수에 상수 $a$ 를 곱한 후 분산을 구하면, 상수는 제곱이 되어 밖으로 나온다.
또한 확률 변수들이 서로 독립이라면, 공분산이 0이므로 합의 분산은 분산의 합과 같다.
$\bar{X}$ 의 분산은 다음과 같다.
이때 $\frac{1}{K}$ 는 상수이므로
또한 각 교차 검증의 결과값들은 모두 통계적으로 독립이다(independent).
또한 각각의 개별 분산 $Var(X_i)$ 는 $\sigma^2$ 으로 같다(identically distributed).
따라서 평균 점수의 표준 편차(오차)는 다음과 같다.
8.6.2 Bayesian Model Selection
베이지안 모델 선택
모델 선택에는 여러 가지 접근법이 있으며, 그중 일부를 이 절에서 다룬다. 일반적으로 이들은 모두 모델의 복잡도(complexity)와 데이터 적합도(data fit) 사이의 균형을 맞추려 시도한다. 우리는 단순한 모델이 복잡한 모델보다 과적합될 가능성이 낮다고 가정하며, 따라서 모델 선택의 목표는 데이터를 합리적으로 잘 설명하는 가장 단순한 모델을 찾는 것이다. 이 개념은 오컴의 면도날(Occam’s razor)이라고도 알려져 있다.
Remark. 만약 우리가 모델 선택을 가설 검정 문제로 취급한다면, 우리는 데이터와 일치하는 가장 단순한 가설을 찾고 있는 것이다(Murphy, 2012).
$\quad$ 단순한 모델을 선호하는 모델에 사전 확률(prior)을 부여하는 것을 고려할 수도 있다. 그러나 이렇게 할 필요는 없다. 베이지안 확률의 적용에는 “자동화된 오컴의 면도날(automatic Occam’s Razor)”이 정량적으로 구현되어 있기 때문이다(Smith and Spiegelhalter, 1980; Jefferys and Berger, 1992; MacKay, 1992). MacKay(2003)에서 차용한 그림 8.14는 왜 복잡하고 매우 표현력이 뛰어난 모델이 주어진 데이터 세트 $\mathcal{D}$ 를 모델링하는 데 덜 그럴듯한(less probable) 선택이 될 수 있는지에 대한 기본적인 직관을 제공한다.
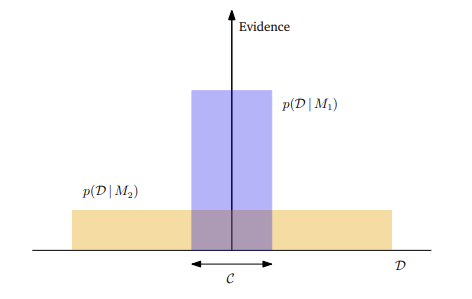
그림 8.14 베이지안 추론은 오컴의 면도날을 구현한다. 가로축은 모든 가능한 데이터 세트 $\mathcal{D}$ 의 공간을 설명한다. 증거(세로축)는 모델이 사용 가능한 데이터를 얼마나 잘 예측하는지 평가한다. $p(\mathcal{D} \mid M_i)$ 는 적분하여 1이 되어야 하므로, 우리는 가장 큰 증거를 가진 모델을 선택해야 한다.
가로축이 모든 가능한 데이터 세트 $\mathcal{D}$ 의 공간을 나타낸다고 생각해 보자. 만약 우리가 데이터 $\mathcal{D}$ 가 주어졌을 때 모델 $M_i$ 의 사후 확률 $p(M_i \mid \mathcal{D})$ 에 관심이 있다면, 베이즈 정리를 사용할 수 있다. 모든 모델에 대해 균등 사전 확률(uniform prior) $p(M)$ 을 가정하면, 베이즈 정리는 발생한 데이터를 얼마나 잘 예측했는지에 비례하여 모델에 보상을 준다. 모델 $M_i$ 가 주어졌을 때 데이터에 대한 이러한 예측, 즉 $p(\mathcal{D} \mid M_i)$ 를 $M_i$ 에 대한 증거(evidence)라고 부른다.
이러한 예측들은 $\mathcal{D}$ 에 대한 정규화된 확률 분포에 의해 정량화된다. 즉, 적분/합이 1이 되어야 한다.
단순한 모델 $M_1$ 은 적은 수의 데이터 세트만을 예측할 수 있으며, 이는 $p(\mathcal{D} \mid M_1)$ 로 나타난다. 반면 $M_1$ 보다 더 많은 자유 매개변수를 가지는 등 더 강력한 모델 $M_2$ 는 더 다양한 데이터 세트를 예측할 수 있다. 그러나 이것은 $M_2$ 가 영역 $\mathcal{C}$ 에 있는 데이터 세트를 $M_1$ 만큼 잘 예측하지 못한다는 것을 의미한다. 두 모델에 동일한 사전 확률이 할당되었다고 가정해 보자. 그렇다면 데이터 세트가 영역 $\mathcal{C}$ 에 속할 경우, 덜 강력한 모델 $M_1$ 이 더 그럴듯한(probable) 모델이 된다.
$\quad$ 이 장의 앞부분에서 우리는 모델이 데이터를 설명할 수 있어야 한다고, 즉 주어진 모델로부터 데이터를 생성할 수 있는 방법이 있어야 한다고 주장했다. 더 나아가, 만약 모델이 데이터로부터 적절히 학습되었다면, 생성된 데이터는 경험적 데이터와 유사해야 할 것으로 기대한다. 이를 위해 모델 선택을 계층적 추론 문제(hierarchical inference problem)로 표현하는 것이 도움이 되며, 이를 통해 모델들에 대한 사후 분포를 계산할 수 있다.
$\quad$ 각각 매개변수 $\boldsymbol{\theta}_k$ 를 가지는 유한한 개수의 모델 집합 $\mathcal{M} = {M_1, \dots, M_K}$ 를 고려해 보자. 베이지안 모델 선택에서는 모델들의 집합에 사전 확률 $p(M)$ 을 부여한다. 이 모델로부터 데이터를 생성할 수 있게 해 주는 대응하는 생성 과정(generative process)은 다음과 같으며, 그림 8.15에 묘사되어 있다.
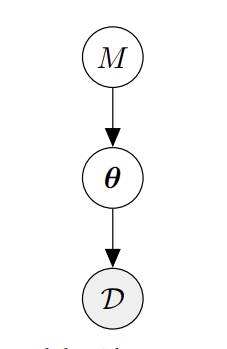
그림 8.15 베이지안 모델 선택에서의 계층적 생성 과정 묘사. 모델들의 집합에 사전 확률 $p(M)$ 을 부여한다. 각 모델에 대해, 대응하는 모델 매개변수에 대한 분포 $p(\boldsymbol{\theta} \mid M)$ 가 존재하며, 이는 데이터 $\mathcal{D}$ 를 생성하는 데 사용된다. (그래프 구조: $M$ (빈 노드) $\rightarrow \boldsymbol{\theta}$ (빈 노드) $\rightarrow \mathcal{D}$ (색칠된 노드))
훈련 세트 $\mathcal{D}$ 가 주어졌을 때, 우리는 베이즈 정리를 적용하여 모델들에 대한 사후 분포를 다음과 같이 계산한다.
이 사후 확률은 더 이상 모델 매개변수 $\boldsymbol{\theta}_k$ 에 의존하지 않는다는 점에 유의하라. 베이지안 설정에서는 다음 식과 같이 매개변수들이 적분되어 사라졌기(integrated out) 때문이다.
여기서 $p(\boldsymbol{\theta}_k \mid M_k)$ 는 모델 $M_k$ 의 매개변수 $\boldsymbol{\theta}_k$ 에 대한 사전 분포이다. 항 (8.44)를 모델 증거(model evidence) 또는 주변 우도(marginal likelihood)라고 부른다. (8.43)의 사후 확률로부터 우리는 다음과 같이 MAP(최대 사후 확률) 추정치를 결정한다.
모든 모델에 동등한 (사전) 확률을 부여하는 균등 사전 확률 $p(M_k) = \frac{1}{K}$ 를 사용하면, 모델들에 대한 MAP 추정치를 결정하는 것은 결국 모델 증거 (8.44)를 최대화하는 모델을 고르는 것과 같아진다.
Remark (우도와 주변 우도). 우도(likelihood)와 주변 우도(marginal likelihood, 즉 증거) 사이에는 몇 가지 중요한 차이점이 있다. 우도는 과적합되기 쉬운 반면, 주변 우도는 일반적으로 그렇지 않은데, 이는 모델 매개변수들이 주변화되어 사라졌기 때문이다 (즉, 우리는 더 이상 매개변수를 적합시킬 필요가 없다). 더 나아가, 주변 우도는 모델 복잡도와 데이터 적합도 사이의 트레이드오프(오컴의 면도날)를 자동으로 구현한다.
$\to$ MLE는 관측된 데이터 $\mathcal{D}$ 를 가장 잘 설명하는(우도를 최대화하는) 한 점( $\hat{\boldsymbol{\theta}}_{MLE}$ )을 찾는 것이다.
이는 데이터 지점에 우도를 끌어올려 피크(peak)를 형성하여 과적합이 발생한다.
반면, MAP는 매개변수 $\boldsymbol{\theta}$ 역시 불확실성을 가진 확률 변수로 두고, 이 확률 변수가 이런 분포를 따를 것이라고 사전에 가정한다. 따라서 어떤 매개변수가 주어졌을 때 데이터가 튀어나올 우도와 사전 확률( $p(\boldsymbol{\theta})$ 의 곱을 최대화한다.
이는 기하학적으로, 우도를 최대화하여 극단적으로 형성된 피크들을 가지는 함수가 아래쪽으로 눌러 보다 부드럽고 완만한 지형을 만든다(전체 공간의 적분이 1이 되도록 만드는 것은 분자를 적분한 정규화 상수로 나누었을 때)
그러나 MAP역시 결국 단 하나의 점(arg max)을 찾는 방식이다. 분모에 $p(\mathcal{D})$ 는 $\boldsymbol{\theta}$ 와 무관한 상수이므로, MAP 점 추정을 할 때 이 적분을 수행하여 $p(\mathcal{D})$ 를 구할 필요가 없다.
다루기 힘든 우도와 사전 확률의 곱의 적분(주변 우도, evidence)는 단일 모델의 점 추정이 아닌, 여러 개의 모델 중 가장 좋은 모델을 선택할 때 등장한다. 이는 매개변수에 대해 정적분하여 어떤 구조의 모델이 데이터에 가장 적합한지를 판단한다.
이 모델 선택 과정은 학습 전에 진행되는데, 학습하기 전에 어떻게 ‘좋은’모델을 선택할까?
우도와 사전확률의 곱은 기하학적으로 두 함수가 같은 축을 공유한다.
8.6.3 Bayes Factors for Model Comparison
모델 비교를 위한 베이즈 요인
데이터 세트 $\mathcal{D}$ 가 주어졌을 때, 두 확률 모델 $M_1$ 과 $M_2$ 를 비교하는 문제를 고려해 보자. 사후 확률 $p(M_1 \mid \mathcal{D})$ 와 $p(M_2 \mid \mathcal{D})$ 를 계산한다면, 우리는 다음과 같이 사후 확률의 비(ratio)를 계산할 수 있다.
사후 확률의 비는 posterior odds이라고도 불린다. (8.46)의 우변 첫 번째 분수인 사전 비(prior odds)은 우리의 사전(초기) 믿음이 $M_2$ 에 비해 $M_1$ 을 얼마나 더 선호하는지를 측정한다. 주변 우도들의 비(우변의 두 번째 분수)는 베이즈 요인(Bayes factor)이라 불리며, $M_2$ 와 비교하여 $M_1$ 이 데이터 $\mathcal{D}$ 를 얼마나 잘 예측하는지를 측정한다.
$\to$ odds란 어떤 사건이 일어날 확률을 일어나지 않을 확률로 나눈 값 $\frac{p}{1-p}$ 이다. 사건 $A$ 가 일어날 확률을 $P(A)$ 라고 할 때, odds는 다음과 같다.
odds는 게임을 예로 들었을 때, 패배한 횟수 대비 승리한 횟수의 비율, 즉 실패 대피 성공의 비율이다.
이는 ‘승률’과 유사하지만 다른데, 만약 10번 싸워서 8번 이기고 2번 졌다면, 승률은 80% (0.8) 이지만, odds는 4 (또는 4:1) 가 된다.
만약 모델이 2개( $M_1$ 과 $M_2$ )뿐이라고 가정한다면, $M_1$ 이 정답이 아닐 확률은 곧 $M_2$ 가 정답일 확률이 된다. 즉, $P(M_2) = 1 - P(M_1)$ 이다.
식 (8.46)의 우변 또한 같은 맥락으로 유도할 수 있다.
이처럼 두 사후 확률을 odds로 표현함으로써 다루기 힘든 $p(\mathcal{D})$ 를 제거할 수 있다.
Remark. 제프리스-린들리 역설(Jeffreys-Lindley paradox)은 “퍼진 사전 확률(diffuse prior)을 가진 복잡한 모델 하에서 데이터가 나타날 확률은 매우 작아지기 때문에, 베이즈 요인은 항상 더 단순한 모델을 선호한다”고 명시한다 (Murphy, 2012). 여기서 퍼진 사전 확률이란 특정 모델을 선호하지 않는 사전 확률, 즉 이 사전 확률 하에서는 많은 모델들이 선험적으로 그럴듯하다고 간주되는 넓은 분포를 의미한다.
$\quad$ 만약 모델들에 대해 균등 사전 확률(uniform prior)을 선택한다면, (8.46)의 사전 비 항은 1이 된다. 즉, 사후 비는 다음과 같이 주변 우도들의 비(베이즈 요인)와 같아진다.
베이즈 요인이 1보다 크면 우리는 모델 $M_1$ 을 선택하고, 그렇지 않으면 모델 $M_2$ 를 선택한다. 빈도주의 통계학과 유사한 방식으로, 결과의 “유의성(significance)”을 고려하기 전에 이 비율의 크기에 대해 참고해야 할 가이드라인이 존재한다 (Jeffreys, 1961).
$\to$ 만약 베이즈 요인이 1.02가 나왔다고 해보자. 이때 $M_1$ 이 $M_2$ 보다 좋다고 확신할 수 있는가? 그냥 데이터의 우연한 노이즈 때문에 높게 나왔음을 생각해볼 수 있다.
이때 빈도주의 통계학은 p-value가 0,049면 통과, 0.051이면 탈락이라는 관습적인 선(유의수준 5%)을 그어 판단한다.
이와 유사하게 베이즈 요인이 얼마나 커야 그 결과가 의미있다고 할 수 있는지에 대한 해석 척도가 있다.
Remark (주변 우도의 계산). 주변 우도는 모델 선택에서 중요한 역할을 한다: 우리는 베이즈 요인 (8.46)과 모델들에 대한 사후 분포 (8.43)를 계산해야 한다.
$\quad$ 불행히도, 주변 우도를 계산하는 것은 적분 (8.44)를 푸는 것을 요구한다. 이 적분은 일반적으로 분석적으로 다루기 힘들며(analytically intractable), 수치 적분(numerical integration), 몬테카를로를 이용한 확률적 근사(stochastic approximations), 또는 베이지안 몬테카를로 기법과 같은 근사 기법에 의존해야만 한다.
$\quad$ 하지만, 우리가 이 적분을 풀 수 있는 특수한 경우들이 존재한다. 6.6.1절에서 우리는 켤레 모델(conjugate models)에 대해 논의했다. 만약 우리가 켤레 매개변수 사전 확률(conjugate parameter prior) $p(\boldsymbol{\theta})$ 를 선택한다면, 우리는 주변 우도를 닫힌 형태(closed form)로 계산할 수 있다. 9장 선형 회귀의 맥락에서 우리는 정확히 이 작업을 수행할 것이다.
$\quad$ 우리는 이번 장에서 기계 학습의 기본 개념들에 대한 간략한 소개를 살펴보았다. 이 책의 나머지 부분에서는 8.2, 8.3, 8.4절에서 다룬 학습의 세 가지 갈래가 기계 학습의 네 가지 기둥(회귀, 차원 축소, 밀도 추정, 분류)에 어떻게 적용되는지 보게 될 것이다.
8.6.4 Further Reading
우리는 이 절의 서두에서 모델의 성능에 영향을 미치는 고수준의 모델링 선택(high-level modeling choices)들이 존재한다고 언급했다. 그 예시는 다음과 같다:
- 회귀 설정에서의 다항식의 차수 (degree)
- 혼합 모델(mixture model)에서의 구성 요소(components)의 수
- (심층) 신경망의 네트워크 아키텍처
- 서포트 벡터 머신(SVM)에서의 커널(kernel) 유형
- PCA에서의 잠재 공간(latent space)의 차원 수
- 최적화 알고리즘에서의 학습률(learning rate) 스케줄
Rasmussen과 Ghahramani (2001)는 자동화된 오컴의 면도날이 반드시 모델의 ‘매개변수의 수(number of parameters)’에 페널티를 주는 것은 아니며, 오히려 ‘함수의 복잡도(complexity of functions)’ 측면에서 작동한다는 것을 보여주었다. 그들은 또한 자동화된 오컴의 면도날이 매개변수가 매우 많은 베이지안 비모수 모델(Bayesian nonparametric models, 예: 가우시안 프로세스)에 대해서도 성립함을 보여주었다.
$\quad$ 만약 우리가 최대 우도 추정(MLE)에 초점을 맞춘다면, 과적합을 억제하기 위해 모델 선택에 사용되는 여러 가지 경험적 규칙(heuristics)들이 존재한다. 이들을 정보 기준(information criteria)이라고 부르며, 우리는 이 값이 가장 큰(또는 정의에 따라 가장 작은) 모델을 선택한다. 아카이케 정보 기준 (Akaike information criterion, AIC) (Akaike, 1974)은
매개변수가 많은 복잡한 모델의 과적합을 보상하기 위한 페널티 항을 추가함으로써 최대 우도 추정기의 편향을 보정한다. 여기서 $M$ 은 모델 매개변수의 수이다. AIC는 주어진 모델에 의해 손실된 상대적인 정보를 추정한다.
베이지안 정보 기준 (Bayesian information criterion, BIC) (Schwarz, 1978)은
지수족 분포(exponential family distributions)에 대해 사용될 수 있다. 여기서 $N$ 은 데이터 포인트의 수이고, $M$ 은 매개변수의 수이다. BIC는 AIC보다 모델의 복잡도에 더 무거운 페널티를 부여한다.
$\to$ 식 (8.48)과 (8.49)는 로그 우도 함수를 ‘최대화’하는 관점에서 작성되었기 때문에 페널티를 빼는( $-$ ) 형태로 쓰여 있다. 일반적으로는 손실 함수처럼 ‘최소화’하는 형태로 부호를 반대로 쓰기도 한다.