기계 학습 알고리즘은 컴퓨터 상에서 구현되므로, 그 수학적 공식들은 수치적 최적화 방법(numerical optimization methods)으로 표현된다. 이 장에서는 기계 학습 모델을 훈련시키기 위한 기본적인 수치적 방법들을 설명한다. 기계 학습 모델을 훈련시키는 것은 종종 좋은 매개변수(parameters) 집합을 찾는 것으로 귀결된다. “좋다(good)”는 개념은 목적 함수(objective function)나 확률적 모델에 의해 결정되며, 우리는 이 책의 두 번째 부분에서 그 예시들을 보게 될 것이다. 목적 함수가 주어졌을 때, 최적의 값을 찾는 것은 최적화 알고리즘을 사용하여 수행된다.
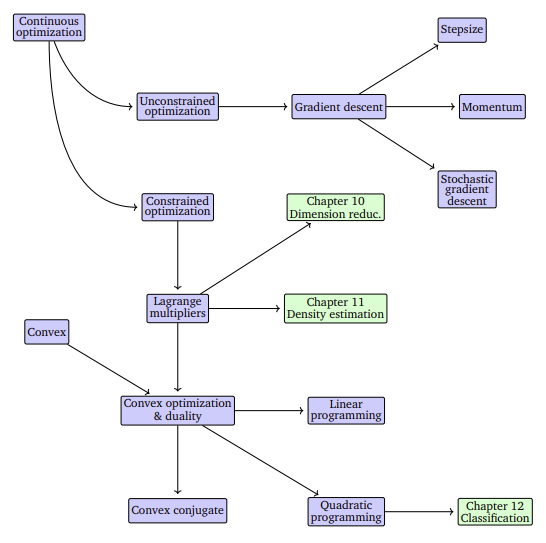
그림 7.1 이 장에서 제시된 최적화와 관련된 개념들의 마인드맵. 두 가지 주요 아이디어가 있다: 경사 하강법(gradient descent)과 볼록 최적화(convex optimization).
$\quad$ 이 장에서는 연속 최적화의 두 가지 주요 분기를 다룬다 (그림 7.1): 제약 없는 최적화(unconstrained optimization)와 제약 있는 최적화(constrained optimization)이다. 우리는 이 장에서 우리의 목적 함수가 미분 가능하다고 가정할 것이며(5장 참조), 따라서 최적값을 찾는 데 도움을 주기 위해 공간의 각 위치에서 기울기(gradient)에 접근할 수 있다. 관례상 기계 학습의 대부분의 목적 함수는 최소화(minimized)되도록 의도된다. 즉, 최적의 값은 최솟값이다. 최적의 값을 직관적으로 찾는 것은 목적 함수의 계곡(valleys)을 찾는 것과 같으며, 기울기는 우리에게 오르막(uphill)을 가리킨다. 아이디어는 내리막(기울기의 반대 방향)으로 이동하여 가장 깊은 지점을 찾기를 바라는 것이다. 제약 없는 최적화의 경우 이것이 우리가 필요로 하는 유일한 개념이지만, 7.1절에서 논의할 몇 가지 설계 선택 사항들이 있다. 제약 있는 최적화의 경우, 제약을 관리하기 위해 다른 개념들을 도입해야 한다 (7.2절). 우리는 또한 전역 최적값(global optimum) 도달에 대해 수학적 진술(statements)을 할 수 있는 특수한 문제 클래스(7.3절의 볼록 최적화 문제, convex optimization problems)도 소개할 것이다.
우리는 $\mathbb{R}^D$ 공간의 데이터와 모델을 고려하기 때문에, 우리가 직면하는 최적화 문제는 이산 변수(discrete variables)를 위한 조합 최적화(combinatorial optimization) 문제와 대조되는 연속 최적화(continuous optimization) 문제이다.
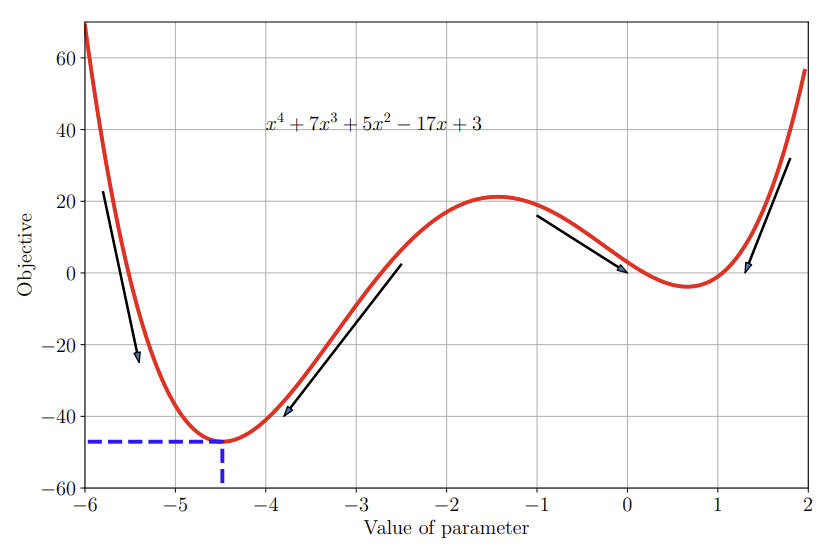
그림 7.2 예제 목적 함수. 음의 기울기(Negative gradients)는 화살표로 표시되며, 전역 최솟값(global minimum)은 파란색 점선으로 표시된다.
$\quad$ 그림 7.2의 함수를 고려해 보자. 이 함수는 $x = -4.5$ 부근에서 대략 $-47$ 의 함수값을 가지는 전역 최솟값(global minimum)을 갖는다. 함수가 “매끄럽기(smooth)” 때문에, 기울기(gradients)는 우리가 오른쪽으로 한 걸음 가야 할지 왼쪽으로 가야 할지를 지시함으로써 최솟값을 찾는 데 도움을 주는 용도로 사용될 수 있다. 이는 우리가 올바른 웅덩이(bowl) 안에 있다고 가정하는데, 왜냐하면 $x = 0.7$ 부근에 또 다른 국소 최솟값(local minimum)이 존재하기 때문이다. 함수의 도함수를 계산하고 그것을 $0$ 으로 설정함으로써 함수의 모든 정류점(stationary points)을 풀 수 있음을 상기하라. (정류점은 도함수의 실근, 즉 기울기가 0인 점들이다.)다음의 함수에 대해,
우리는 대응하는 기울기를 다음과 같이 얻는다.
이것은 3차 방정식이므로, $0$ 으로 설정했을 때 일반적으로 세 개의 해를 갖는다. 이 예제에서 그중 두 개는 최솟값이고 하나는 최댓값( $x = -1.4$ 부근)이다. 어떤 정류점이 최솟값인지 최댓값인지 확인하기 위해, 우리는 도함수를 한 번 더 취하고(두 번 미분하고) 정류점에서 2계 도함수(second derivative)가 양수인지 음수인지를 확인해야 한다. 우리의 경우, 2계 도함수는 다음과 같다.
우리가 시각적으로 추정한 값인 $x = -4.5, -1.4, 0.7$ 을 대입해 보면, 예상대로 중간 지점은 최댓값( $\frac{d^2\ell(x)}{dx^2} < 0$ )이고 다른 두 정류점은 최솟값임을 관찰할 수 있을 것이다.
$\quad$ 앞선 논의에서 우리가 $x$ 값에 대해 해석적으로(analytically) 푸는 것을 피했다는 점에 주목하라. 비록 앞선 예시와 같은 저차 다항식에 대해서는 그렇게 할 수 있었지만 말이다. 일반적으로 우리는 해석적인 해를 찾을 수 없으며, 따라서 어떤 값, 가령 $x_0 = -6$ 에서 시작하여 음의 기울기(negative gradient)를 따라가야 할 필요가 있다. (아벨-루피니(Abel-Ruffini) 정리에 따르면, 5차 이상의 다항식에 대해서는 일반적으로 대수적인 해가 존재하지 않는다.) 음의 기울기는 우리가 오른쪽으로 가야 한다는 것은 알려주지만, 얼마나 멀리 가야 하는지(이것을 스텝 사이즈, step-size라고 부른다)는 알려주지 않는다. 게다가 만약 우리가 오른쪽(예: $x_0 = 0$ )에서 시작했다면, 음의 기울기는 우리를 잘못된 최솟값으로 이끌었을 것이다. 그림 7.2는 $x > -1$ 에 대해 음의 기울기가 그림의 오른쪽에 있는 더 큰 목적 함수값을 가지는 최솟값(국소 최솟값)을 향한다는 사실을 보여준다.
$\quad$ 7.3절에서 우리는 최적화 알고리즘의 시작점에 대한 이러한 까다로운 의존성을 보이지 않는 볼록 함수(convex functions)라고 불리는 함수 클래스에 대해 배울 것이다. 볼록 함수에 대해서는 모든 국소 최솟값이 전역 최솟값이다. (볼록 함수에 대해 모든 국소 최솟값은 전역 최솟값이다.) 기계 학습의 많은 목적 함수들이 볼록하게 설계되는 것으로 밝혀졌으며, 우리는 12장에서 그 예를 보게 될 것이다.
$\quad$ 지금까지 이 장에서의 논의는 1차원 함수에 대한 것이었으며, 여기서 우리는 기울기, 하강 방향, 그리고 최적값의 아이디어를 시각화할 수 있었다. 이 장의 나머지 부분에서 우리는 고차원(high dimensions)에서 동일한 아이디어들을 전개한다. 불행히도 우리는 1차원에서의 개념들만 시각화할 수 있으며, 일부 개념들은 고차원으로 직접 일반화되지 않으므로 읽을 때 약간의 주의가 필요하다.