방향성 그래픽 모델
이 절에서는 확률론적 모델을 명시하기 위한 그래픽 언어인 방향성 그래픽 모델(Directed Graphical Model)을 소개한다. 이것은 확률론적 모델을 작고 간결하게 명시하는 방법을 제공하며, 독자가 확률 변수들 사이의 종속성을 시각적으로 파악할 수 있게 해 준다. 그래픽 모델은 모든 확률 변수에 대한 결합 분포가 오직 이 변수들의 부분집합에만 의존하는 인자(factor)들의 곱으로 어떻게 분해(decompose)될 수 있는지를 시각적으로 포착한다. 8.4절에서 우리는 확률론적 모델의 결합 분포가 사전 확률, 우도, 그리고 사후 확률에 대한 정보를 모두 포함하고 있기 때문에 가장 중요한 핵심 수량임을 확인했다. 그러나 결합 분포 그 자체로는 매우 복잡할 수 있으며, 확률론적 모델의 구조적 속성에 대해 아무것도 알려주지 않는다. 예를 들어, 결합 분포 $p(a, b, c)$ 는 독립 관계에 대해 아무런 정보도 주지 않는다. 이 지점이 바로 그래픽 모델이 활약하는 곳이다. 이 절은 6.4.5절에서 설명된 독립 및 조건부 독립 개념에 의존한다.
$\quad$ 그래픽 모델에서 노드(node)는 확률 변수이다. 그림 8.9(a)에서 노드는 확률 변수 $a, b, c$ 를 나타낸다. 간선(edge)은 변수들 사이의 확률론적 관계, 즉 조건부 확률을 나타낸다.
Remark: 모든 분포가 특정 그래픽 모델의 선택으로 표현될 수 있는 것은 아니다. 이에 대한 논의는 Bishop (2006)에서 찾을 수 있다.
$\quad$ 확률론적 그래픽 모델은 다음과 같은 편리한 속성들을 가진다.
- 확률론적 모델의 구조를 시각화하는 단순한 방법이다.
- 새로운 종류의 통계적 모델을 설계하거나 동기를 부여하는 데 사용될 수 있다.
- 그래프를 검토하는 것만으로도 속성(예: 조건부 독립)에 대한 통찰을 얻을 수 있다.
- 통계적 모델에서의 추론 및 학습을 위한 복잡한 계산을 그래프 조작(graphical manipulations)의 관점에서 표현할 수 있다.
8.5.1 Graph Semantics
그래프 의미론
방향성 그래픽 모델/베이지안 네트워크(Bayesian networks)는 확률론적 모델에서 조건부 종속성(conditional dependencies)을 표현하는 방법이다. 이들은 조건부 확률에 대한 시각적 설명을 제공하며, 따라서 복잡한 상호의존성을 설명하기 위한 단순한 언어를 제공한다. 모듈식(modular) 설명은 계산의 단순화 또한 수반한다. 두 노드(확률 변수) 사이의 방향성 링크(화살표)는 조건부 확률을 나타낸다. 예를 들어, 그림 8.9(a)에서 $a$ 와 $b$ 사이의 화살표는 $a$ 가 주어졌을 때 $b$ 의 조건부 확률 $p(b\vert a)$ 를 제공한다.
추가적인 가정이 있다면, 화살표는 인과 관계(causal relationships)를 나타내는 데 사용될 수 있다 (Pearl, 2009).
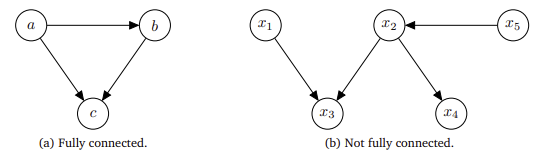
그림 8.9 방향성 그래픽 모델의 예. (a) 완전 연결됨. (b) 완전히 연결되지 않음.
$\quad$ 방향성 그래픽 모델은 결합 분포의 인수분해(factorization)에 대해 무언가를 알고 있다면 결합 분포로부터 도출될 수 있다.
예제 8.7
세 확률 변수 $a, b, c$ 의 결합 분포
를 고려해 보자. (8.29)의 결합 분포 인수분해는 확률 변수들 사이의 관계에 대해 무언가를 알려준다:
-
$c$ 는 $a$ 와 $b$ 에 직접적으로 의존한다.
-
$b$ 는 $a$ 에 직접적으로 의존한다.
-
$a$ 는 $b$ 에도 $c$ 에도 의존하지 않는다.
(8.29)의 인수분해에 대해, 우리는 그림 8.9(a)의 방향성 그래픽 모델을 얻는다.
$\quad$ 일반적으로 우리는 다음과 같이 인수분해된 결합 분포로부터 그에 해당하는 방향성 그래픽 모델을 구성할 수 있다:
- 모든 확률 변수에 대해 노드를 생성한다.
- 각각의 조건부 분포에 대해, 분포가 조건부로 삼고 있는 변수들에 해당하는 노드로부터 그래프에 방향성 링크(화살표)를 추가한다.
그래프의 레이아웃은 결합 분포의 인수분해 선택에 따라 달라진다.
그래프 레이아웃은 결합 분포의 인수분해에 의존한다.
$\quad$ 우리는 결합 분포의 알려진 인수분해로부터 어떻게 해당 방향성 그래픽 모델을 얻는지 논의했다. 이제 우리는 정확히 반대로 수행하여, 주어진 그래픽 모델로부터 확률 변수 집합의 결합 분포를 어떻게 추출하는지 설명할 것이다.
예제 8.8
그림 8.9(b)의 그래픽 모델을 살펴보면, 우리는 두 가지 속성을 활용한다:
-
우리가 찾는 결합 분포 $p(x_1, \dots, x_5)$ 는 그래프의 각 노드당 하나씩, 조건부 확률들의 집합의 곱이다. 이 특정 예제에서 우리는 다섯 개의 조건부 확률이 필요할 것이다.
-
각각의 조건부 확률은 그래프에서 해당 노드의 부모(parents)들에게만 의존한다. 예를 들어, $x_4$ 는 $x_2$ 를 조건으로 할 것이다.
이 두 가지 속성은 결합 분포의 원하는 인수분해를 산출한다.
$\quad$ 일반적으로 결합 분포 $p(\mathbf{x}) = p(x_1, \dots, x_K)$ 는 다음과 같이 주어진다.
여기서 $\text{Pa}_k$ 는 “ $x_k$ 의 부모 노드들”을 의미한다. $x_k$ 의 부모 노드는 $x_k$ 를 가리키는 화살표를 가진 노드들이다.
$\quad$ 우리는 이 소관을 동전 던지기 실험의 구체적인 예제로 마무리한다. 이 실험의 결과 $x$ 가 “앞면”일 확률이 다음과 같은 베르누이 실험(예제 6.8)을 고려해 보자.
이제 우리는 이 실험을 $N$ 번 반복하여 결과 $x_1, \dots, x_N$ 을 관측하고, 결합 분포를 얻는다.
우변의 식은 실험들이 독립적이기 때문에 각각의 개별 결과에 대한 베르누이 분포들의 곱이다. 6.4.5절에서 통계적 독립성은 분포가 인수분해됨을 의미한다는 것을 상기하자. 이 환경에 대한 그래픽 모델을 작성하기 위해, 우리는 관측되지 않은/잠재 변수와 관측된 변수를 구별한다.
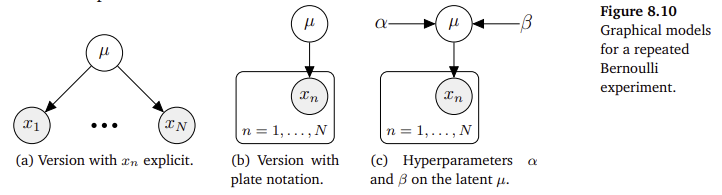
그래픽으로, 관측된 변수는 음영 처리된 노드로 표시되며, 따라서 그림 8.10(a)의 그래픽 모델을 얻는다. 결과 $x_n$ 이 동일하게 분포되어 있으므로 단일 매개변수 $\mu$ 가 모든 $x_n, n = 1, \dots, N$ 에 대해 동일함을 알 수 있다. 이 환경에 대한 더 간결하지만 동등한 그래픽 모델이 그림 8.10(b)에 주어져 있으며, 여기서 우리는 플레이트 표기법(plate notation)을 사용한다. 플레이트(상자)는 그 안에 있는 모든 것(이 경우 관측값 $x_n$ )을 $N$ 번 반복한다. 따라서 두 그래픽 모델은 동등하지만, 플레이트 표기법이 더 간결하다. 그래픽 모델은 우리가 즉시 $\mu$ 에 하이퍼사전확률(hyperprior)을 부여할 수 있게 해 준다. 하이퍼사전확률은 첫 번째 계층 사전 확률의 매개변수에 대한 두 번째 계층의 사전 확률 분포이다. 그림 8.10(c)는 잠재 변수 $\mu$ 에 $\text{Beta}(\alpha, \beta)$ 사전 확률을 부여한다. 만약 우리가 $\alpha$ 와 $\beta$ 를 확률 변수가 아닌 결정론적 매개변수(deterministic parameters)로 취급한다면, 그 주위의 원을 생략한다.
8.5.2 Conditional Independence and d-Separation
조건부 독립과 d-분리
방향성 그래픽 모델은 우리가 단지 그래프를 보는 것만으로도 결합 분포의 조건부 독립성(6.4.5절) 관계 속성을 찾을 수 있게 해 준다. d-분리(d-separation) (Pearl, 1988)라고 불리는 개념이 이것의 핵심이다.
$\quad$ $\mathcal{A}, \mathcal{B}, \mathcal{C}$ 가 임의의 겹치지 않는 노드 집합(이들의 합집합은 그래프의 전체 노드 집합보다 작을 수 있음)인 일반적인 방향성 그래프를 고려해 보자. 우리는 다음과 같이 표기되는 특정한 조건부 독립 진술인 “ $C$ 가 주어졌을 때 $A$ 는 $B$ 와 조건부 독립이다”가 주어진 방향성 비순환 그래프(DAG)에 의해 암시되는지 확인하고자 한다.
이를 위해, 우리는 $\mathcal{A}$ 의 임의의 노드에서 $\mathcal{B}$ 의 임의의 노드로 가는 모든 가능한 경로(트레일, 화살표의 방향을 무시한 경로)를 고려한다. 이러한 경로들 중 다음 중 하나라도 참인 노드를 포함한다면 그 경로는 차단되었다(blocked)고 말한다.
- 경로 상의 화살표가 해당 노드에서 꼬리에 머리(head to tail)로 만나거나 꼬리에 꼬리(tail to tail)로 만나며, 해당 노드가 집합 $\mathcal{C}$ 에 속해 있다.
- 경로 상의 화살표가 해당 노드에서 머리에 머리(head to head)로 만나며, 해당 노드도 그 자손(descendants) 중 어떤 것도 집합 $\mathcal{C}$ 에 속해 있지 않다.
만약 모든 경로가 차단되었다면, $\mathcal{A}$ 는 $\mathcal{C}$ 에 의해 $\mathcal{B}$ 로부터 d-분리되었다고 말하며, 그래프 내의 모든 변수에 대한 결합 분포는 $\mathcal{A} \perp!!!\perp \mathcal{B} \mid \mathcal{C}$ 를 만족할 것이다.
$\to$ 집합 $\mathcal{C}$ 에 속한다는 것은, 확률 변수 $C$ 가 이미 관측됨을 의미한다. ‘head’나 ‘tail’은 노드 $C$ 를 기준으로, 화살표가 $C$ 에서 어떤 모양인지를 묘사한다. 위에 첫 번째 명제는 (1-1), (2-1)으로, 두 번째 명제는 (3-1)로 예시를 들어보았다.
$\to$ 세 확률 변수 $A, B, C$ 가 있다.
1. head to tail: $A \rightarrow C \rightarrow B$ 에서 $C$ 가 관측되었을 때, $A$ 와 $B$ 는 조건부 독립이다( $A \perp!!!\perp B \mid C$ ).
예를 들어 각 확률 변수를 번개( $A$ ) $\rightarrow$ 천둥소리( $C$ ) $\rightarrow$ 놀라서 잠에서 깸( $B$ )라고 가정한다.
(1-1): $C$ 의 원인은 $A$ 지만, 천둥소리를 들었다( $C$ 관측)면, 잠에서 깨는 것( $B$ )는 번개( $A$ )가 쳤는지 안쳤는지 중요하지 않다.
(1-2): 만약 $C$ 가 관측되지 않은 상황에서, $A$ 를 관측한다면(제 3자가 관측하여) 천둥 소리가 칠 것( $C$ )을 예상할 수 있고, 내가 놀라서 잠에서 깰 수 있을 확률( $B$ )을 높일 수 있다.
2. tail to tail: $A \leftarrow C \rightarrow B$ 에서 $C$ 가 관측되었을 때 $A$ 와 $B$ 는 조건부 독립이다( $A \perp!!!\perp B \mid C$ ).
각 확률 변수를 바이러스( $C$ ) $\rightarrow$ 기침( $A$ ), 열( $B$ )로 가정한다.
(2-1): 만약 환자가 바이러스( $C$ )에 감염되었다는 사실을 알고 있다면, 환자가 기침( $A$ )을 하는지 안하는지 관찰한다고 해서, 열( $B$ )이 날 확률은 변하지 않는다.
(2-2): 그럼 $C$ 가 관측되지 않았을 때는 어떨까? 환자가 바이러스( $C$ )에 감염되었는지 관측이 안된 상황에서, 환자가 기침( $A$ )을 심하게 하는것을 보았을 때, 기침은 바이러스의 증상이므로 “아 이 환자는 바이러스( $C$ )에 걸렸을 확률이 있겠다”하고 관측되지 않은 원인 $C$ 에 대한 확률을 상향 조정할 수 있다. 원인( $C$ )에 대한 확률이 상향되었으므로, 그 원인이 만들어내는 또 다른 결과인 ‘열( $B$ )이 날 확률’ 역시 높아지게 된다.
따라서 $C$ 가 관측되지 않았을 때 $A$ 와 $B$ 는 서로 영향을 주고 받는 종속관계가 된다.
3. head to head: $A \rightarrow C \leftarrow B$
이때 $A$ 와 $B$ 는 각각 독립적으로 $C$ 에 영향을 주는 원인이며, $C$ 가 관측되지 않았따면, $A$ 와 $B$ 는 서로 독립이다.
예를 들어, 두 독립적인 원인인 ‘지진( $A$ )’과 ‘도둑( $B$ )’이 있고, 둘 다 ‘경보기( $C$ )’를 울릴 수 있다고 가정해보자.
(3-1): 평소에 지진이 났다는 소식( $A$ )을 들어도, 그것이 우리 집에 도둑이 들 확률( $B$ )을 높이거나 낮추지 않는다.( $A$ 와 $B$ 가 독립)
만약 $C$ 가 관측되었다면 $A$ 와 $B$ 는 더이상 독립이 아니게 된다( $A \not\perp B \mid C$ ).
(3-2): 만약 경보기가 울렸다( $C$ 관측)는 사실을 알게 되었을 때, $A$ 와 $B$ 는 서로 정보를 주고 받는다. 만약 경보기가 울린 다음, 뉴스에서 지진이 발생했다는 소식( $A$ )을 들었다면, 경보기가 울린 이유가 도둑 때문이 아니라 지진 때문이라고 판단하여 도둑이 들었을 확률( $B$ )를 낮추게 된다. 즉, 한쪽 원인( $A$ )이 결과( $C$ )를 충분히 설명함으로써 다른 원인의 가능성을 제거하는 것이다.
예제 8.9 (조건부 독립)
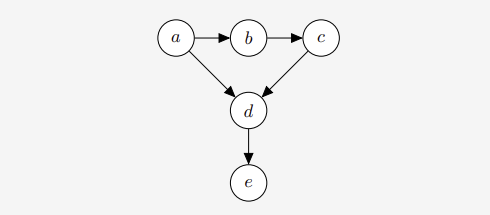
그림 8.11의 그래픽 모델을 고려해 보자. 시각적 검사는 다음을 제공한다.
$\to$ 예제 8.9 해석
- 식 (8.35): $a$ 와 $c$ 가 관측되었을 때, $b$ 와 $d$ 가 독립인가?
경로 1( $b \leftarrow a \rightarrow d$ ): $a$ 가 관측되었으므로(명제 1의 두 번째 경우가 참) -> 차단.
경로 2( $b \rightarrow c \rightarrow d$ ): $c$ 가 관측되었으므로(명제 1의 첫 번째 경우가 참) -> 차단.
$b$ 에서 $d$ 로 가는 모든 경로( $b \leftrightarrow d$ )가 차단되었으므로 두 변수는 조건부 독립이다.
- 식 (8.36): $b$ 가 관측되었을 때 $a$ 와 $c$ 는 독립인가?
경로 1 ( $a \rightarrow b \rightarrow c$ ): $b$ 가 관측되었으므로(명제 1의 첫 번째 경우가 참) -> 차단.
경로 2 ( $a \rightarrow d \leftarrow c$ ): $d$ 가 관측되지 않았으므로(명제 2가 참) -> 차단.
$a$ 에서 $c$ 로 가는 모든경로( $a \leftrightarrow c$ )가 차단되었으므로 두 변수는 조건부 독립이다.
- 식 (8.37): $c$ 가 관측되었을 때 $b$ 와 $d$ 는 독립인가?
경로 1 ( $b \leftarrow a \rightarrow d$ ): $a$ 가 미관측되었으므로(명제 1의 두 번째 경우가 거짓) 정보가 전달됨.
경로 2 ( $b \rightarrow c \rightarrow d$ ): $c$ 가 관측되었으므로(명제 1의 첫 번째 경우가 참) 차단.
따라서 $c$ 가 관측되었을 때 $b$ 와 $d$ 는 종속이다.
- 식 (8.38): $b$ 와 $e$ 가 관측되었을 때, $a$ 와 $c$ 는 독립인가?
경로 1 ( $a \rightarrow b \rightarrow c$ ): $b$ 가 관측되었으므로(명제 1의 첫 번째 경우가 참) -> 차단.
경로 2 ( $a \rightarrow d \leftarrow c$ ): $d$ 가 관측되지 않았다(명제 2가 참). 그러나 $d$ 에 종속되있는 $e$ 관측되었음을 유의해야 한다.
이전 head to head의 예시를 확장하여 각 확률 변수를 다음과 같이 가정한다.
$a$ : 지진 / $c$ : 도둑 / $d$ : 경보기 울림 / $e$ : 이웃의 항의 전화
우리는 경보기( $d$ )를 직접 듣지 못했다(미관측). 그러나 울린 경보기가 시끄럽다며 이웃이 항의 전화( $e$ )를 걸어왔다면( $e$ 관측), 우리는 경보기가 울렸기 때문에 전화가 왔음을 짐작할 수 있다.
즉, $d$ 에 종속되있는 (자손)노드 $e$ 가 관측되는 순간, (부모) $d$ 가 간접적으로 관측되는 것이다. 따라서 명제 2가 거짓이므로 두 변수 $a, c$ 가 종속 관계가 된다.
$\quad$ 방향성 그래픽 모델은 확률론적 모델의 간결한 표현을 허용하며, 우리는 9장, 10장, 11장에서 방향성 그래픽 모델의 예들을 볼 것이다. 조건부 독립 개념과 함께 이 표현은 우리가 각각의 확률론적 모델을 최적화하기 더 쉬운 수식으로 인수분해할 수 있게 해 준다.
$\quad$ 확률론적 모델의 그래픽적 표현은 모델의 구조에 대해 우리가 내린 설계 선택의 영향을 시각적으로 볼 수 있게 해 준다. 우리는 종종 모델의 구조에 대해 높은 수준의 가정을 해야 한다. 이러한 모델링 가정(하이퍼파라미터)은 예측 성능에 영향을 미치지만, 지금까지 살펴본 접근법들을 사용해서는 직접 선택할 수 없다. 8.6절에서 구조를 선택하는 여러 가지 방법에 대해 논의할 것이다.
$\to$ 그래픽 모델의 장점 중 확률 변수간의 종속성과 독립성을 눈으로 확인하는 것(시각화)은 가장 표면적인 장점이다. 변수가 수백만 개(심지어 데이터( $x$ ), 잠재 변수( $z$ ), 매개변수( $\theta$ )까지 확률 변수로 본다면 그 수는 어마어마하다)인 딥러닝 모델의 결합확률분포를 계산하는 것은 거의 불가능에 가깝다. 그러나 그래픽 모델의 간선(독립성 가정) 덕분에, 방대한 결합확률이 인수분해되며, 다루기힘든 적분이 아닌, 그래프 이론에 쓰이는 알고리즘을 이용하여 확률을 계산할 수 있다.
또한 변수간의 관계를 고려하지 않은 채 데이터에만 의존한다면, “아이스크림 판매량이 늘면 상어의 공격이 늘어난다”처럼 말도 안되는 변수간의 상관관계를 학습할 수 있으므로, 도메인 지식을 사전에 모델에 입력하는 과정이 필요하다.
$\to$ 결합 확률을 압축하고 d-분리로 독립성을 판별하려면 그래프의 구조(변수간의 관계)를 알고 있다는 전제가 필요하다. 이는 첫번째로 해당 도메인의 전문가가 모델에 지식을 주입하는 것(모델링 가정(modeling assumption) 또는 귀납적 편향(inductive bias)이라고 부른다)과, 컴퓨터가 그래프 구조를 역추적하여 찾아내는 알고리즘(대표적으로 PC알고리즘)을 사용하기도 한다.
$\to$ 그러나 사람이 변수간의 관계를 표현하는 것은 한계가 분명하며(고해상도 이미지의 각 픽셀간의 관계를 설명할 수 없다), 그것 또한 틀렸을 수 있다(확증 편향).
또한 모델링을 하려면 변수에 이름(의미)가 있어야 한다(e.g., $z$ =독감 바이러스, $z$ =지진). 그러나 강아지 사진을 생성하는 모델을 생각해보았을 때 강아지의 모습을 결정하는 숨겨진 원인(‘귀의 펄럭거림 정도’, ‘털의 곱슬거림’ 등)은 매우 다양하다. 이러한 추상적인 잠재 변수들은 애초에 노드로 표현할 수조차 없다.
따라서 딥러닝은 이런 변수 간의 관계를 수억 개의 매개변수를 가진 블랙박스(심층 신경망)으로 이를 대체한다. 각 잠재 변수에 의미를 부여하는 대신, 512차원의 연속적인 실수 벡터가 역전파를 통해 최적화된다. 다루기 힘든 적분 또한 우회하였다.
8.5.3 Further Reading
확률론적 그래픽 모델에 대한 소개는 Bishop(2006, 8장)에서 찾을 수 있으며, 다양한 응용 분야 및 해당 알고리즘적 함의에 대한 광범위한 설명은 Koller와 Friedman(2009)의 책에서 찾을 수 있다. 확률론적 그래픽 모델에는 크게 세 가지 주요 유형이 있다:
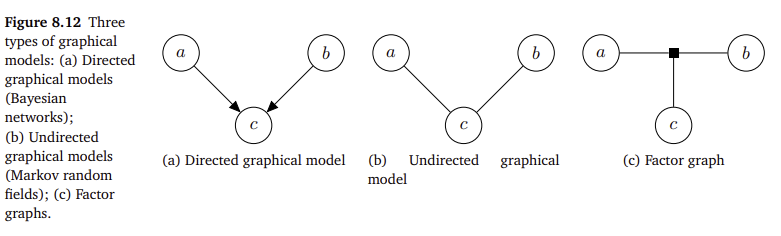
- 방향성 그래픽 모델 (베이지안 네트워크); 그림 8.12(a) 참조
- 무방향성 그래픽 모델 (마르코프 무작위장); 그림 8.12(b) 참조
- 인자 그래프 (Factor graphs); 그림 8.12(c) 참조
$\quad$ 그래픽 모델은 예를 들어 국소적 메시지 패싱(local message passing)을 통한 추론 및 학습을 위한 그래프 기반 알고리즘을 허용한다. 응용 분야는 온라인 게임에서의 랭킹(Herbrich et al., 2007)과 컴퓨터 비전(예: 이미지 분할, 의미론적 레이블링, 이미지 노이즈 제거, 이미지 복원 (Kittler and Föglein, 1984; Sucar and Gillies, 1994; Shotton et al., 2006; Szeliski et al., 2008))부터 코딩 이론(McEliece et al., 1998), 선형 방정식 시스템 풀이(Shental et al., 2008), 그리고 신호 처리에서의 반복적 베이지안 상태 추정(Bickson et al., 2007; Deisenroth and Mohamed, 2012)까지 다양하다.
$\quad$ 이 책에서는 논의하지 않지만 실제 응용에서 특히 중요한 한 가지 주제는 구조적 예측(structured prediction) (Bakir et al., 2007; Nowozin et al., 2014)의 개념이다. 이는 기계 학습 모델이 예를 들어 시퀀스, 트리, 그래프와 같이 구조화된 예측을 다룰 수 있게 해 준다. 신경망 모델의 인기로 인해 더 유연한 확률론적 모델이 사용될 수 있게 되었고, 그 결과 구조적 모델의 많은 유용한 응용이 나타났다(Goodfellow et al., 2016, 16장). 최근 몇 년 동안 인과 추론(causal inference)에 대한 응용(Pearl, 2009; Imbens and Rubin, 2015; Peters et al., 2017; Rosenbaum, 2017)으로 인해 그래픽 모델에 대한 관심이 새롭게 일고 있다.