가우시안 분포
가우시안 분포는 연속형 확률 변수에 대해 가장 잘 연구된 확률 분포이다. 이는 정규 분포(normal distribution)라고도 불린다. 이 분포의 중요성은 계산적으로 편리한 많은 성질들을 가지고 있다는 사실에서 비롯되며, 이에 대해서는 이어지는 내용에서 논의할 것이다. 특히, 우리는 선형 회귀(9장)에 대한 우도(likelihood)와 사전 확률(prior)을 정의하는 데 이를 사용할 것이며, 밀도 추정(11장)을 위해 가우시안 혼합(mixture of Gaussians)을 고려할 것이다.
(사이드바: 정규 분포. 가우시안 분포는 독립 항등 분포(i.i.d.)를 따르는 확률 변수들의 합을 고려할 때 자연스럽게 발생한다. 이는 중심 극한 정리(central limit theorem)로 알려져 있다 (Grinstead and Snell, 1997).)
$\quad$ 머신러닝의 다른 많은 분야들, 예를 들어 가우시안 프로세스, 변분 추론(variational inference), 강화학습 등도 가우시안 분포를 사용함으로써 이점을 얻는다. 이는 신호 처리(예: 칼만 필터), 제어(예: 선형 이차 레귤레이터), 통계학(예: 가설 검정)과 같은 다른 응용 분야에서도 널리 사용된다.
$\quad$ 일변량(univariate) 확률 변수에 대해, 가우시안 분포는 다음과 같이 주어지는 밀도를 가진다:
다변량(multivariate) 가우시안 분포는 평균 벡터 $\boldsymbol{\mu}$ 와 공분산 행렬 $\boldsymbol{\Sigma}$ 에 의해 완전히 특징지어지며 다음과 같이 정의된다:
여기서 $\boldsymbol{x} \in \mathbb{R}^D$ 이다. 우리는 $p(\boldsymbol{x}) = \mathcal{N}(\boldsymbol{x} \mid \boldsymbol{\mu}, \boldsymbol{\Sigma})$ 또는 $X \sim \mathcal{N}(\boldsymbol{\mu}, \boldsymbol{\Sigma})$ 로 표기한다.
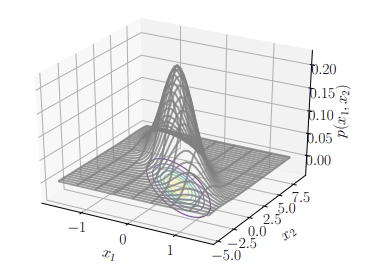
그림 6.7은 대응하는 등고선(contour) 플롯과 함께 이변량(bivariate) 가우시안(메시)을 보여준다.
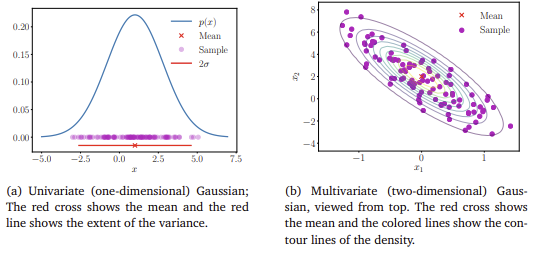
그림 6.8은 대응하는 표본들과 함께 일변량 가우시안과 이변량 가우시안을 보여준다. 영평균(zero mean)과 항등 공분산(identity covariance), 즉 $\boldsymbol{\mu} = \boldsymbol{0}$ 이고 $\boldsymbol{\Sigma} = \boldsymbol{I}$ 인 가우시안의 특수한 경우를 표준 정규 분포(standard normal distribution)라고 부른다.
$\quad$ 가우시안은 주변 분포(marginal distributions)와 조건부 분포(conditional distributions)에 대한 닫힌 형태(closed-form)의 수식을 가지기 때문에 통계적 추정과 머신러닝에서 널리 사용된다. 9장에서 우리는 선형 회귀를 위해 이러한 닫힌 형태의 수식을 광범위하게 사용한다. 가우시안 확률 변수로 모델링할 때의 주요 이점은 변수 변환(6.7절)이 종종 필요하지 않다는 것이다. 가우시안 분포는 평균과 공분산에 의해 완전히 명시되기 때문에, 우리는 종종 확률 변수의 평균과 공분산에 변환을 적용함으로써 변환된 분포를 얻을 수 있다.
6.5.1 Marginals and Conditionals of Gaussians are Gaussians
가우시안의 주변 분포와 조건부 분포는 가우시안이다.
다음에서는 다변량 확률 변수의 일반적인 경우에 대한 주변화(marginalization)와 조건화(conditioning)를 제시한다. 처음 읽을 때 이 내용이 혼란스럽다면, 독자는 대신 두 개의 일변량 확률 변수를 고려할 것을 권장한다. $X$ 와 $Y$ 를 서로 다른 차원을 가질 수 있는 두 다변량 확률 변수라고 하자. 확률의 합의 법칙(sum rule)을 적용하는 효과와 조건화의 효과를 고려하기 위해, 우리는 결합된 상태 행렬 $[\boldsymbol{x}^\top \boldsymbol{y}^\top]^\top$ 의 관점에서 가우시안 분포를 다음과 같이 명시적으로 작성한다.
여기서 $\boldsymbol{\Sigma}_{xx} = \text{Cov}[\boldsymbol{x}, \boldsymbol{x}]$ 와 $\boldsymbol{\Sigma}_{yy} = \text{Cov}[\boldsymbol{y}, \boldsymbol{y}]$ 는 각각 $\boldsymbol{x}$ 와 $\boldsymbol{y}$ 의 주변 공분산 행렬(marginal covariance matrices)이며, $\boldsymbol{\Sigma}_{xy} = \text{Cov}[\boldsymbol{x}, \boldsymbol{y}]$ 는 $\boldsymbol{x}$ 와 $\boldsymbol{y}$ 사이의 교차 공분산 행렬(cross-covariance matrix)이다.
$\quad$ 조건부 분포 $p(\boldsymbol{x} \vert \boldsymbol{y})$ 역시 가우시안이며(그림 6.9(c)에 묘사됨), 다음과 같이 주어진다 (Bishop, 2006의 섹션 2.3에서 유도됨).
(6.66)의 평균을 계산할 때 $\boldsymbol{y}$ 값은 관측치이므로 더 이상 무작위적(random)이지 않다는 점에 유의한다.
$\to$ 식 (6.67)에서 $\boldsymbol{x}$ 와 $\boldsymbol{y}$ 의 상관관계( $\boldsymbol{\Sigma}_{xy}$ )가 클수록 빼는 값이 커지므로, 불확실성이 대폭 감소한다. 반면 교차 공분산 행렬 $\boldsymbol{\Sigma}_{xy}$ 가 영행렬( $0$ )이라면, 즉 $\boldsymbol{x}$ 와 $\boldsymbol{y}$ 가 완전히 (통계적)독립이라면 빼는 값이 $0$ 이 되어 $\boldsymbol{\Sigma}_{x\vert y} = \boldsymbol{\Sigma}_{xx}$ 로 불확실성이 감소하지 않는다.
참고. 조건부 가우시안 분포는 우리가 사후 분포(posterior distributions)에 관심을 가지는 많은 곳에서 나타난다.
- 칼만 필터(Kalman filter) (Kalman, 1960)는 신호 처리에서 상태 추정을 위한 가장 중심적인 알고리즘 중 하나이며, 결합 분포의 가우시안 조건부를 계산하는 것 외에는 아무것도 수행하지 않는다 (Deisenroth and Ohlsson, 2011; Särkkä, 2013).
- 가우시안 프로세스(Gaussian processes) (Rasmussen and Williams, 2006)는 함수에 대한 분포의 실용적인 구현이다. 가우시안 프로세스에서 우리는 확률 변수들의 결합 가우시안성(joint Gaussianity)을 가정한다. 관측된 데이터에 대한 (가우시안) 조건화를 통해 함수에 대한 사후 분포를 결정할 수 있다.
- 잠재 선형 가우시안 모델(Latent linear Gaussian models) (Roweis and Ghahramani, 1999; Murphy, 2012)은 확률적 주성분 분석(PPCA) (Tipping and Bishop, 1999)을 포함한다. 10.7절에서 PPCA를 더 자세히 살펴볼 것이다.
$\quad$ 결합 가우시안 분포 $p(\boldsymbol{x}, \boldsymbol{y})$ (식 (6.64) 참조)의 주변 분포 $p(\boldsymbol{x})$ 는 그 자체로 가우시안이며, 합의 법칙(식 (6.20))을 적용하여 계산되고 다음과 같이 주어진다.
상응하는 결과가 $p(\boldsymbol{y})$ 에 대해서도 성립하며, 이는 $\boldsymbol{x}$ 에 대해 주변화(marginalizing)함으로써 얻어진다. 직관적으로, 식 (6.64)의 결합 분포를 볼 때, 우리는 관심이 없는 모든 것을 무시(즉, 적분하여 제거(integrate out))한다. 이는 그림 6.9(b)에 설명되어 있다.
예제 6.6
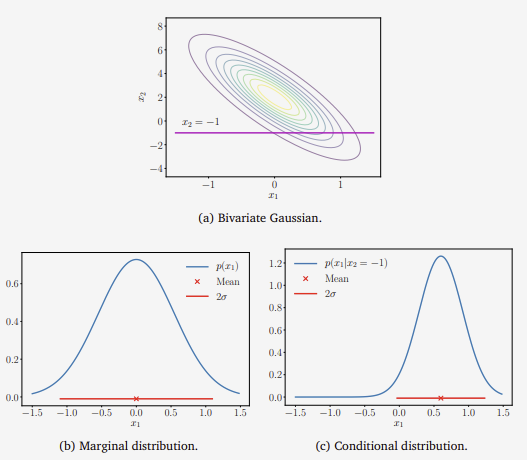
그림 6.9 (a) 이변량 가우시안; (b) 결합 가우시안 분포의 주변 분포는 가우시안이다; (c) 가우시안의 조건부 분포 역시 가우시안이다.
$\quad$ 이변량 가우시안 분포(그림 6.9에 묘사됨)를 고려해 보자.
식 (6.66)과 (6.67)을 적용하여 각각 평균과 분산을 구함으로써, $x_2 = -1$ 로 조건화된 일변량 가우시안의 파라미터들을 계산할 수 있다. 수치적으로 이는 다음과 같다.
그리고
따라서 조건부 가우시안은 다음과 같이 주어진다.
$\quad$ 대조적으로, 주변 분포 $p(x_1)$ 은 식 (6.68)을 적용하여 얻을 수 있는데, 이는 본질적으로 확률 변수 $x_1$ 의 평균과 분산을 사용하는 것이며, 그 결과는 다음과 같다.
6.5.2 Product of Gaussian Densities
가우시안 밀도의 곱
선형 회귀(9장)를 위해, 우리는 가우시안 우도(likelihood)를 계산해야 한다. 나아가, 우리는 가우시안 사전 확률(prior)을 가정하기를 원할 수도 있다(9.3절). 우리는 사후 확률(posterior)을 계산하기 위해 베이즈 정리(Bayes’ Theorem)를 적용하는데, 이는 우도와 사전 확률의 곱셈, 즉 두 가우시안 밀도의 곱셈이라는 결과를 낳는다. 두 가우시안의 곱 $\mathcal{N}(\boldsymbol{x} \mid \boldsymbol{a}, \boldsymbol{A})\mathcal{N}(\boldsymbol{x} \mid \boldsymbol{b}, \boldsymbol{B})$ 은 $c \in \mathbb{R}$ 에 의해 스케일이 조정된 가우시안 분포이며, $c\,\mathcal{N}(\boldsymbol{x} \mid \boldsymbol{c}, \boldsymbol{C})$ 로 주어진다. 여기서 각 파라미터는 다음과 같다.
(사이드바: 이 유도 과정은 이 장의 끝에 있는 연습 문제이다.)
스케일링 상수 $c$ 그 자체는 “팽창된(inflated)” 공분산 행렬 $\boldsymbol{A} + \boldsymbol{B}$ 를 사용하여 $\boldsymbol{a}$ 또는 $\boldsymbol{b}$ 에 대한 가우시안 밀도의 형태로 작성될 수 있다. 즉, $c = \mathcal{N}(\boldsymbol{a} \mid \boldsymbol{b}, \boldsymbol{A} + \boldsymbol{B}) = \mathcal{N}(\boldsymbol{b} \mid \boldsymbol{a}, \boldsymbol{A} + \boldsymbol{B})$ 이다.
주목 (Remark). 표기상의 편의를 위해, 우리는 $\boldsymbol{x}$ 가 확률 변수가 아니더라도 가우시안 밀도의 함수적 형태를 설명하기 위해 때때로 $\mathcal{N}(\boldsymbol{x} \mid \boldsymbol{m}, \boldsymbol{S})$ 를 사용할 것이다. 우리는 방금 앞선 설명에서 다음과 같이 적었을 때 이를 수행했다.
여기서 $\boldsymbol{a}$ 와 $\boldsymbol{b}$ 중 어느 것도 확률 변수가 아니다. 하지만 $c$ 를 이런 방식으로 작성하는 것이 (6.76)보다 더 간결하다. $\diamond$
6.5.3 Sums and Linear Transformation
만약 $X, Y$ 가 $p(\boldsymbol{x}) = \mathcal{N}(\boldsymbol{x} \mid \boldsymbol{\mu}_x, \boldsymbol{\Sigma}_x)$ 와 $p(\boldsymbol{y}) = \mathcal{N}(\boldsymbol{y} \mid \boldsymbol{\mu}_y, \boldsymbol{\Sigma}_y)$ 인 독립적인 가우시안 확률 변수라면 (즉, 결합 분포가 $p(\boldsymbol{x}, \boldsymbol{y}) = p(\boldsymbol{x})p(\boldsymbol{y})$ 로 주어짐), $\boldsymbol{x} + \boldsymbol{y}$ 역시 가우시안 분포를 따르며 다음과 같이 주어진다.
$p(\boldsymbol{x} + \boldsymbol{y})$ 가 가우시안이라는 것을 알면, 식 (6.46)부터 (6.49)까지의 결과를 사용하여 평균과 공분산 행렬을 즉시 결정할 수 있다. 이 성질은 선형 회귀(9장)의 경우처럼 확률 변수에 작용하는 독립 항등 분포(i.i.d.) 가우시안 노이즈를 고려할 때 중요해질 것이다.
예제 6.7
기댓값은 선형 연산이므로, 우리는 독립적인 가우시안 확률 변수들의 가중합(weighted sum)을 다음과 같이 얻을 수 있다.
주목 (Remark). 11장에서 유용하게 쓰일 경우는 가우시안 밀도(densities)의 가중합이다. 이는 가우시안 확률 변수(random variables)의 가중합과는 다르다.
$\quad$ 정리 6.12에서, 확률 변수 $x$ 는 $\alpha$ 로 가중된 두 밀도 $p_1(x)$ 와 $p_2(x)$ 의 혼합(mixture)인 밀도로부터 나온다. 기댓값의 선형성은 다변량 확률 변수에 대해서도 성립하므로, 이 정리는 다변량 확률 변수의 경우로 일반화될 수 있다. 그러나 제곱된 확률 변수의 개념은 $\boldsymbol{x}\boldsymbol{x}^\top$ 로 대체되어야 한다.
정리 6.12. 두 일변량 가우시안 밀도의 혼합을 고려해 보자.
여기서 스칼라 $0 < \alpha < 1$ 은 혼합 가중치(mixture weight)이며, $p_1(x)$ 와 $p_2(x)$ 는 서로 다른 파라미터, 즉 $(\mu_1, \sigma_1^2) \neq (\mu_2, \sigma_2^2)$ 를 가지는 일변량 가우시안 밀도(식 (6.62))이다.
이때 혼합 밀도 $p(x)$ 의 평균은 각 확률 변수의 평균들의 가중합으로 주어진다.
혼합 밀도 $p(x)$ 의 분산은 다음과 같이 주어진다.
증명. 혼합 밀도 $p(x)$ 의 평균은 각 확률 변수들의 평균에 대한 가중합으로 주어진다. 우리는 평균의 정의(정의 6.4)를 적용하고, 우리의 혼합 밀도(식 (6.80))를 대입하여 다음을 얻는다.
분산을 계산하기 위해, 우리는 식 (6.44)의 원점수(raw-score) 버전의 분산 공식을 사용할 수 있는데, 이는 제곱된 확률 변수의 기댓값에 대한 수식을 요구한다. 여기서 우리는 확률 변수의 함수(제곱)에 대한 기댓값의 정의(정의 6.3)를 사용한다.
마지막 등호에서, 우리는 $\sigma^2 = \mathbb{E}[x^2] - \mu^2$ 을 주는 원점수 버전의 분산(식 6.44)을 다시 사용했다. 이는 제곱된 확률 변수의 기댓값이 ‘평균의 제곱’과 ‘분산’의 합이 되도록 재배열된 것이다.
$\quad$ 따라서 분산은 식 (6.84d)에서 식 (6.83d)의 제곱을 빼서 주어진다.
주목 (Remark). 앞선 유도 과정은 어떠한 밀도 함수에 대해서도 성립하지만, 가우시안 분포는 평균과 분산에 의해 완전히 결정되기 때문에, 혼합 밀도는 닫힌 형태(closed form)로 결정될 수 있다. $\diamond$
$\quad$ 혼합 밀도의 경우, 개별 구성 요소들은 (구성 요소의 정체성에 조건화된) 조건부 분포로 간주될 수 있다. 식 (6.85c)는 조건부 분산 공식의 한 예시이며, 이는 총 분산의 법칙(law of total variance)으로도 알려져 있다. 이 법칙은 일반적으로 두 확률 변수 $X$ 와 $Y$ 에 대해 $\mathbb{V}_X[x] = \mathbb{E}_Y[\mathbb{V}_X[x \mid y]] + \mathbb{V}_Y[\mathbb{E}_X[x \mid y]]$ 가 성립함을 명시한다. 즉, $X$ 의 (총) 분산은 조건부 분산의 기댓값에 조건부 평균의 분산을 더한 것이다.
$\quad$ 우리는 예제 6.17에서 이변량 표준 가우시안 확률 변수 $X$ 를 고려하고, 여기에 선형 변환 $\boldsymbol{A}\boldsymbol{x}$ 를 수행했다. 그 결과는 평균이 0이고 공분산이 $\boldsymbol{A}\boldsymbol{A}^\top$ 인 가우시안 확률 변수이다. 상수 벡터를 더하는 것은 분포의 평균을 변화시키지만 분산에는 영향을 미치지 않음을 관찰하라. 즉, 확률 변수 $\boldsymbol{x} + \boldsymbol{\mu}$ 는 평균이 $\boldsymbol{\mu}$ 이고 단위 공분산을 가지는 가우시안이다. 따라서, 가우시안 확률 변수의 어떠한 선형/아핀(affine) 변환도 가우시안 분포를 따른다.
(사이드바: 가우시안 확률 변수의 어떠한 선형/아핀 변환도 역시 가우시안 분포를 따른다.)
$\quad$ 가우시안 분포를 따르는 확률 변수 $X \sim \mathcal{N}(\boldsymbol{\mu}, \boldsymbol{\Sigma})$ 를 고려해 보자. 적절한 형태의 주어진 행렬 $\boldsymbol{A}$ 에 대해, $\boldsymbol{y} = \boldsymbol{A}\boldsymbol{x}$ 가 $\boldsymbol{x}$ 의 변환된 버전이 되도록 하는 확률 변수 $Y$ 를 설정하자. 기댓값이 선형 연산자(식 6.50)라는 것을 활용하여, 우리는 $\boldsymbol{y}$ 의 평균을 다음과 같이 계산할 수 있다.
유사하게 $\boldsymbol{y}$ 의 분산은 식 (6.51)을 사용하여 찾을 수 있다.
이것은 확률 변수 $\boldsymbol{y}$ 가 다음에 따라 분포함을 의미한다.
이제 역변환(reverse transformation)을 고려해 보자: 어떤 확률 변수가 다른 확률 변수의 선형 변환인 평균을 가지고 있다는 것을 우리가 알고 있을 때이다. 주어진 풀 랭크(full rank) 행렬 $\boldsymbol{A} \in \mathbb{R}^{M \times N}$ ( $M \ge N$ )에 대해, $\boldsymbol{y} \in \mathbb{R}^M$ 가 평균이 $\boldsymbol{A}\boldsymbol{x}$ 인 가우시안 확률 변수라고 하자. 즉,
이에 대응하는 확률 분포 $p(\boldsymbol{x})$ 는 무엇인가? 만약 $\boldsymbol{A}$ 가 가역 행렬(invertible)이라면, 우리는 $\boldsymbol{x} = \boldsymbol{A}^{-1}\boldsymbol{y}$ 로 쓸 수 있고 이전 단락의 변환을 적용할 수 있다. 하지만, 일반적으로 $\boldsymbol{A}$ 는 가역 행렬이 아니며, 우리는 의사 역행렬(pseudo-inverse, 식 3.57)과 유사한 접근법을 사용한다. 즉, 양변의 앞에 $\boldsymbol{A}^\top$ 을 곱한 다음, 대칭이고 양의 정부호(positive definite)인 $\boldsymbol{A}^\top\boldsymbol{A}$ 를 역행렬로 취하여 다음 관계식을 얻는다.
따라서, $\boldsymbol{x}$ 는 $\boldsymbol{y}$ 의 선형 변환이며, 우리는 다음을 얻는다.
6.5.4 Sampling from Multivariate Gaussian Distributions
다변량 가우시안 분포로부터의 샘플링
우리는 컴퓨터 상에서의 무작위 샘플링에 대한 미묘한 부분들은 설명하지 않을 것이며, 관심 있는 독자는 Gentle (2004)를 참고하길 바란다. 다변량 가우시안의 경우, 이 과정은 3단계로 구성된다: 첫째, $[0, 1]$ 구간에서 균등한(uniform) 샘플을 제공하는 유사 난수(pseudo-random number) 소스가 필요하다; 둘째, 일변량 가우시안으로부터 샘플을 얻기 위해 박스-뮬러 변환(Box-Müller transform, Devroye, 1986)과 같은 비선형 변환을 사용한다; 셋째, 이러한 샘플들의 벡터를 모아서(collate) 다변량 표준 정규 분포 $\mathcal{N}(\boldsymbol{0}, \boldsymbol{I})$ 로부터 샘플을 얻는다.
$\quad$ 일반적인 다변량 가우시안, 즉 평균이 $\boldsymbol{0}$ 이 아니고 공분산이 항등 행렬 $\boldsymbol{I}$ 가 아닌 경우, 우리는 가우시안 확률 변수의 선형 변환 성질을 사용한다. 우리가 평균이 $\boldsymbol{\mu}$ 이고 공분산 행렬이 $\boldsymbol{\Sigma}$ 인 다변량 가우시안 분포로부터 샘플 $\boldsymbol{x}_i, i=1,\dots,n$ 을 생성하는 데 관심이 있다고 가정해 보자. 우리는 다변량 표준 정규 분포 $\mathcal{N}(\boldsymbol{0}, \boldsymbol{I})$ 로부터 샘플을 제공하는 샘플러(sampler)를 이용하여 이 샘플을 구성하고 싶다.
$\quad$ 다변량 정규 분포 $\mathcal{N}(\boldsymbol{\mu}, \boldsymbol{\Sigma})$ 로부터 샘플을 얻기 위해, 우리는 가우시안 확률 변수의 선형 변환 성질을 사용할 수 있다: 만약 $\boldsymbol{x} \sim \mathcal{N}(\boldsymbol{0}, \boldsymbol{I})$ 라면, $\boldsymbol{y} = \boldsymbol{A}\boldsymbol{x} + \boldsymbol{\mu}$ (여기서 $\boldsymbol{A}\boldsymbol{A}^\top = \boldsymbol{\Sigma}$ )는 평균이 $\boldsymbol{\mu}$ 이고 공분산 행렬이 $\boldsymbol{\Sigma}$ 인 가우시안 분포를 따른다. $\boldsymbol{A}$ 를 선택하는 한 가지 편리한 방법은 공분산 행렬 $\boldsymbol{\Sigma} = \boldsymbol{A}\boldsymbol{A}^\top$ 의 콜레스키 분해(Cholesky decomposition, 4.3절)를 사용하는 것이다. 콜레스키 분해는 $\boldsymbol{A}$ 가 삼각 행렬(triangular matrix)이 되어 효율적인 계산을 이끌어낸다는 장점이 있다.
(사이드바: 행렬의 콜레스키 분해를 계산하기 위해서는 해당 행렬이 대칭(symmetric)이고 양의 정부호(positive definite)여야 한다 (3.2.3절). 공분산 행렬들은 이 성질을 보유하고 있다.)