이전 장들에서 우리는 머신러닝의 두 가지 근본적인 문제인 회귀(9장)와 차원 축소(10장)를 이미 다루었다. 이 장에서는 머신러닝의 세 번째 기둥인 밀도 추정(density estimation)을 살펴볼 것이다. 이 과정에서 기댓값 최대화(EM) 알고리즘과 혼합 모델을 이용한 밀도 추정의 잠재 변수 관점과 같은 중요한 개념들을 도입한다.
$\quad$ 머신러닝을 데이터에 적용할 때, 우리는 종종 데이터를 어떤 방식으로든 표현하는 것을 목표로 한다. 가장 직접적인 방법은 데이터 포인트 그 자체를 데이터의 표현으로 취하는 것이다(그림 11.1 참조). 그러나 데이터셋이 거대하거나 데이터의 특성을 표현하는 데 관심이 있다면 이 접근 방식은 도움이 되지 않을 수 있다. 밀도 추정에서 우리는 가우시안이나 베타 분포와 같은 파라미터 기반 분포족(parametric family)에서 유도된 밀도를 사용하여 데이터를 간결하게 표현한다. 예를 들어, 가우시안 분포를 사용하여 데이터를 간결하게 표현하기 위해 데이터셋의 평균과 분산을 찾을 수 있다. 평균과 분산은 8.3절에서 논의한 도구들인 최대 우도(ML) 또는 최대 사후 확률(MAP) 추정을 사용하여 찾을 수 있다. 그런 다음 이 가우시안의 평균과 분산을 사용하여 데이터의 기저에 있는 분포를 표현할 수 있다. 즉, 우리가 이 분포로부터 샘플링을 한다면 해당 데이터셋은 이 분포로부터의 전형적인 실현(realization)이라고 생각하는 것이다.
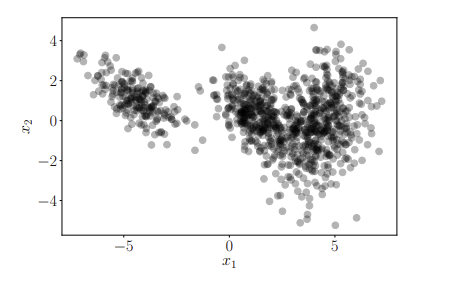
$\quad$ 실제로는 가우시안(또는 지금까지 접한 모든 다른 분포들)은 모델링 능력에 한계가 있다. 예를 들어, 그림 11.1에서 데이터를 생성한 밀도를 가우시안으로 근사하는 것은 좋지 않은 근사가 될 것이다. 이어지는 내용에서는 밀도 추정을 위해 사용할 수 있는 더 표현력이 풍부한 분포족인 혼합 모델(mixture models)을 살펴볼 것이다.
$\quad$ 혼합 모델은 $K$ 개의 단순(기초) 분포들의 볼록 결합(convex combination)에 의해 분포 $p(\boldsymbol{x})$ 를 기술하는 데 사용될 수 있다.
여기서 성분 $p_k$ 는 가우시안, 베르누이 또는 감마 분포와 같은 기초 분포족의 일원이며, $\pi_k$ 는 혼합 가중치(mixture weights)이다. 혼합 모델은 다봉성(multimodal) 데이터 표현을 허용하기 때문에 대응하는 기초 분포보다 더 표현력이 풍부하다. 즉, 그림 11.1의 예시와 같이 여러 개의 ‘클러스터’를 가진 데이터셋을 기술할 수 있다.
$\quad$ 우리는 기초 분포가 가우시안인 가우시안 혼합 모델(GMM)에 집중할 것이다. 주어진 데이터셋에 대해, 우리는 GMM을 훈련시키기 위해 모델 파라미터의 우도를 최대화하는 것을 목표로 한다. 이를 위해 5장, 6장 및 7.2절의 결과들을 사용할 것이다. 그러나 이전에 논의한 다른 응용들(선형 회귀나 PCA)과 달리, 우리는 닫힌 형식(closed-form)의 최대 우도 해를 찾을 수 없을 것이다. 대신, 우리는 오직 반복적으로만 풀 수 있는 일련의 의존적 연립 방정식에 도달하게 될 것이다.