최대 우도를 통한 파라미터 학습
데이터셋 $\mathcal{X} = \set{\mathbf{x}_1, \dots, \mathbf{x}_N}$ 이 주어졌다고 가정하자. 여기서 $\mathbf{x}_n, n = 1, \dots, N$ 은 알 수 없는 분포 $p(\mathbf{x})$ 로부터 독립적이고 동일하게(i.i.d.) 추출되었다. 우리의 목표는 $K$ 개의 혼합 성분을 가진 GMM을 사용하여 이 알 수 없는 분포 $p(\mathbf{x})$ 에 대한 좋은 근사/표현을 찾는 것이다. GMM의 파라미터는 $K$ 개의 평균 $\boldsymbol{\mu}_k$ , 공분산 $\boldsymbol{\Sigma}_k$ , 그리고 혼합 가중치 $\pi_k$ 이다. 우리는 이 모든 자유 파라미터들을 $\boldsymbol{\theta} := \set{\pi_k, \boldsymbol{\mu}_k, \boldsymbol{\Sigma}_k : k = 1, \dots, K}$ 로 요약한다.
$\to$ GMM을 학습시킨다는 것은 데이터셋 $\mathcal{X}$ 가 관측될 확률(우도)을 최대화하는 파라미터 집합 $\boldsymbol{\theta}$ 를 찾는 과정이다.
이 식은 로그를 취했을 때 로그 내부에서 합( $\sum$ )이 발생하는 구조이므로, 단순한 미분으로는 최적해를 구할 수 없다. 따라서 반복적인 최적화 알고리즘을 필요로 한다.
예제 11.1 (초기 설정)
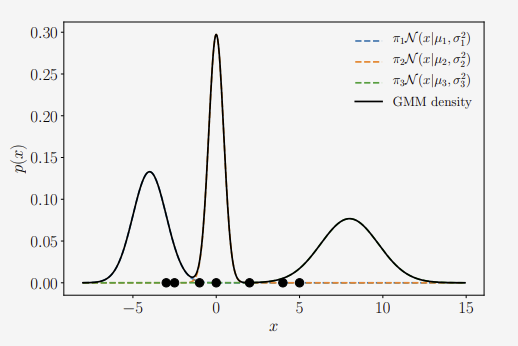
(그림 11.3 초기 설정: 세 개의 혼합 성분(점선)과 일곱 개의 데이터 포인트(원반)를 가진 GMM(검은색 실선).)
$\quad$ 이 장 전반에 걸쳐, 우리는 중요한 개념들을 설명하고 시각화하는 데 도움이 되는 간단한 실행 예제(running example)를 사용할 것이다.
$\quad$ 우리는 일곱 개의 데이터 포인트로 구성된 1차원 데이터셋 $\mathcal{X} = \set{-3, -2.5, -1, 0, 2, 4, 5}$ 를 고려하며, 데이터의 밀도를 모델링하는 $K=3$ 인 GMM을 찾고자 한다. 우리는 혼합 성분들을 다음과 같이 초기화한다.
그리고 이들에게 동일한 가중치 $\pi_1 = \pi_2 = \pi_3 = \frac{1}{3}$ 을 할당한다. 이에 대응하는 모델(및 데이터 포인트)은 그림 11.3에 나타나 있다.
$\quad$ 다음에서는 모델 파라미터 $\boldsymbol{\theta}$ 의 최대 우도 추정치 $\boldsymbol{\theta}_{ML}$ 을 구하는 방법을 자세히 설명한다. 우리는 파라미터가 주어졌을 때 훈련 데이터의 예측 분포인 우도(likelihood)를 적는 것으로 시작한다. 우리는 i.i.d. 가정을 활용하며, 이는 다음과 같이 인수분해된 우도로 이어진다.
여기서 모든 개별 우도 항 $p(\boldsymbol{x}_n \vert \boldsymbol{\theta})$ 는 가우시안 혼합 밀도이다. 그런 다음 우리는 로그 우도를 다음과 같이 얻는다.
우리는 (11.10)에 정의된 로그 우도 $\mathcal{L}$ 을 최대화하는 파라미터 $\boldsymbol{\theta}_{ML}^*$ 을 찾는 것을 목표로 한다. 우리의 “정상적인” 절차는 모델 파라미터 $\boldsymbol{\theta}$ 에 대한 로그 우도의 기울기 $d\mathcal{L}/d\boldsymbol{\theta}$ 를 계산하고, 이를 0으로 설정한 뒤 $\boldsymbol{\theta}$ 에 대해 푸는 것이다. 그러나 우리의 이전 최대 우도 추정 예제들(예: 9.2절에서 논의한 선형 회귀)과 달리, 우리는 닫힌 형식(closed-form)의 해를 얻을 수 없다. 하지만 우리는 좋은 모델 파라미터 $\boldsymbol{\theta}_{ML}$ 을 찾기 위해 반복적인 체계를 활용할 수 있으며, 이는 GMM을 위한 EM 알고리즘으로 밝혀질 것이다. 핵심 아이디어는 다른 파라미터들을 고정시킨 채 한 번에 하나의 모델 파라미터를 업데이트하는 것이다.
Remark. 만약 우리가 단일 가우시안을 목표 밀도로 고려한다면, (11.10)에서 $k$ 에 대한 합산은 사라지고, 로그는 가우시안 성분에 직접 적용되어 다음과 같이 된다.
이 단순한 형태는 8장에서 논의한 것처럼 $\boldsymbol{\mu}$ 와 $\boldsymbol{\Sigma}$ 의 닫힌 형식 최대 우도 추정치를 찾을 수 있게 해준다. (11.10)에서는 로그를 $k$ 에 대한 합산 안으로 이동시킬 수 없으므로, 단순한 닫힌 형식의 최대 우도 해를 얻을 수 없다.
$\quad$ 어떤 함수의 국소 최적점(local optimum)은 파라미터에 대한 기울기가 반드시 사라져야(필요 조건) 한다는 성질을 보인다(7장 참조). 우리의 경우, GMM 파라미터 $\boldsymbol{\mu}_k, \boldsymbol{\Sigma}_k, \pi_k$ 에 대해 (11.10)의 로그 우도를 최적화할 때 다음과 같은 필요 조건들을 얻는다.
세 가지 모든 필요 조건에 대해, 연쇄 법칙(chain rule, 5.2.2절 참조)을 적용하면 다음과 같은 형태의 편미분이 필요하다.
여기서 $\boldsymbol{\theta} = \set{\boldsymbol{\mu}_k, \boldsymbol{\Sigma}_k, \pi_k, k = 1, \dots, K}$ 는 모델 파라미터들이며, 다음이 성립한다.
다음에서는 (11.12)부터 (11.14)까지의 편미분을 계산할 것이다. 하지만 그전에, 이 장의 나머지 부분에서 중심적인 역할을 할 양인 책임값(responsibilities)을 도입한다.
$\to$ 여기서 $p(\boldsymbol{x}_n \vert \boldsymbol{\theta}) = \sum_{j=1}^K \pi_j \mathcal{N}(\boldsymbol{x}_n \vert \boldsymbol{\mu}_j, \boldsymbol{\Sigma}_j)$ 이므로, $\boldsymbol{\mu}_k$ 로 미분할 때 $j=k$ 인 항을 제외한 나머지 성분들은 모두 상수로 취급되어 사라진다.
11.2.1 Responsibilities
책임값
우리는 $n$ 번째 데이터 포인트에 대한 $k$ 번째 혼합 성분의 책임값(responsibility)이라는 양을 다음과 같이 정의한다.
데이터 포인트 $\boldsymbol{x}_n$ 에 대한 $k$ 번째 혼합 성분의 책임값 $r_{nk}$ 는 데이터 포인트가 주어졌을 때 혼합 성분의 우도(likelihood)에 비례한다.
따라서 데이터 포인트가 해당 혼합 성분으로부터 나왔을 법한(plausible) 샘플일 때, 혼합 성분은 그 데이터 포인트에 대해 높은 책임값을 갖는다. $\boldsymbol{r}_n := [r_{n1}, \dots, r_{nK}]^\top \in \mathbb{R}^K$ 은 (정규화된) 확률 벡터, 즉 $\sum_k r_{nk} = 1$ 이며 $r_{nk} \ge 0$ 임을 유의하라. 이 확률 벡터는 $K$ 개의 혼합 성분들 사이에 확률 질량을 분배하며, 우리는 $\boldsymbol{r}_n$ 을 $K$ 개의 혼합 성분에 대한 $\boldsymbol{x}_n$ 의 소프트 할당(soft assignment)으로 생각할 수 있다. 그러므로 (11.17)의 책임값 $r_{nk}$ 는 $\boldsymbol{x}_n$ 이 $k$ 번째 혼합 성분에 의해 생성되었을 확률을 나타낸다.
$\to$ 식 (11.17)의 분자의 $\mathcal{N}(\boldsymbol{x}_n \vert \boldsymbol{\mu}_k, \boldsymbol{\Sigma}_k)$ 항에 대해 보자. 이 항은 평균이 $\boldsymbol{\mu}_k$ 이고 공분산 행렬이 $\boldsymbol{\Sigma}_k$ 인 다변량 가우시안 분포의 확률 밀도 함수(Probability Density Function, PDF)를 특정 데이터 지점 $\boldsymbol{x}_n$ 에서 평가한 값이다.
이는 $\boldsymbol{x}_n$ 이 $k$ 번째 가우시안 분포의 중심으로부터 얼마나 떨어져 있는지, 그리고 해당 분포의 모양(공분산)에 비추어 볼 때 얼마나 ‘나타날 법한’ 값인지를 결정한다.
잠재 변수 관점에서 이 항은 “데이터 $\boldsymbol{x}_n$ 이 $k$ 번째 성분으로부터 생성되었다고 가정했을 때(조건), 그 값이 관측될 확률 밀도( $p(\boldsymbol{x}_n \vert z_n = k)$ )”를 의미한다.
$z_n$ 는 $n$ 번째 데이터가 어느 성분에서 왔는지를 나타내는 잠재 변수이다. $z_n = k$ 일 때, 데이터 $\boldsymbol{x}_n$ 의 분포는 정확히 $\mathcal{N}(\boldsymbol{\mu}_k, \boldsymbol{\Sigma}_k)$ 를 따른다. 따라서 이 항은 $p(\boldsymbol{x}_n \vert z_n = k, \boldsymbol{\theta})$ 와 동일하다.
지수 항 내부의 $(\boldsymbol{x}_n - \boldsymbol{\mu}_k)^\top \boldsymbol{\Sigma}_k^{-1} (\boldsymbol{x}_n - \boldsymbol{\mu}_k)$ 부분은 데이터와 평균 사이의 거리를 공분산을 고려하여 측정한 것이다. 이 값이 작을수록(데이터가 평균에 가까울수록) 확률 밀도 값 $\mathcal{N}(\cdot)$ 은 커지며, 이 값이 클수록(데이터가 평균에서 멀어질수록) 확률 밀도 값은 작아진다.
예제 11.2 (책임값)
그림 11.3의 예제에 대해, 우리는 책임값 $r_{nk}$ 를 다음과 같이 계산한다.
여기서 $n$ 번째 행은 $\boldsymbol{x}_n$ 에 대한 모든 혼합 성분의 책임값을 말해준다. 한 데이터 포인트에 대한 모든 $K$ 개 책임값의 합(각 행의 합)은 1이다. $k$ 번째 열은 $k$ 번째 혼합 성분의 책임값에 대한 개요를 제공한다. 세 번째 혼합 성분(세 번째 열)은 처음 네 개의 데이터 포인트 중 어느 것에 대해서도 책임이 없지만, 나머지 데이터 포인트들에 대해서는 많은 책임을 지고 있음을 볼 수 있다. 한 열의 모든 성분의 합은 $N_k$ 값, 즉 $k$ 번째 혼합 성분의 총 책임값을 준다. 우리 예제에서 우리는 $N_1 = 2.058, N_2 = 2.008, N_3 = 2.934$ 를 얻는다.
$\quad$ 다음에서는 주어진 책임값에 대해 모델 파라미터 $\boldsymbol{\mu}_k, \boldsymbol{\Sigma}_k, \pi_k$ 의 업데이트를 결정한다. 업데이트 방정식들이 모두 책임값에 의존함을 보게 될 것이며, 이는 최대 우도 추정 문제에 대한 닫힌 형식의 해를 불가능하게 만든다. 그러나 주어진 책임값에 대해 우리는 다른 것들을 고정시킨 채 한 번에 하나의 모델 파라미터를 업데이트할 것이며, 그 후 책임값을 다시 계산할 것이다. 이 두 단계를 반복하는 것은 결국 국소 최적점에 수렴하게 되며, 이는 EM 알고리즘의 구체적인 예시이다. 이에 대해 11.3에서 더 자세히 논의한다.
11.2.2 Updating the Means
평균 업데이트
정리 11.1 (GMM 평균의 업데이트). GMM의 평균 파라미터 $\boldsymbol{\mu}_k, k = 1, \dots, K$ 의 업데이트 식은 다음과 같이 주어진다.
여기서 책임값 $r_{nk}$ 는 (11.17)에서 정의된 것과 같다.
Remark. (11.20)에서 개별 혼합 성분의 평균 $\boldsymbol{\mu}_k$ 의 업데이트는 (11.17)에 주어진 $r_{nk}$ 를 통해 모든 평균, 공분산 행렬 $\boldsymbol{\Sigma}_k$ , 그리고 혼합 가중치 $\pi_k$ 에 의존한다. 그러므로 우리는 모든 $\boldsymbol{\mu}_k$ 에 대한 닫힌 형식의 해를 한 번에 얻을 수 없다.
$\to$ 가우시안 확률 밀도 함수의 미분은 연쇄 법칙에 의해 다음과 같음과 같다.
지수 부분은 다음과 같다.
행렬미분( $\frac{\partial}{\partial \boldsymbol{s}} (\boldsymbol{a} - \boldsymbol{s})^\top \mathbf{W} (\boldsymbol{a} - \boldsymbol{s}) = -2\mathbf{W}(\boldsymbol{a} - \boldsymbol{s})$ )과 그래디언트 표기를 행벡터로 표기하면 다음과 같다.
전치를 취하여
증명. (11.15)로부터, 평균 파라미터 $\boldsymbol{\mu}_k, k = 1, \dots, K$ 에 대한 로그 우도의 기울기를 구하려면 다음의 편미분을 계산해야 함을 알 수 있다.
여기서 우리는 오직 $k$ 번째 혼합 성분만이 $\boldsymbol{\mu}_k$ 에 의존한다는 사실을 활용했다. (11.21b)의 결과를 (11.15)에 사용하고 모든 것을 종합하면, $\boldsymbol{\mu}_k$ 에 대한 $\mathcal{L}$ 의 목적하는 편미분은 다음과 같이 주어진다.
여기서 우리는 (11.16)의 항등식과 (11.21b)의 편미분 결과를 사용하여 (11.22b)에 도달했다. $r_{nk}$ 값은 (11.17)에서 정의한 책임값이다. 우리는 이제 $\frac{\partial \mathcal{L}(\boldsymbol{\mu}_k^{new})}{\partial \boldsymbol{\mu}_k} = \mathbf{0}^\top$ 이 되도록 (11.22c)를 $\boldsymbol{\mu}_k^{new}$ 에 대해 풀어 다음을 얻는다.
여기서 우리는 $N_k$ 를 다음과 같이 정의했다.
이는 전체 데이터셋에 대한 $k$ 번째 혼합 성분의 총 책임값이다. 이것으로 정리 11.1의 증명을 마친다.
$\quad$ 직관적으로 (11.20)은 평균의 중요도 가중 몬테카를로 추정(importance-weighted Monte Carlo estimate)으로 해석될 수 있으며, 여기서 데이터 포인트 $\boldsymbol{x}_n$ 의 중요도 가중치는 $\boldsymbol{x}_n$ 에 대한 $k$ 번째 클러스터의 책임값 $r_{nk}$ 이다. 그러므로 평균 $\boldsymbol{\mu}_k$ 는 $r_{nk}$ 에 비례하는 강도로 데이터 포인트 $\boldsymbol{x}_n$ 쪽으로 끌려간다. 대응하는 혼합 성분이 높은 책임값(즉, 높은 우도)을 가지는 데이터 포인트들에 대해 평균은 더 강하게 끌려간다. 그림 11.4가 이를 설명한다.
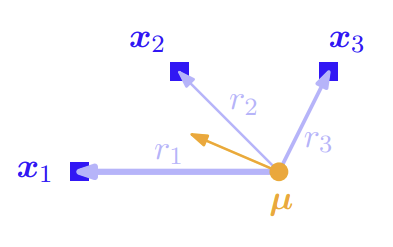
(그림 11.4 GMM에서 혼합 성분의 평균 파라미터 업데이트. 평균 $\boldsymbol{\mu}$ 는 대응하는 책임값에 의해 주어지는 가중치와 함께 개별 데이터 포인트 쪽으로 끌어당겨진다.)
'”끌어당겨진다”는 표현은 로그 우도 함수의 그래디언트가 가지는 성질에 기인한다. 식 (11.22c)에서 $\boldsymbol{\mu}_k$ 에 대한 로그 우도의 편미분은 다음과 같다.
여기서 $(\boldsymbol{x}_n - \boldsymbol{\mu}_k)$ 는 현재의 평균 $\boldsymbol{\mu}_k$ 에서 데이터 포인트 $\boldsymbol{x}_n$ 을 향하는 변위 벡터이다. 경사 상승법의 관점에서, 모델의 우도를 높이려면 파라미터 $\boldsymbol{\mu}_k$ 를 이 그래디언트 방향으로 이동해야 한다. 즉, “ $\boldsymbol{\mu}_k$ 가 $\boldsymbol{x}_n$ 쪽으로 끌려간다”는 것은 그래디언트가 그 방향을 가리키고 있음을 의미한다.
우리는 또한 (11.20)의 평균 업데이트를 다음과 같이 주어진 분포 하에서의 모든 데이터 포인트의 기댓값으로 해석할 수 있다.
이는 정규화된 확률 벡터이며, 즉 다음이 성립한다.
예제 11.3 (평균 업데이트)
그림 11.3의 예제에서, 평균값들은 다음과 같이 업데이트된다.
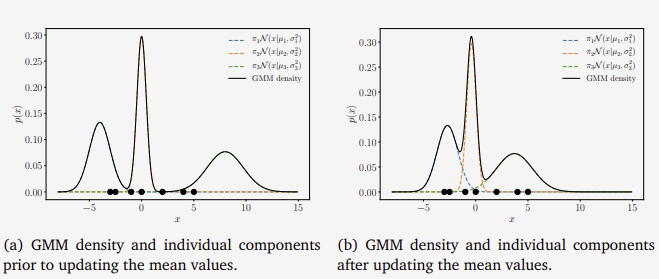
(그림 11.5 GMM에서 평균값을 업데이트한 효과. (a) 평균값을 업데이트하기 전의 GMM; (b) 분산과 혼합 가중치를 유지하면서 평균값 $\mu_k$ 를 업데이트한 후의 GMM.)
여기서 우리는 첫 번째와 세 번째 혼합 성분의 평균이 데이터가 존재하는 영역으로 이동하는 반면, 두 번째 성분의 평균은 그렇게 극적으로 변하지 않음을 알 수 있다. 그림 11.5는 이러한 변화를 설명한다. 그림 11.5(a)는 평균값을 업데이트하기 전의 GMM 밀도를 보여주고, 그림 11.5(b)는 분산과 혼합 가중치를 유지한 채 평균값 $\mu_k$ 를 업데이트한 후의 GMM 밀도를 보여준다.
$\quad$ (11.20)에서의 평균 파라미터 업데이트는 상당히 직관적으로 보인다. 그러나 책임값 $r_{nk}$ 는 모든 $j = 1, \dots, K$ 에 대한 $\pi_j, \boldsymbol{\mu}_j, \boldsymbol{\Sigma}_j$ 의 함수이므로, (11.20)의 업데이트는 GMM의 모든 파라미터에 의존하며, 9.2절의 선형 회귀나 10장의 PCA에서 얻었던 닫힌 형식의 해는 얻을 수 없음을 유의하라.
11.2.3 Updating the Covariances
공분산 업데이트
정리 11.2 (GMM 공분산의 업데이트). GMM의 공분산 파라미터 $\boldsymbol{\Sigma}_k, k = 1, \dots, K$ 의 업데이트 식은 다음과 같이 주어진다.
여기서 $r_{nk}$ 와 $N_k$ 는 각각 (11.17)과 (11.24)에서 정의되었다.
증명. 정리 11.2를 증명하기 위한 우리의 접근 방식은 로그 우도 $\mathcal{L}$ 을 공분산 $\boldsymbol{\Sigma}_k$ 에 대해 편미분하고, 이를 $\mathbf{0}$ 으로 설정한 뒤 $\boldsymbol{\Sigma}_k$ 에 대해 푸는 것이다. 일반적인 접근 방식부터 시작한다.
우리는 이미 (11.16)으로부터 ${\color{orange}1/p(\boldsymbol{x}_n \vert \boldsymbol{\theta})}$ 를 알고 있다. 남은 편미분 항인 ${\color{blue}\partial p(\boldsymbol{x}_n \vert \boldsymbol{\theta}) / \partial \boldsymbol{\Sigma}_k}$ 를 얻기 위해, 가우시안 분포의 정의 $p(\boldsymbol{x}_n \vert \boldsymbol{\theta})$ 를 적고 (11.9 참조), $k$ 번째 성분을 제외한 모든 항을 버린다.
( $\to$ 식 (11.32c) 곱의 미분법 적용: $(f \cdot g)’ = f’g + fg’$ )
우리는 이제 다음의 항등식들을 사용한다.
그리고 (약간의 재배열 후에) (11.31)에서 요구되는 목적하는 편미분을 다음과 같이 얻는다.
모든 것을 종합하면, $\boldsymbol{\Sigma}_k$ 에 대한 로그 우도의 편미분은 다음과 같이 주어진다.
우리는 책임값 $r_{nk}$ 가 이 편미분에서도 나타남을 알 수 있다. 이 편미분을 $\mathbf{0}$ 으로 설정하면, 다음과 같은 필수적인 최적성 조건을 얻는다.
$\boldsymbol{\Sigma}_k$ 에 대해 풀면, 우리는 다음을 얻는다.
여기서 $r_{nk}$ 는 (11.25)에서 정의된 확률 벡터이다. 이는 $k = 1, \dots, K$ 에 대한 $\boldsymbol{\Sigma}_k$ 의 간단한 업데이트 규칙을 제공하며 정리 11.2를 증명한다.
$\quad$ (11.20)에서의 $\boldsymbol{\mu}_k$ 업데이트와 유사하게, (11.30)에서의 공분산 업데이트를 중심화된 데이터(centered data) $\tilde{\mathcal{X}}_k := \set{\boldsymbol{x}_1 - \boldsymbol{\mu}_k, \dots, \boldsymbol{x}_N - \boldsymbol{\mu}_k}$ 의 제곱에 대한 중요도 가중 기댓값(importance-weighted expected value)으로 해석할 수 있다.
예제 11.4 (분산 업데이트)
그림 11.3의 예제에서 분산은 다음과 같이 업데이트된다:
여기서 우리는 첫 번째와 세 번째 성분의 분산은 상당히 줄어든 반면, 두 번째 성분의 분산은 약간 증가하는 것을 볼 수 있다.
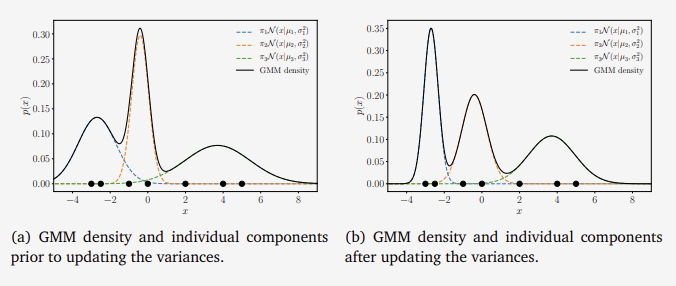
$\quad$ 그림 11.6은 이러한 설정을 시각화한다. 그림 11.6(a)는 그림 11.5(b)와 동일하지만 확대된 모습이며, 분산을 업데이트하기 전의 GMM 밀도와 개별 성분들을 보여준다. 그림 11.6(b)는 분산을 업데이트한 후의 GMM 밀도를 보여준다.
평균 파라미터의 업데이트와 마찬가지로, (11.30)을 $k$ 번째 혼합 성분과 연관된 데이터 포인트 $\boldsymbol{x}_n$ 들의 가중 공분산에 대한 몬테카를로 추정(Monte Carlo estimate)으로 해석할 수 있으며, 여기서 가중치는 책임값 $r_{nk}$ 이다. 평균 파라미터의 업데이트와 같이, 이 업데이트는 책임값 $r_{nk}$ 를 통해 모든 $\pi_j, \boldsymbol{\mu}_j, \boldsymbol{\Sigma}_j (j=1, \dots, K)$ 에 의존하므로, 닫힌 형태의 해(closed-form solution)를 얻는 것이 불가능하다.
11.2.4 Updating the Mixture Weights
혼합 가중치 업데이트
정리 11.3 (GMM 혼합 가중치의 업데이트). GMM의 혼합 가중치는 다음과 같이 업데이트된다.
여기서 $N$ 은 데이터 포인트의 개수이고 $N_k$ 는 (11.24)에서 정의되었다.
증명. 가중치 파라미터 $\pi_k, k = 1, \dots, K$ 에 대한 로그 우도의 편미분을 구하기 위해, 우리는 라그랑주 승수법(Lagrange multipliers)을 사용하여 제약 조건 $\sum_k \pi_k = 1$ 을 고려한다 (7.2절 참조). 라그랑주 함수(Lagrangian)는 다음과 같다.
여기서 $\mathcal{L}$ 은 (11.10)의 로그 우도이며, 두 번째 항은 모든 혼합 가중치의 합이 1이 되어야 한다는 등식 제약 조건을 인코딩한다. $\pi_k$ 에 대한 편미분을 구하면 다음과 같다.
( $\to$ 로그 함수의 미분 $\frac{d}{dx} \ln(u) = \frac{1}{u} \frac{du}{dx}$ , $\sum_{j=1}^K \pi_j \mathcal{N}_j$ 중에서 $\pi_k$ 를 포함하는 항은 $\pi_k \mathcal{N}_k$ 뿐이므로, $\pi_k$ 로 미분하면 해당 가우시안 밀도 값인 $\mathcal{N}_k$ 만 남는다.)
그리고 라그랑주 승수 $\lambda$ 에 대한 편미분은 다음과 같다.
두 편미분을 $\mathbf{0}$ 으로 설정하면(최적성을 위한 필요 조건), 다음과 같은 연립 방정식을 얻는다.
(11.47)에 (11.46)을 대입하여 $\pi_k$ 에 대해 풀면 다음을 얻는다.
이를 통해 (11.46)의 $\lambda$ 에 $-N$ 을 대입하여 다음을 얻을 수 있다.
이는 가중치 파라미터 $\pi_k$ 에 대한 업데이트 규칙을 제공하며 정리 11.3을 증명한다.
$\to$ $\sum N_k = N$ 가 어떻게 성립하는가?
앞서(11.24) $N_k := \sum_{n=1}^N r_{nk}$ 으로 정의했다. 시그마의 순서를 변경하면 다음과 같다.
특정 데이터 $n$ 에 대한 모든 클러스터의 책임값 합은 항상 1이므로( $\sum_k r_{nk} = 1$ ), 식 (11.48)을 유도할 수 있다.
$\quad$ 우리는 (11.42)에서의 혼합 가중치를 $k$ 번째 클러스터의 총 책임값(total responsibility)과 데이터 포인트 수 사이의 비율로 정의할 수 있다. $N = \sum_k N_k$ 이므로, 데이터 포인트 수( $N$ )는 모든 혼합 성분의 총 책임값의 합으로도 해석될 수 있다. 따라서 $\pi_k$ 는 데이터셋에 대한 $k$ 번째 혼합 성분의 상대적 중요도(relative importance)가 된다.
Remark. $N_k = \sum_{n=1}^N r_{nk}$ 이므로, 혼합 가중치 $\pi_k$ 에 대한 업데이트 식 (11.42) 또한 책임값 $r_{nk}$ 를 통해 모든 $\pi_j, \boldsymbol{\mu}_j, \boldsymbol{\Sigma}_j (j=1, \dots, K)$ 에 의존하게 된다.
$\to$ 혼합 성분은 전체 확률 밀도 함수를 구성하는 개별적인 가우시안 분포 하나하나를 의미한다.
예제 11.5 (가중치 파라미터 업데이트)
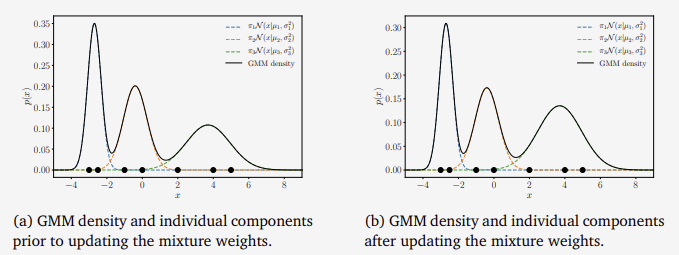
$\quad$ 그림 11.3의 예제에서 혼합 가중치는 다음과 같이 업데이트된다:
여기서 우리는 세 번째 성분이 더 많은 가중치/중요도를 얻는 반면, 다른 성분들은 약간 덜 중요해지는 것을 볼 수 있다. 그림 11.7은 혼합 가중치를 업데이트한 효과를 예시한다. 그림 11.7(a)는 그림 11.6(b)와 동일하며(다만 확대됨), 혼합 가중치를 업데이트하기 전의 GMM 밀도와 개별 성분들을 보여준다. 그림 11.7(b)는 혼합 가중치를 업데이트한 후의 GMM 밀도를 보여준다.
$\quad$ 전반적으로 평균, 분산, 그리고 가중치를 한 번씩 업데이트함으로써, 우리는 그림 11.7(b)에 나타난 GMM을 얻는다. 그림 11.3에 표시된 초기화 상태와 비교했을 때, 우리는 파라미터 업데이트를 통해 GMM 밀도가 자신의 질량(mass) 중 일부를 데이터 포인트 쪽으로 이동시켰음을 확인할 수 있다.
$\quad$ 평균, 분산, 가중치를 한 번씩 업데이트한 후, 그림 11.7(b)에서의 GMM 적합도(fit)는 그림 11.3의 초기화 상태보다 이미 눈에 띄게(remarkably) 좋아졌다. 이는 로그 우도(log-likelihood) 값으로도 증명되는데, 로그 우도 값은 한 번의 전체 업데이트 사이클을 거친 후 -28.3(초기화)에서 -14.4로 증가했다.