잠재 변수 관점
우리는 GMM을 이산 잠재 변수 모델(discrete latent-variable model)의 관점에서 바라볼 수 있다. 즉, 잠재 변수 $\boldsymbol{z}$ 가 오직 유한한 집합의 값들만을 가질 수 있는 경우이다. 이는 잠재 변수가 $\mathbb{R}^M$ 공간의 연속적인 값(continuous-valued numbers)이었던 PCA(주성분 분석)와 대조된다.
$\quad$ 확률적 관점(probabilistic perspective)의 장점은 다음과 같다:
(i) 이전 절들에서 우리가 내렸던 몇 가지 임시방편적인(ad hoc) 결정들을 정당화할 것이며,
(ii) 책임값(responsibilities)을 사후 확률(posterior probabilities)로 구체적으로 해석할 수 있게 해주고,
(iii) 모델 파라미터를 업데이트하기 위한 반복 알고리즘이, 잠재 변수 모델에서의 최대 우도 파라미터 추정을 위한 EM 알고리즘으로서 원칙적인 방식(principled manner)으로 유도될 수 있다.
11.4.1 Generative Process and Probabilistic Model
생성 과정과 확률 모델
GMM을 위한 확률 모델을 유도하기 위해, 생성 과정(generative process), 즉 확률 모델을 사용하여 데이터를 생성할 수 있게 해주는 과정에 대해 생각해보는 것이 유용하다.
$\quad$ 우리는 $K$ 개의 성분을 가진 혼합 모델을 가정하며, 하나의 데이터 포인트 $\boldsymbol{x}$ 는 정확히 단 하나의 혼합 성분에 의해 생성될 수 있다고 가정한다. 우리는 두 가지 상태를 가지는(6.2절 참조) 이진 지시 변수(binary indicator variable) $z_k \in {0, 1}$ 를 도입하여, $k$ 번째 혼합 성분이 해당 데이터 포인트를 생성했는지 여부를 나타내게 한다. 따라서 다음과 같이 쓸 수 있다:
우리는 $\boldsymbol{z} := [z_1, \dots, z_K]^\top \in \mathbb{R}^K$ 를 $K-1$ 개의 0과 정확히 한 개의 1로 구성된 확률 벡터로 정의한다. 예를 들어, $K=3$ 일 때 유효한 $\boldsymbol{z}$ 는 $\boldsymbol{z} = [z_1, z_2, z_3]^\top = [0, 1, 0]^\top$ 가 될 수 있으며, 이는 $z_2 = 1$ 이므로 두 번째 혼합 성분을 선택하게 된다.
Remark. 때때로 이러한 종류의 확률 분포를 베르누이 분포를 2개 이상의 값으로 일반화했다는 의미에서 “멀티누이(multinoulli)”라고 부른다 (Murphy, 2012).
$\quad$ $\boldsymbol{z}$ 의 특성상 $\sum_{k=1}^K z_k = 1$ 이 성립한다. 따라서 $\boldsymbol{z}$ 는 원-핫 인코딩(one-hot encoding) (또는 1-of- $K$ 표현)이다.
$\quad$ 지금까지 우리는 지시 변수 $z_k$ 가 알려져 있다고 가정했다. 그러나 실제로는 그렇지 않으며, 우리는 잠재 변수 $\boldsymbol{z}$ 에 다음과 같은 사전 분포(prior distribution)를 부여한다:
그러면 이 확률 벡터의 $k$ 번째 항목인
은 $k$ 번째 혼합 성분이 데이터 포인트 $\boldsymbol{x}$ 를 생성했을 확률을 설명한다.
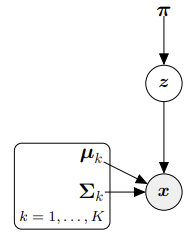
(그림 11.11): 단일 데이터 포인트에 대한 GMM의 그래피컬 모델.
_Remark(GMM에서의 샘플링). 이 잠재 변수 모델의 구조(그림 11.11의 대응되는 그래피컬 모델 참조)는 데이터를 생성하기 위한 매우 단순한 샘플링 절차(생성 과정)를 자연스럽게 이끌어낸다:
- $\boldsymbol{z}^{(i)} \sim p(\boldsymbol{z})$ 에서 샘플링한다.
- $\boldsymbol{x}^{(i)} \sim p(\boldsymbol{x} \vert \boldsymbol{z}^{(i)} = 1)$ 에서 샘플링한다.
첫 번째 단계에서는 $p(\boldsymbol{z}) = \boldsymbol{\pi}$ 에 따라 무작위로 혼합 성분 $i$ 를 선택한다 (원-핫 인코딩 $\boldsymbol{z}$ 를 통해). 두 번째 단계에서는 대응되는 혼합 성분으로부터 샘플을 추출한다. 잠재 변수의 샘플들을 버리고 $\boldsymbol{x}^{(i)}$ 만 남기게 되면, 우리는 GMM으로부터 추출된 유효한 샘플들을 얻게 된다. 그래피컬 모델 상에서 확률 변수의 샘플이 부모(parent) 변수의 샘플에 의존하는 이러한 종류의 샘플링을 조상 샘플링(ancestral sampling)이라고 부른다.
$\quad$ 일반적으로, 확률 모델은 데이터와 잠재 변수의 결합 분포(joint distribution)에 의해 정의된다 (8.4절 참조). 식 (11.59)와 (11.60)에서 정의된 사전 확률 $p(\boldsymbol{z})$ 와 (11.58)로부터의 조건부 확률 $p(\boldsymbol{x}\vert \boldsymbol{z})$ 를 사용하여, 우리는 다음과 같이 이 결합 분포의 모든 $K$ 개 성분들을 얻는다.
$k = 1, \dots, K$ 에 대하여, 따라서
이며, 이는 확률 모델을 완전히 명시(fully specifies)한다.
11.4.2 Likelihood
잠재 변수 모델에서 우도 $p(\boldsymbol{x}\vert \boldsymbol{\theta})$ 를 얻기 위해, 우리는 잠재 변수들을 주변화(marginalize out)해야 한다(8.4.3절 참조). 우리의 경우, 이는 (11.62)의 결합 확률 $p(\boldsymbol{x}, \boldsymbol{z})$ 에서 모든 잠재 변수들을 합산하여(summing out) 제거함으로써 수행할 수 있으며, 따라서 다음과 같다.
이제 우리는 이전에 생략했던 확률 모델의 파라미터 $\boldsymbol{\theta}$ 를 명시적으로 조건부에 포함시킨다. (11.63)에서 우리는 $\boldsymbol{z}$ 의 가능한 모든 $K$ 개의 원-핫 인코딩들에 대해 합을 구하며, 이는 $\sum_{\boldsymbol{z}}$ 로 표기된다. 각 $\boldsymbol{z}$ 에는 오직 0이 아닌 단일 항목만 존재하므로, $\boldsymbol{z}$ 가 가질 수 있는 구성/설정(configurations/settings)은 오직 $K$ 개뿐이다. 예를 들어 $K=3$ 이라면, $\boldsymbol{z}$ 는 다음의 구성들을 가질 수 있다.
(11.63)에서 $\boldsymbol{z}$ 의 가능한 모든 구성에 대해 합을 구하는 것은 $\boldsymbol{z}$ -벡터의 0이 아닌 항목을 보고 다음과 같이 쓰는 것과 동치이다.
따라서 우리가 원하는 주변 분포(marginal distribution)는 다음과 같이 주어진다.
우리는 이것이 식 (11.3)의 GMM 모델임을 식별할 수 있다. 데이터셋 $\mathcal{X}$ 가 주어지면, 우리는 즉각적으로 다음의 우도를 얻는다.
이는 정확히 (11.9)에서 본 GMM 우도이다. 그러므로, 잠재 지시자(latent indicators) $z_k$ 를 갖는 잠재 변수 모델은 가우시안 혼합 모델을 생각하는 동등한(equivalent) 방법이다.s
11.4.3 Posterior Distribution
사후 분포
잠재 변수 $\boldsymbol{z}$ 에 대한 사후 분포(posterior distribution)를 간단히 살펴보자. 베이즈 정리(Bayes’ theorem)에 따르면, $k$ 번째 성분이 데이터 포인트 $\boldsymbol{x}$ 를 생성했을 사후 확률은 다음과 같다.
여기서 주변 확률(marginal) $p(\boldsymbol{x})$ 는 (11.66b)에 주어져 있다. 이는 $k$ 번째 지시 변수 $z_k$ 에 대한 사후 분포를 다음과 같이 산출한다.
우리는 이것이 데이터 포인트 $\boldsymbol{x}$ 에 대한 $k$ 번째 혼합 성분의 책임값(responsibility)임을 식별할 수 있다. 여기서 $k = 1, \dots, K$ 일 때 GMM 파라미터 $\pi_k, \boldsymbol{\mu}_k, \boldsymbol{\Sigma}_k$ 에 대한 명시적인 조건부 표기는 생략했음에 유의하라.
11.4.4 Extension to a Full Dataset
전체 데이터셋으로의 확장
지금까지 우리는 데이터셋이 단일 데이터 포인트 $\boldsymbol{x}$ 로만 구성된 경우에 대해서만 논의했다. 그러나 사전 확률과 사후 확률의 개념은 $N$ 개의 데이터 포인트로 구성된 $\mathcal{X} := {\boldsymbol{x}_1, \dots, \boldsymbol{x}_N}$ 의 경우로 직접적으로 확장될 수 있다.
$\quad$ GMM의 확률적 해석에서, 모든 데이터 포인트 $\boldsymbol{x}_n$ 은 자신만의 고유한 잠재 변수를 소유한다.
이전에는 (단일 데이터 포인트 $\boldsymbol{x}$ 만 고려했을 때) 인덱스 $n$ 을 생략했지만, 이제는 이것이 중요해진다.
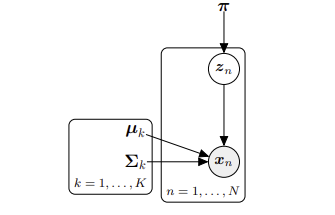
$\quad$ 우리는 모든 잠재 변수 $\boldsymbol{z}_n$ 에 걸쳐 동일한 사전 분포 $\boldsymbol{\pi}$ 를 공유한다. 이에 대응하는 그래피컬 모델은 그림 11.12에 나타나 있으며, 여기서 우리는 플레이트 표기법(plate notation)을 사용한다.
$\quad$ 조건부 분포 $p(\boldsymbol{x}_1, \dots, \boldsymbol{x}_N \vert \boldsymbol{z}_1, \dots, \boldsymbol{z}_N)$ 는 데이터 포인트들에 대해 인수분해(factorizes)되며 다음과 같이 주어진다.
사후 분포 $p(z_{nk} = 1 \vert \boldsymbol{x}_n)$ 를 얻기 위해, 우리는 11.4.3절과 동일한 논리를 따르고 베이즈 정리를 적용하여 다음을 얻는다.
이것은 $p(z_{nk} = 1 \vert \boldsymbol{x}_n)$ 가 $k$ 번째 혼합 성분이 데이터 포인트 $\boldsymbol{x}_n$ 을 생성했을 (사후) 확률이며, 우리가 (11.17)에서 도입했던 책임값 $r_{nk}$ 와 대응된다는 것을 의미한다. 이제 책임값은 직관적일 뿐만 아니라 사후 확률로서 수학적으로 정당화된(mathematically justified) 해석을 갖게 되었다.
11.4.5 EM Algorithm Revisited
EM 알고리즘 재고
우리가 최대 우도 추정(maximum likelihood estimation)을 위한 반복 기법으로 소개했던 EM 알고리즘은 잠재 변수 관점(latent-variable perspective)에서 원칙적인 방법(principled way)으로 유도될 수 있다. 모델 파라미터의 현재 설정 $\boldsymbol{\theta}^{(t)}$ 가 주어졌을 때, E-단계는 기대 로그 우도(expected log-likelihood)를 계산한다.
여기서 $\log p(\boldsymbol{x}, \boldsymbol{z} \vert \boldsymbol{\theta})$ 의 기댓값은 잠재 변수들의 사후 분포(posterior) $p(\boldsymbol{z} \vert \boldsymbol{x}, \boldsymbol{\theta}^{(t)})$ 에 대해 취해진다. M-단계는 (11.73b)를 최대화함으로써 업데이트된 모델 파라미터 세트 $\boldsymbol{\theta}^{(t+1)}$ 를 선택한다.
$\quad$ 비록 EM 반복이 로그 우도를 증가시키기는 하지만, EM이 (전역적인) 최대 우도 해(maximum likelihood solution)로 수렴한다는 보장은 없다. EM 알고리즘이 로그 우도의 국소 최댓값(local maximum)으로 수렴할 가능성이 존재한다. 파라미터 $\boldsymbol{\theta}$ 에 대한 서로 다른 초기화(initializations)를 사용하여 여러 번의 EM을 실행함으로써, 나쁜 국소 최적해(local optimum)에 빠질 위험을 줄일 수 있다. 여기서는 더 자세한 내용으로 들어가지 않으며, Rogers and Girolami (2016)와 Bishop (2006)의 훌륭한 설명을 참고하기 바란다.