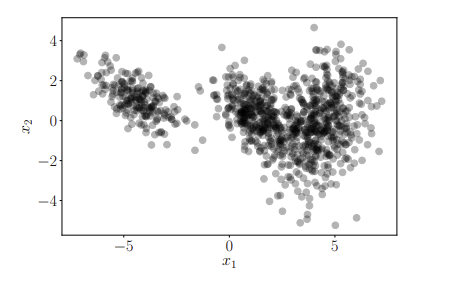
조상 샘플링(ancestral sampling)을 사용하여 새로운 데이터를 생성하는 것이 간단하다는 점에서 GMM은 생성 모델(generative model)로 간주될 수 있다 (Bishop, 2006). 주어진 GMM 파라미터 $\pi_k, \boldsymbol{\mu}_k, \boldsymbol{\Sigma}_k \ (k=1, \dots, K)$ 에 대해, 우리는 확률 벡터 $[\pi_1, \dots, \pi_K]^\top$ 로부터 인덱스 $k$ 를 샘플링한 다음 데이터 포인트 $\boldsymbol{x} \sim \mathcal{N}(\boldsymbol{\mu}_k, \boldsymbol{\Sigma}_k)$ 를 샘플링한다. 이를 $N$ 번 반복하면 GMM에 의해 생성된 데이터셋을 얻게 된다. 그림 11.1은 이 절차를 사용하여 생성되었다.
$\quad$ 이 장 전체에서 우리는 혼합 성분의 수 $K$ 가 알려져 있다고 가정했다. 실제로는 그렇지 않은 경우가 많다. 그러나 8.6.1절에서 논의된 중첩 교차 검증(nested cross-validation)을 사용하여 좋은 모델을 찾을 수 있다.
$\quad$ 가우시안 혼합 모델은 $K$ -평균( $K$ -means) 클러스터링 알고리즘과 밀접한 관련이 있다. $K$ -평균 역시 데이터 포인트를 클러스터에 할당하기 위해 EM 알고리즘을 사용한다. 만약 GMM의 평균들을 클러스터 중심으로 취급하고 공분산을 무시하면 (또는 $\boldsymbol{I}$ 로 설정하면), 우리는 $K$ -평균에 도달하게 된다. MacKay (2003)에 의해 훌륭하게 설명되었듯, $K$ -평균은 데이터 포인트를 클러스터 중심 $\boldsymbol{\mu}_k$ 에 “하드(hard)”하게 할당하는 반면, GMM은 책임값을 통해 “소프트(soft)”하게 할당한다.
$\quad$ 우리는 GMM의 잠재 변수 관점과 EM 알고리즘에 대해 아주 간략히만 다루었다. EM은 비선형 상태 공간 모델과 같은 일반적인 잠재 변수 모델의 파라미터 학습 (Ghahramani and Roweis, 1999; Roweis and Ghahramani, 1999) 및 Barber (2012)가 논의한 강화 학습에도 사용될 수 있음에 유의하라. 따라서 GMM의 잠재 변수 관점은 원칙적인 방식으로 대응되는 EM 알고리즘을 유도하는 데 유용하다 (Bishop, 2006; Barber, 2012; Murphy, 2012).
$\quad$ 우리는 오직 GMM 파라미터를 찾기 위한 (EM 알고리즘을 통한) 최대 우도 추정(maximum likelihood estimation)만 논의했다. 최대 우도에 대한 표준적인 비판들은 여기서도 동일하게 적용된다:
- 선형 회귀에서와 마찬가지로, 최대 우도는 심각한 과적합(overfitting)을 겪을 수 있다. GMM의 경우, 혼합 성분의 평균이 어떤 데이터 포인트와 정확히 동일해지고 공분산이 $\boldsymbol{0}$ 으로 향할 때 이러한 현상이 발생한다. 그러면 우도는 무한대(infinity)로 접근한다. Bishop (2006)과 Barber (2012)가 이 문제를 자세히 논의한다.
- 우리는 $k=1, \dots, K$ 에 대한 파라미터 $\pi_k, \boldsymbol{\mu}_k, \boldsymbol{\Sigma}_k$ 의 점 추정(point estimate)만을 얻을 뿐이며, 이는 파라미터 값의 불확실성(uncertainty)에 대한 어떠한 지표도 제공하지 않는다. 베이지안 접근법은 파라미터에 사전 분포(prior)를 부여하고, 이를 사용하여 파라미터에 대한 사후 분포(posterior distribution)를 얻는다. 이 사후 분포는 모델 증거(model evidence, 주변 우도)를 계산할 수 있게 해주며, 이는 혼합 성분의 수를 결정하는 원칙적인 방법을 제공하는 모델 비교(model comparison)에 사용될 수 있다. 불행히도, 이 모델에는 켤레 사전 분포(conjugate prior)가 존재하지 않기 때문에 이 설정에서는 닫힌 형태의 추론(closed-form inference)이 불가능하다. 그러나 변분 추론(variational inference)과 같은 근사 기법을 사용하여 근사적인 사후 분포를 얻을 수 있다 (Bishop, 2006).
$\to$ GMM에서 데이터 포인트 1개에 대한 우도는 다음과 같다.
데이터가 단 2개만 있다고 가정하면, 전체 우도는 다음과 같다.
GMM은 가우시안들의 가중평균이므로, 단일한 형태의 가우시안으로 표현할 수 없다. 따라서 켤레 사전 분포가 존재하지 않는다.
$\quad$ 이 장에서 우리는 밀도 추정을 위한 혼합 모델에 대해 논의했다. 사용할 수 있는 밀도 추정 기법은 매우 다양하다. 실무에서는 종종 히스토그램(histograms)과 커널 밀도 추정(kernel density estimation)을 사용한다.
$\quad$ 히스토그램은 연속적인 밀도를 표현하는 비모수적(nonparametric) 방법을 제공하며 Pearson (1895)에 의해 제안되었다. 히스토그램은 데이터 공간을 “구간 분할(binning)”하고 각 구간(bin)에 몇 개의 데이터 포인트가 떨어지는지 세어 구성된다. 그런 다음 각 구간의 중앙에 막대를 그리고, 막대의 높이는 해당 구간 내의 데이터 포인트 수에 비례하게 한다. 구간 크기(bin size)는 매우 중요한 하이퍼파라미터이며, 잘못된 선택은 과적합과 과소적합을 초래할 수 있다. 8.2.4절에서 논의된 교차 검증을 사용하여 좋은 구간 크기를 결정할 수 있다.
$\quad$ 커널 밀도 추정(KDE)은 Rosenblatt (1956)와 Parzen (1962)에 의해 독립적으로 제안되었으며, 밀도 추정을 위한 비모수적 방법이다. $N$ 개의 i.i.d. 샘플들이 주어졌을 때, 커널 밀도 추정기는 기저의 분포를 다음과 같이 표현한다.
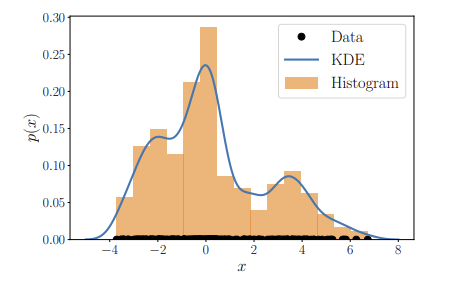
여기서 $k$ 는 커널 함수(kernel function), 즉 적분하면 1이 되는 음이 아닌 함수이며, $h > 0$ 은 스무딩/대역폭 파라미터(smoothing/bandwidth parameter)로 히스토그램의 구간 크기와 비슷한 역할을 한다. 우리가 데이터셋의 모든 개별 데이터 포인트 $\boldsymbol{x}_n$ 마다 커널을 배치함에 유의하라. 흔히 사용되는 커널 함수로는 균등 분포와 가우시안 분포가 있다. 커널 밀도 추정치는 히스토그램과 밀접한 관련이 있지만, 적절한 커널을 선택함으로써 밀도 추정치의 매끄러움(smoothness)을 보장할 수 있다. 그림 11.13은 250개의 데이터 포인트가 주어진 데이터셋에 대해 히스토그램과 커널 밀도 추정기(가우시안 형태의 커널 사용)의 차이를 예시한다.