최대 분산 관점
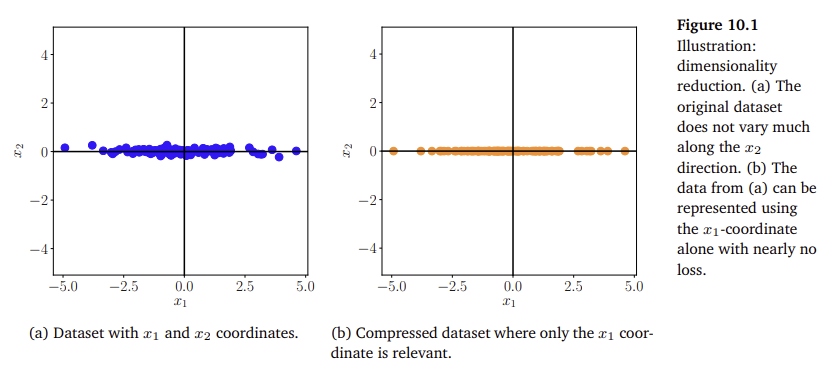
그림 10.1은 2차원 데이터셋이 단일 좌표를 사용하여 어떻게 표현될 수 있는지에 대한 예시를 제공했다. 그림 10.1(b)에서 데이터의 $x_2$ 좌표가 추가적인 정보를 제공하지 않으므로 이를 무시하기로 결정했으며, 그 결과 압축된 데이터는 그림 10.1(a)의 원본 데이터와 유사성을 유지한다. $x_1$ 좌표를 무시하는 선택도 가능했으나, 이 경우 압축된 데이터는 원본 데이터와 형태가 상이해지며 데이터의 정보 다수가 소실된다.
$\quad$ 데이터에 포함된 정보량을 데이터셋이 “공간을 채우는(space filling)” 정도로 해석한다면, 데이터의 산포도(spread)를 관찰하여 내포된 정보를 서술할 수 있다. 6.4.1절에 따라 분산(variance)은 데이터의 산포도를 나타내는 지표이며, 따라서 가능한 한 많은 정보를 보존하기 위해 데이터의 저차원 표현에서 분산을 극대화하는 차원 축소 알고리즘으로 PCA를 유도할 수 있다. 그림 10.4는 이를 시각화한다.
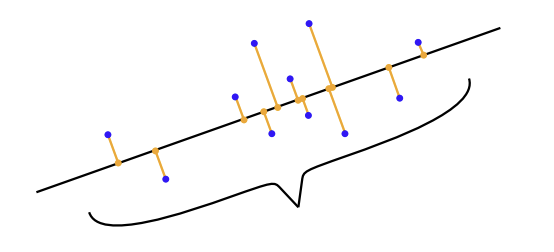
PCA는 데이터(파란색)가 부분공간(주황색)으로 사영될 때 분산(데이터의 산포도)을 최대로 유지하는 저차원 부분공간(선)을 탐색한다.
$\quad$ 10.1절의 설정을 고려할 때, 목적은 데이터를 행렬 $\boldsymbol{B}$ (식 (10.3) 참조)의 열 $\boldsymbol{b}_1, \dots, \boldsymbol{b}_M$ 에 의해 생성되는 부분공간으로 사영하여 압축할 때 정보를 최대로 보존하는 행렬 $\boldsymbol{B}$ 를 찾는 것이다. 데이터 압축 후 정보를 최대로 보존하는 것은 저차원 코드에서 최대 양의 분산을 포착하는 것과 동치이다(Hotelling, 1933).
Remark (중심화된 데이터). 식 (10.1)의 데이터 공분산 행렬에서 중심화된(centered) 데이터를 가정했다. 이 가정은 일반성을 상실하지 않는다: $\boldsymbol{\mu}$ 를 데이터의 평균이라 하자. 6.4.4절에서 논의한 분산의 성질을 적용하면 다음을 얻는다.
즉, 저차원 코드의 분산은 데이터의 평균에 의존하지 않는다. 따라서 이 절의 나머지 부분에 대해 데이터의 평균이 $\boldsymbol{0}$ 이라고 가정한다. 이 전제에 따라 저차원 코드의 평균 또한 $\boldsymbol{0}$ 이 되는데, 이는 $\mathbb{E}_{\boldsymbol{z}}[\boldsymbol{z}] = \mathbb{E}_{\boldsymbol{x}}[\boldsymbol{B}^\top\boldsymbol{x}] = \boldsymbol{B}^\top\mathbb{E}_{\boldsymbol{x}}[\boldsymbol{x}] = \boldsymbol{0}$ 이기 때문이다.
$\to$ 피타고라스 정리에 의해, 원점에서 데이터 포인트 $\boldsymbol{x}$ 까지의 유클리드 거리 제곱(데이터의 총 분산)은 사영된 벡터 $\tilde{\boldsymbol{x}}$ 의 길이 제곱(보존된 분산)과 직교 오차 벡터 $\boldsymbol{x} - \tilde{\boldsymbol{x}}$ 의 길이 제곱(재구성 오차)의 합과 같다.
총 분산 $\Vert \boldsymbol{x}\Vert ^2$ 는 사영 축의 선택과 무관한 고정된 상수이다. 따라서 투영된 분산 $\Vert \tilde{\boldsymbol{x}}\Vert ^2$ 를 최대화하는 문제(10.2절)는 필연적으로 재구성 오차 $\Vert \boldsymbol{x} - \tilde{\boldsymbol{x}}\Vert ^2$ 를 최소화하는 문제(10.3절)와 동일하다.
10.2.1 Direction with Maximal Variance
최대 분산 방향
다차원 확률 변수의 분산을 참고하면 좋다.
저차원 코드의 분산을 순차적 접근법을 사용하여 최대화한다. 사영된 데이터의 분산을 최대화하는 단일 벡터 $\boldsymbol{b}_1 \in \mathbb{R}^D$ 를 탐색하는 것으로 시작한다. 즉, $\boldsymbol{z} \in \mathbb{R}^M$ 의 첫 번째 좌표 $z_1$ 의 분산
이 최대화되도록 한다. 여기서 데이터의 i.i.d. 가정을 활용하였고, $z_{1n}$ 을 $\boldsymbol{x}_n \in \mathbb{R}^D$ 의 저차원 표현 $\boldsymbol{z}_n \in \mathbb{R}^M$ 의 첫 번째 좌표로 정의했다. $\boldsymbol{z}_n$ 의 첫 번째 성분은 다음과 같다.
즉, 이는 $\boldsymbol{b}_1$ 에 의해 생성되는 1차원 부분공간으로 $\boldsymbol{x}_n$ 을 직교 사영한 좌표이다(3.8절 참조). (10.8)을 (10.7)에 대입하면 다음을 얻는다.
여기서 $\boldsymbol{S}$ 는 (10.1)에서 정의된 데이터 공분산 행렬이다. (10.9a)에서, 두 벡터의 내적은 인자에 대해 대칭적이라는 사실, 즉 $\boldsymbol{b}_1^\top \boldsymbol{x}_n = \boldsymbol{x}_n^\top \boldsymbol{b}_1$ 임을 사용했다.
$\to$ 식 (10.7) 보충 설명
식 (10.7)은 축 $\boldsymbol{b}_1$ 위로 투영된 $N$ 개의 모든 좌표값( $z_{11}, z_{12}, \dots, z_{1N}$ )을 제곱하여 평균을 낸 것이다. 우리는 10,2절 도입부에서 계산의 편의를 위해 원본 데이터 $\boldsymbol{x}_n$ 의 평균을 0( $\boldsymbol{\mu}=\boldsymbol{0}$ )으로 맞춰두었으므로, 이를 투영한 $z_1$ 의 평균 역시 0이 된다. 따라서 분산 $\frac{1}{N}\sum (z_{1n} - \mu_z)^2$ 이 식 (10.7)과 동일하다.
$\quad$ 벡터 $\boldsymbol{b}_1$ 의 크기를 임의로 증가시키면 $V_1$ 이 증가한다. 즉, 벡터 $\boldsymbol{b}_1$ 이 2배 길어지면 $V_1$ 은 잠재적으로 4배 커질 수 있다. 따라서 모든 해를 $\Vert \boldsymbol{b}_1\Vert ^2 = 1$ 로 제한하며, 이는 데이터가 가장 크게 변동하는 방향을 탐색하는 제약이 있는 최적화 문제(constrained optimization problem)를 도출한다.
벡터 $\boldsymbol{b}_1$ 은 행렬 $\boldsymbol{B}$ 의 첫 번째 열이 되며, 따라서 저차원 부분공간을 생성하는 $M$ 개의 정규 직교 기저 벡터 중 첫 번째가 된다.
$\quad$ 해 공간을 단위 벡터로 제한함으로써 최대 분산 방향을 가리키는 벡터 $\boldsymbol{b}_1$ 은 다음 제약이 있는 최적화 문제를 통해 찾을 수 있다.
7.2절을 따라, 이 제약이 있는 최적화 문제를 풀기 위해 라그랑지안(Lagrangian)을 얻는다.
$\boldsymbol{b}_1$ 과 $\lambda_1$ 에 대한 $\mathfrak{L}$ 의 편도함수는 각각 다음과 같다.
이 편도함수들을 $\boldsymbol{0}$ 으로 설정하면 다음 관계식을 얻는다.
이를 고윳값 분해의 정의(4.4절)와 비교하면, $\boldsymbol{b}_1$ 은 데이터 공분산 행렬 $\boldsymbol{S}$ 의 고유벡터(eigenvector)이고, 라그랑주 승수 $\lambda_1$ 은 대응하는 고윳값(eigenvalue) 역할을 함을 알 수 있다. 이 고유벡터 성질(10.13)은 분산 목적 함수(10.10)를 다음과 같이 다시 쓸 수 있게 한다.
즉, 1차원 부분공간으로 사영된 데이터의 분산은 이 부분공간을 생성하는 기저 벡터 $\boldsymbol{b}_1$ 과 연관된 고윳값과 동일하다. 따라서 저차원 코드의 분산을 최대화하기 위해, 데이터 공분산 행렬의 가장 큰 고윳값과 연관된 기저 벡터를 선택한다. 이 고유벡터를 첫 번째 주성분(principal component)이라고 부른다. 좌표 $z_{1n}$ 을 다시 데이터 공간으로 매핑함으로써 원본 데이터 공간에서 주성분 $\boldsymbol{b}_1$ 의 기여도를 결정할 수 있으며, 이는 원본 데이터 공간에서의 사영된 데이터 포인트를 산출한다.
Remark. $\tilde{\boldsymbol{x}}_n$ 은 $D$ 차원 벡터이지만, 기저 벡터 $\boldsymbol{b}_1 \in \mathbb{R}^D$ 에 대해 이를 표현하는 데는 단일 좌표 $z_{1n}$ 만 필요하다.
양 $\sqrt{\lambda_1}$ 은 단위 벡터 $\boldsymbol{b}_1$ 의 부하(loading)라고도 불리며, 주 부분공간(principal subspace) $\text{span}[\boldsymbol{b}_1]$ 에 의해 설명되는 데이터의 표준 편차를 나타낸다.)
10.2.2 M-dimensional Subspace with Maximal Variance
최대 분산 M차원 부분공간
가장 큰 $m - 1$ 개의 고윳값과 연관된 행렬 $\boldsymbol{S}$ 의 $m - 1$ 개 고유벡터로서 첫 $m - 1$ 개의 주성분을 이미 찾았다고 가정하자. $\boldsymbol{S}$ 가 대칭 행렬이므로, 스펙트럴 정리(정리 4.15)에 의해 이 고유벡터들을 사용하여 $\mathbb{R}^D$ 의 $(m - 1)$ 차원 부분공간에 대한 정규 직교 고유 기저(orthonormal eigenbasis)를 구성할 수 있다. 일반적으로 $m$ 번째 주성분은 데이터에서 처음 $m - 1$ 개 주성분 $\boldsymbol{b}_1, \dots, \boldsymbol{b}_{m-1}$ 의 영향을 빼냄으로써 찾을 수 있으며, 이를 통해 남은 정보를 압축하는 주성분을 찾고자 시도한다. 그러면 다음과 같은 새로운 데이터 행렬에 도달한다.
여기서 $\boldsymbol{X} = [\boldsymbol{x}_1, \dots, \boldsymbol{x}_N] \in \mathbb{R}^{D \times N}$ 는 데이터 포인트를 열벡터로 포함하고, $\boldsymbol{B}_{m-1} := \sum_{i=1}^{m-1} \boldsymbol{b}_i \boldsymbol{b}_i^\top$ 는 $\boldsymbol{b}_1, \dots, \boldsymbol{b}_{m-1}$ 에 의해 생성되는 부분공간으로 사영하는 투영 행렬이다.
식 (10.17)의 행렬 $\hat{\boldsymbol{X}} := [\hat{\boldsymbol{x}}_1, \dots, \hat{\boldsymbol{x}}_N] \in \mathbb{R}^{D \times N}$ 는 아직 압축되지 않은 데이터의 정보를 포함한다.
Remark (표기법). 이 장 전반에 걸쳐, 데이터 $\boldsymbol{x}_1, \dots, \boldsymbol{x}_N$ 을 데이터 행렬의 행(Row)으로 모으는 관례를 따르지 않고, 이들을 $\boldsymbol{X}$ 의 열(Column)로 정의한다. 이는 우리의 데이터 행렬 $\boldsymbol{X}$ 가 관습적인 $N \times D$ 행렬 대신 $D \times N$ 행렬임을 의미한다. 이러한 선택의 이유는 행렬을 전치하거나 벡터를 행렬의 왼쪽에 곱해지는 행벡터로 재정의할 필요 없이 대수 연산이 매끄럽게 진행되기 때문이다.
$\quad$ $m$ 번째 주성분을 찾기 위해, 우리는 $\Vert \boldsymbol{b}_m\Vert ^2 = 1$ 이라는 제약 조건 하에 분산을 최대화한다.
여기서 (10.9b)와 동일한 단계를 따랐으며, $\hat{\boldsymbol{S}}$ 를 변환된 데이터셋 $\hat{\boldsymbol{X}} := {\hat{\boldsymbol{x}}_1, \dots, \hat{\boldsymbol{x}}_N}$ 의 데이터 공분산 행렬로 정의했다. 앞서 첫 번째 주성분만을 고려했을 때와 마찬가지로, 제약이 있는 최적화 문제를 풀면 최적해 $\boldsymbol{b}_m$ 이 $\hat{\boldsymbol{S}}$ 의 가장 큰 고윳값과 연관된 $\hat{\boldsymbol{S}}$ 의 고유벡터임을 발견하게 된다.
$\quad$ $\boldsymbol{b}_m$ 은 $\boldsymbol{S}$ 의 고유벡터이기도 하다. 더 일반적으로, $\boldsymbol{S}$ 와 $\hat{\boldsymbol{S}}$ 의 고유벡터 집합은 동일하다. $\boldsymbol{S}$ 와 $\hat{\boldsymbol{S}}$ 모두 대칭 행렬이므로 정규 직교 고유 기저(ONB)를 찾을 수 있다(스펙트럴 정리 4.15). 즉, $\boldsymbol{S}$ 와 $\hat{\boldsymbol{S}}$ 모두에 대해 $D$ 개의 서로 다른 고유벡터가 존재한다. 다음으로, $\boldsymbol{S}$ 의 모든 고유벡터가 $\hat{\boldsymbol{S}}$ 의 고유벡터임을 보인다. $\hat{\boldsymbol{S}}$ 의 고유벡터 $\boldsymbol{b}_1, \dots, \boldsymbol{b}_{m-1}$ 을 이미 찾았다고 가정하자. $\boldsymbol{S}$ 의 고유벡터 $\boldsymbol{b}_i$ , 즉 $\boldsymbol{S}\boldsymbol{b}_i = \lambda_i\boldsymbol{b}_i$ 를 고려하자. 일반적으로,
$\quad$ 두 가지 경우를 구분한다. 만약 $i \ge m$ 이면, 즉 $\boldsymbol{b}_i$ 가 첫 $m - 1$ 개 주성분에 포함되지 않는 고유벡터라면, $\boldsymbol{b}_i$ 는 첫 $m - 1$ 개 주성분과 직교하며 $\boldsymbol{B}_{m-1}\boldsymbol{b}_i = \boldsymbol{0}$ 이다. 만약 $i < m$ 이면, 즉 $\boldsymbol{b}_i$ 가 첫 $m - 1$ 개 주성분 중 하나라면, $\boldsymbol{b}_i$ 는 $\boldsymbol{B}_{m-1}$ 이 투영하는 주 부분공간(principal subspace)의 기저 벡터이다. $\boldsymbol{b}_1, \dots, \boldsymbol{b}_{m-1}$ 이 이 주 부분공간의 정규 직교 기저이므로 $\boldsymbol{B}_{m-1}\boldsymbol{b}_i = \boldsymbol{b}_i$ 를 얻는다. 두 경우는 다음과 같이 요약된다.
$i \ge m$ 인 경우, (10.19b)에 (10.20)을 사용하여 $\hat{\boldsymbol{S}}\boldsymbol{b}_i = (\boldsymbol{S} - \boldsymbol{B}_{m-1}\boldsymbol{S})\boldsymbol{b}_i = \boldsymbol{S}\boldsymbol{b}_i = \lambda_i\boldsymbol{b}_i$ 를 얻는다. 즉, $\boldsymbol{b}_i$ 는 고윳값 $\lambda_i$ 를 가지는 $\hat{\boldsymbol{S}}$ 의 고유벡터이기도 하다. 구체적으로,
식 (10.21)은 $\boldsymbol{b}_m$ 이 $\boldsymbol{S}$ 의 고유벡터일 뿐만 아니라 $\hat{\boldsymbol{S}}$ 의 고유벡터임을 밝힌다. 구체적으로, $\lambda_m$ 은 $\hat{\boldsymbol{S}}$ 의 가장 큰 고윳값이며 $\boldsymbol{S}$ 의 $m$ 번째로 큰 고윳값이고, 둘 다 대응하는 고유벡터 $\boldsymbol{b}_m$ 을 가진다.
$\quad$ $i < m$ 인 경우, (10.19b)에 (10.20)을 사용하여 다음을 얻는다.
이는 $\boldsymbol{b}_1, \dots, \boldsymbol{b}_{m-1}$ 또한 $\hat{\boldsymbol{S}}$ 의 고유벡터이지만, 고윳값 0과 연관되어 있으므로 $\boldsymbol{b}_1, \dots, \boldsymbol{b}_{m-1}$ 이 $\hat{\boldsymbol{S}}$ 의 영공간(null space)을 생성함을 의미한다.
$\quad$ 종합하면, $\boldsymbol{S}$ 의 모든 고유벡터는 $\hat{\boldsymbol{S}}$ 의 고유벡터이기도 하다. 그러나 $\boldsymbol{S}$ 의 고유벡터가 $(m - 1)$ 차원 주 부분공간의 일부인 경우, $\hat{\boldsymbol{S}}$ 의 대응하는 고윳값은 0이다.
$\quad$ 식 (10.21)과 $\boldsymbol{b}_m^\top \boldsymbol{b}_m = 1$ 의 관계를 통해, 데이터가 $m$ 번째 주성분으로 투영되었을 때의 분산은 다음과 같다.
이는 데이터를 $M$ 차원 부분공간에 투영했을 때의 데이터 분산이 데이터 공분산 행렬의 대응하는 고유벡터와 연관된 고윳값들의 합과 동일함을 의미한다.
이 유도는 최대 분산을 가지는 $M$ 차원 부분공간과 고윳값 분해 사이에 밀접한 연관성이 있음을 보여준다. 10.4절에서 이 연관성을 다시 살펴볼 것이다.
예제 10.2 (MNIST “8”의 고윳값)
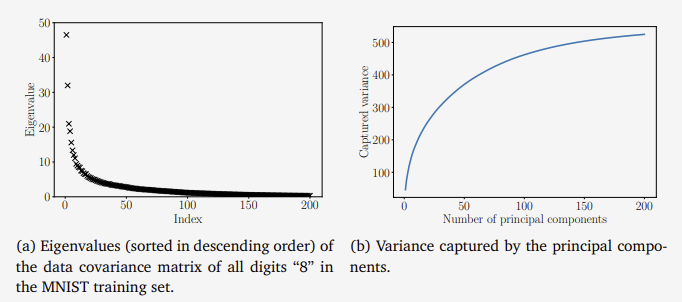
(그림 10.5) MNIST “8” 훈련 데이터의 성질. (a) 내림차순으로 정렬된 고윳값. (b) 가장 큰 고윳값과 연관된 주성분들에 의해 포착된 분산.
MNIST 훈련 데이터 내의 모든 “8” 숫자를 취하여 데이터 공분산 행렬의 고윳값을 계산한다. 그림 10.5(a)는 데이터 공분산 행렬의 가장 큰 200개 고윳값을 보여준다. 오직 소수의 고윳값만이 0과 유의미하게 다른 값을 가짐을 관찰할 수 있다. 따라서 데이터를 대응하는 고유벡터가 생성하는 부분공간으로 투영할 때, 그림 10.5(b)에 나타난 바와 같이 대부분의 분산은 오직 소수의 주성분들에 의해서만 포착된다.
$\quad$ 결과적으로, 가능한 한 많은 정보를 보존하는 $\mathbb{R}^D$ 의 $M$ 차원 부분공간을 찾기 위해, PCA는 (10.3)의 행렬 $\boldsymbol{B}$ 의 열들을 데이터 공분산 행렬 $\boldsymbol{S}$ 의 가장 큰 $M$ 개 고윳값과 연관된 $M$ 개의 고유벡터로 선택하라고 지시한다. 첫 $M$ 개의 주성분으로 PCA가 포착할 수 있는 분산의 최댓값은 다음과 같다.
여기서 $\lambda_m$ 은 데이터 공분산 행렬 $\boldsymbol{S}$ 의 가장 큰 $M$ 개의 고윳값이다. 결과적으로, PCA를 통한 데이터 압축으로 인해 손실되는 분산은 다음과 같다.
이러한 절대적인 양 대신, 포착된 상대 분산을 $\frac{V_M}{V_D}$ 로, 압축에 의해 손실된 상대 분산(직교 투영 오차의 비율)을 $1 - \frac{V_M}{V_D}$ 로 정의할 수 있다.
$\to$ 고윳값의 단순 합산(대각합, trace)인 절대 분산 $V_M$ 은 원본 데이터의 스케일 및 측정 단위에 종속적이다. 반면 상대 분산은 $[0,1]$ 구간의 스카라 값으로 정규화되어, 데이터의 스케일과 무관하게 차우너 축소의 효율을 평가하는 객관적인 기준이 된다.
실제 차원 축소 알고리즘 설계 시, 상대 분산은 최적의 병목 차원 $M$ 을 결정하는 임계값(threshold)으로 기능한다. 특정 정보 보존율(예: $\frac{V_M}{V_D} \ge 0.95$ )을 만족하는 최소의 $M$ 을 도출하여 연산 효율성과 정보 손실 사이 균형점을 산출할 수 있다.