2장과 3장에서, 우리는 벡터를 조작하고 측정하는 방법, 벡터의 투영, 그리고 선형 사상에 대해 공부했다. 벡터의 사상과 변환은 행렬에 의해 수행되는 연산으로서 편리하게 기술될 수 있다. 게다가, 데이터 또한 종종 행렬 형태로 표현된다. 예를 들어, 행렬의 행(row)은 서로 다른 사람들을 나타내고, 열(column)은 몸무게, 키, 사회경제적 지위와 같은 사람들의 서로 다른 특징(feature)들을 기술한다. 이 장에서, 우리는 행렬의 세 가지 측면을 제시한다: 행렬을 요약하는 법, 행렬을 분해하는 법, 그리고 이러한 분해들이 행렬 근사에 어떻게 사용되는지이다.
$\quad$ 우리는 먼저 행렬의 전반적인 성질을 특징짓는 단 몇 개의 숫자만으로 행렬을 기술할 수 있게 해주는 방법들을 고려한다. 우리는 이것을 정사각 행렬이라는 중요한 특수한 경우에 대해 행렬식(Determinant, 4.1절)과 고유값(Eigenvalues, 4.2절) 섹션에서 다룰 것이다. 이러한 특징적인 숫자들은 중요한 수학적 귀결을 가지며 행렬이 어떤 유용한 성질을 가졌는지 우리가 빠르게 파악할 수 있게 해 준다.
여기서부터 우리는 행렬 분해 방법으로 나아갈 것이다. 행렬 분해에 대한 비유는 $21$ 을 소수 $7 \cdot 3$ 으로 인수분해하는 것과 같은 숫자의 인수분해(factoring)이다. 이러한 이유로 행렬 분해는 종종 행렬 인수분해(matrix factorization)라고도 불린다. 행렬 분해는 해석 가능한 행렬들의 인수(factor)를 사용하여 다른 표현 방식으로 행렬을 기술하는 데 사용된다.
$\quad$ 우리는 먼저 대칭 양의 정부호 행렬(symmetric, positive definite matrices)에 대한 제곱근과 유사한 연산인 숄레스키 분해(Cholesky decomposition, 4.3절)를 다룰 것이다. 여기서부터 우리는 행렬을 표준형(canonical forms)으로 인수분해하는 두 가지 관련된 방법을 살펴볼 것이다. 첫 번째는 행렬 대각화(Matrix diagonalization, 4.4절)로 알려져 있으며, 이는 우리가 적절한 기저를 선택한다면 대각 변환 행렬을 사용하여 선형 사상을 표현할 수 있게 해 준다. 두 번째 방법인 특이값 분해(SVD, Singular Value Decomposition, 4.5절)는 이 인수분해를 정사각형이 아닌 행렬로 확장하며, 선형대수학의 근본적인 개념 중 하나로 여겨진다. 이러한 분해들은 수치 데이터를 나타내는 행렬들이 종종 매우 크고 분석하기 어렵기 때문에 유용하다. 우리는 행렬의 유형과 그들을 구별하는 특징적인 성질들에 대한 체계적인 개요인 행렬 분류 체계(Matrix taxonomy, 4.7절)로 이 장을 마무리한다.
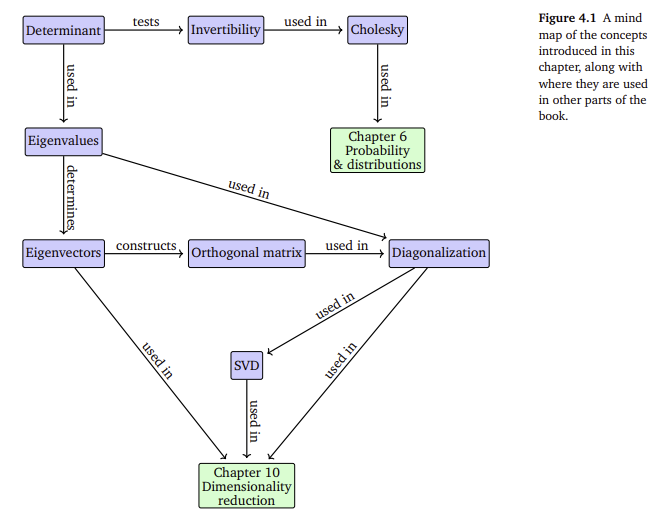
$\quad$ 이 장에서 우리가 다루는 방법들은 이어지는 수학적 챕터들(예: 6장 확률)뿐만 아니라, 차원 축소(10장)나 밀도 추정(11장)과 같은 응용 챕터들에서도 중요하게 사용될 것이다. 4장의 전체 구조는 그림 4.1와 같다.