문제 공식화
관측 노이즈가 존재하기 때문에, 우리는 확률론적 접근법을 채택하고 우도 함수를 사용하여 노이즈를 명시적으로 모델링할 것이다. 보다 구체적으로, 이 장 전체에 걸쳐 우리는 다음과 같은 우도 함수를 가지는 회귀 문제를 고려한다.
여기서 $\boldsymbol{x} \in \mathbb{R}^D$ 는 입력이고 $y \in \mathbb{R}$ 는 노이즈가 있는 함수 값(타깃)이다. (9.1)과 함께, $\boldsymbol{x}$ 와 $y$ 사이의 함수 관계는 다음과 같이 주어진다.
여기서 $\epsilon \sim \mathcal{N}(0, \sigma^2)$ 은 평균이 0이고 분산이 $\sigma^2$ 인 독립 항등 분포(i.i.d.) 가우시안 측정 노이즈이다. 우리의 목표는 데이터를 생성한 알려지지 않은 함수 $f$ 에 가깝고(유사하고) 일반화가 잘 되는 함수를 찾는 것이다.
$\quad$ 이 장에서 우리는 모수적 모델에 초점을 맞춘다. 즉, 매개변수화된 함수를 선택하고 데이터를 모델링하는 데 “잘 작동하는” 매개변수 $\boldsymbol{\theta}$ 를 찾는다. 당분간 우리는 노이즈 분산 $\sigma^2$ 이 알려져 있다고 가정하고 모델 매개변수 $\boldsymbol{\theta}$ 를 학습하는 데 집중한다. 선형 회귀에서 우리는 매개변수 $\boldsymbol{\theta}$ 가 모델에 선형적으로 나타나는 특수한 경우를 고려한다. 선형 회귀의 한 예시는 다음과 같이 주어진다.
여기서 $\boldsymbol{\theta} \in \mathbb{R}^D$ 는 우리가 찾는 매개변수이다. (9.4)에 의해 설명되는 함수 클래스는 원점을 지나는 직선이다. (9.4)에서 우리는 매개변수화 $f(\boldsymbol{x}) = \boldsymbol{x}^\top \boldsymbol{\theta}$ 를 선택했다.
$\to$ “노이즈 분산 $\sigma^2$ 이 알려져 있다고 가정”하는 것은, 어차피 우도 함수를 최대화할 때 매개변수로 미분하면 이는 사라질 상수이기 때문이다.
노이즈 분산을 추정하는 것은 9.2.1절에서 다룬다.
$\to$ 식 (9.4)의 함수가 원점을 지난다는 것은, (아직) 편향을 고려하지 않았을 수도 있지만, 보통 편향은 기울기와 함께 다룬다.
원래 데이터 공간에서 선형 방정식은 $y = \theta_1 x_1 + \dots + \theta_{D-1} x_{D-1} + b$ 이다. 이는 기하학적으로 $D-1$ 차원에서 아핀 평면(원점을 지나지 않는)이다.
이때 손실함수를 매개변수에 대해 편미분하려면 기울기와 편향을 따로 미분해야 하는데, $D-1$ 차원 입력 벡터 맨 앞에 1 데이터를 추가하고( $\boldsymbol{x} = [1, x_1, x_2, \dots, x_{D-1}]^\top \in \mathbb{R}^D$ ), 가중치 벡터 또한 맨 앞에 편향 $b$ 를 $\theta_0$ 로 치환하여 맨 앞에 추가한다( $\boldsymbol{\theta} = [\theta_0, \theta_1, \dots, \theta_{D-1}]^\top \in \mathbb{R}^D$ ).
결과적으로 손실함수를 $\boldsymbol{\theta}$ 로 편미분하면 편향과 기울기를 동시에 최적화 가능하다.
또한 이는 기하학적으로 $y = \boldsymbol{x}^\top \boldsymbol{\theta}$ 는 $D$ 차원에서 원점을 지나는 초평면이다.
$\quad$ (9.3)의 우도는 $\boldsymbol{x}^\top \boldsymbol{\theta}$ 에서 평가된 $y$ 의 확률 밀도 함수이다. 오직 관측 노이즈에서만 불확실성이 기인한다는 점에 유의해야 한다((9.3)에서 $\boldsymbol{x}$ 와 $\boldsymbol{\theta}$ 는 알려져 있다고 가정하므로). 관측 노이즈가 없다면 $\boldsymbol{x}$ 와 $y$ 의 관계는 결정론적일 것이며 (9.3)은 디랙 델타(Dirac delta)가 될 것이다.
디랙 델타(델타 함수)는 단일 지점을 제외한 모든 곳에서 0이며, 적분값은 1이다. 이는 $\sigma^2 \to 0$ 인 극한에서의 가우시안으로 간주할 수 있다.
$\to$ 식 (9.4)는 확률변수의 변환을 의미한다. 평균이 0인 정규분포에 결정론적인 선형 함수 $\boldsymbol{x}^\top \boldsymbol{\theta}$ 를 더하면 분포의 모양은 유지된 채 평균(분포의 중심)은 0에서 $\boldsymbol{x}^\top \boldsymbol{\theta}$ 로 평행이동하게 된다. 따라서 target $y$ 또한 확률 변수가 된다( $y \sim \mathcal{N}(\boldsymbol{x}^\top \boldsymbol{\theta}, \sigma^2)$ ). 우도를 최대화한다는 것은 관측된 $y$ 가 우연히 나왔을 법한 함수(우리가 추정한 $\mathcal{N}(\boldsymbol{x}^\top \boldsymbol{\theta}, \sigma^2)$ )를 찾는 것이다.
$\to$ 리마인드하자면, 식 9.3(가우시안 우도)에 음의 로그를 취해 MSE를 유도할 수 있다.
MSE를 최소화한다는 것은, 데이터에 포함된 관측할 수 없는 노이즈가 가우시안임을 가정한 것과 같다.
$\to$ 분산이 0이라는 것은, pdf가 pmf로 취급되는 것인가?
엄밀하게는 결정론적인 특수한 pdf로 보는게 맞다.
pmf는 특정 값에서의 확률질량이 $0 \le P \le 1$ 이며, 이 질량들을 모두 더하면 1이 된다.
반면 pdf의 정의역은 실수 전체이며, 분산이 0이 되어 폭이 좁아지면, 그 지점( $x = \mu$ )에서의 확률 밀도는 무한대로 발산한다. 그러나 여전히 이를 적분하면 1이 된다( $\int \delta(x) dx = 1$ ).
연속적인 실수 공간에서 $\mu$ 말고 그 어떤 오차를 허용하지 않겠다는 어떤 확고함을 표현하기 위해 극한의 개념을 빌려왔다고 볼 수 있다. 베이지안들은 어떤 결정론적인 함수조차 사실 노이즈가 0인 확률론적 우도 함수의 극단적인 형태로 해석한다.
예제 9.1
$x, \theta \in \mathbb{R}$ 에 대해 (9.4)의 선형 회귀 모델은 직선(선형 함수)을 설명하며, 매개변수 $\theta$ 는 선의 기울기이다. 그림 9.2(a)는 $\theta$ 의 다른 값들에 대한 몇 가지 예시 함수들을 보여준다.
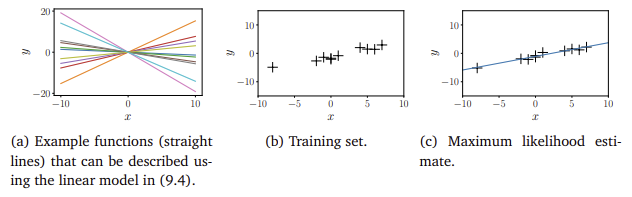
$\quad$ (9.3)-(9.4)의 선형 회귀 모델은 매개변수 측면에서 선형일 뿐만 아니라, 입력 $x$ 측면에서도 선형이다. 그림 9.2(a)는 이러한 함수들의 예시를 보여준다. 비선형 변환 $\phi$ 에 대한 $y = \phi^\top(\boldsymbol{x})\boldsymbol{\theta}$ 역시 선형 회귀 모델임을 나중에 보게 될 것인데, 왜냐하면 “선형 회귀”는 “매개변수에 대해 선형인” 모델, 즉 입력 특성들의 선형 결합으로 함수를 설명하는 모델을 지칭하기 때문이다. 여기서 “특성”은 입력 $x$ 의 표현 $\phi(x)$ 이다.
$\quad$ 다음에서 우리는 좋은 매개변수 $\theta$ 를 찾는 방법과 매개변수 집합이 “잘 작동하는지” 평가하는 방법에 대해 더 자세히 논의할 것이다. 당분간 우리는 노이즈 분산 $\sigma^2$ 이 알려져 있다고 가정한다.
$\to$ “매개변수에 대해 선형이다”라는 것은 우리가 찾고자 하는게 단순 직선뿐만이 아니라는 뜻이다. 만약 입력 데이터 $x$ 를 변환 함수 $\phi$ 를 통해 다음과 같이 정의했다고 가정해보자.
여기에 매개변수 $\boldsymbol{\theta}$ 를 내적( $\phi^\top(x)\boldsymbol{\theta}$ )해서 얻은 방정식은 비선형 곡선(다항 회귀)이다.
선형 회귀에서 ‘선형’은 입력 데이터의 모양을 제한하는게 아닌, 우리가 최적화하고자 하는 $\boldsymbol{\theta}$ 가 서로 어떻게 결합되어 있는가를 규정하는 것이다.
이는 매개변수끼리의 어떤 선형 결합( $y = \theta_1 \phi_1 + \theta_2 \phi_2$ )을 찾는다고 생각해볼 수 있겠다. $y = e^{\theta_1 x} + \theta_1\theta_2 x$ 의 형태는 매개변수들의 비선형결합이다.
매개변수들이 선형 결합으로 표현되면, 파라미터 공간은 convex한 공간이며, 손실 함수를 매개변수에 대해 미분했을 때 방정식이 하나인 연립일차방정식의 해를 구하는 것은 매우 쉽다.