확률은, 대략적으로 말하자면, 불확실성(uncertainty)에 대한 연구와 관련이 있다. 확률은 어떤 사건이 발생하는 횟수의 비율(fraction of times)로 생각할 수도 있고, 또는 어떤 사건에 대한 믿음의 정도(degree of belief)로 생각할 수도 있다. 그런 다음 우리는 이 확률을 사용하여 실험에서 무언가가 발생할 가능성을 측정하고자 한다. 1장에서 언급했듯이, 우리는 종종 데이터의 불확실성, 머신러닝 모델의 불확실성, 그리고 모델이 생성한 예측의 불확실성을 정량화한다. 불확실성을 정량화하려면 확률 변수(random variable)라는 개념이 필요한데, 이는 무작위 실험의 결과들을 우리가 관심 있는 속성들의 집합으로 매핑하는 함수이다. 이 확률 변수와 연관되어, 특정 결과(또는 결과들의 집합)가 발생할 확률을 측정하는 함수가 존재하며, 이를 확률 분포(probability distribution)라고 부른다.
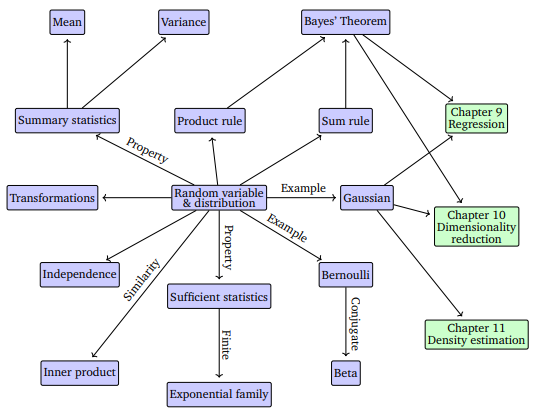
$\quad$ 확률 분포는 확률적 모델링(8.4절), graphcal model(8.5절), 모델 선택(8.6절)과 같은 다른 개념들을 구축하기 위한 구성 요소로 사용된다. 다음 절에서는 확률 공간(probability space)을 정의하는 세 가지 개념(표본 공간, 사건, 사건의 확률)을 제시하고, 이들이 확률 변수라고 불리는 네 번째 개념과 어떻게 연관되는지 살펴본다. 엄밀한 수학적 제시는 개념 이면에 있는 직관을 가릴 수 있기 때문에, 여기서의 설명은 의도적으로 약간 느슨하게(hand wavy) 진행된다. 이 장에서 제시되는 개념들의 개요는 그림 6.1에 나타나 있다.