투영 관점
다음에서, 우리는 평균 재구성 오차(average reconstruction error)를 직접적으로 최소화하는 알고리즘으로서 PCA를 유도할 것이다. 이러한 관점은 PCA를 최적의 선형 오토인코더(optimal linear auto-encoder)를 구현하는 것으로 해석할 수 있게 해준다. 우리는 2장과 3장의 내용을 크게 활용할 것이다.
$\quad$ 이전 절에서, 우리는 가능한 한 많은 정보를 보존하기 위해 사영된 공간에서의 분산을 최대화함으로써 PCA를 유도했다. 다음에서, 우리는 원본 데이터 $\boldsymbol{x}_n$ 과 이들의 재구성 $\tilde{\boldsymbol{x}}_n$ 사이의 차이 벡터(difference vectors)를 살펴보고, 이 거리를 최소화하여 $\boldsymbol{x}_n$ 과 $\tilde{\boldsymbol{x}}_n$ 이 가능한 한 가까워지도록 할 것이다. 그림 10.6은 이 설정을 보여준다.
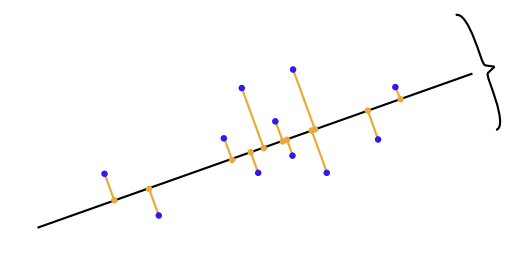
(그림 10.6) 투영 접근법의 예시: 사영된 데이터(주황색)와 원본 데이터(파란색) 사이의 차이 벡터 길이를 최소화하는 부분공간(선)을 찾는다.
10.3.1 Setting and Objective
설정 및 목적
$\mathbb{R}^D$ 의 (정렬된) 정규 직교 기저(ONB) $B = (\boldsymbol{b}_1, \dots, \boldsymbol{b}_D)$ 를 가정하자. 즉, $i = j$ 일 때만 $\boldsymbol{b}_i^\top \boldsymbol{b}_j = 1$ 이고, 그 외의 경우는 0이다.
$\quad$ 2.5절에 따라 $\mathbb{R}^D$ 의 기저 $(\boldsymbol{b}_1, \dots, \boldsymbol{b}_D)$ 에 대해 임의의 $\boldsymbol{x} \in \mathbb{R}^D$ 는 $\mathbb{R}^D$ 기저 벡터들의 선형 결합으로 작성될 수 있다. 즉, 적절한 좌표 $\zeta_d \in \mathbb{R}$ 에 대해 다음이 성립한다.
(벡터 $\tilde{\boldsymbol{x}} \in U$ 는 $\mathbb{R}^3$ 공간 내의 평면 위에 있는 벡터일 수 있다. 평면의 차원은 2이지만, 이 벡터들은 여전히 $\mathbb{R}^3$ 의 표준 기저에 대해 3개의 좌표를 가진다.)
$\quad$ 우리의 관심사는 저차원 부분공간 $U \subseteq \mathbb{R}^D, \dim(U) = M$ 에 존재하는 벡터 $\tilde{\boldsymbol{x}} \in \mathbb{R}^D$ 를 찾아,
이 $\boldsymbol{x}$ 와 최대한 유사해지도록 만드는 것이다. 이 시점에서는 $\tilde{\boldsymbol{x}}$ 의 좌표 $z_m$ 과 $\boldsymbol{x}$ 의 좌표 $\zeta_m$ 이 동일하지 않다고 가정해야 함에 유의하라.
$\to$ 목표는 $\boldsymbol{x}$ 와의 거리 오차를 최소화하는 위치 $z_m$ 을 찾는 것이다. 기하학적 직관으로는 부분공간 위에서 가장 가까운 점이 되려면 당연히 $\boldsymbol{x}$ 에서 수직으로 수선의 발을 내린 곳, 즉 원본의 투영 좌표인 $\zeta_m$ 의 위치에 $\tilde{\boldsymbol{x}}$ 가 되어야 한다는 것을 알지만, 이러한 직관이 없는 상황에서 오차를 최소화하는 최적의 $z_m$ 은 $\zeta_m$ 과 일치함을 유도하기 위해 $z_m$ 과 $\zeta_m$ 이 동일하지 않다고 가정한다.
$\quad$ 다음에서, 우리는 $\tilde{\boldsymbol{x}}$ 가 원본 데이터 포인트 $\boldsymbol{x}$ 와 가능한 한 유사해지도록, 즉 (유클리드) 거리 $\vert \boldsymbol{x} - \tilde{\boldsymbol{x}}\vert$ 를 최소화하는 최적의 좌표 $\boldsymbol{z}$ 와 기저 벡터 $\boldsymbol{b}_1, \dots, \boldsymbol{b}_M$ 을 찾기 위해 바로 이러한 형태의 $\tilde{\boldsymbol{x}}$ 표현을 사용할 것이다. 그림 10.7은 이 설정을 묘사한다.
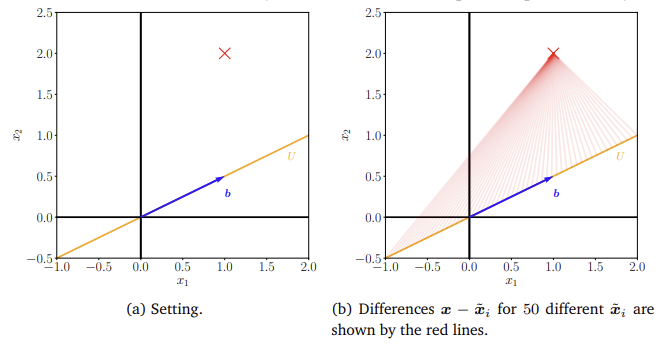
(그림 10.7) 단순화된 사영 설정. (a) $\mathbb{R}^2$ 의 벡터 $\boldsymbol{x}$ (빨간색 십자)가 $\boldsymbol{b}$ 에 의해 생성되는 1차원 부분공간 $U \subseteq \mathbb{R}^2$ 로 사영되어야 한다. (b) $\boldsymbol{x}$ 와 50개의 서로 다른 후보 $\tilde{\boldsymbol{x}}_i$ 들 사이의 차이 벡터를 빨간색 선으로 보여준다.
$\quad$ 일반성을 잃지 않고, 데이터셋 $\mathcal{X} = {\boldsymbol{x}_1, \dots, \boldsymbol{x}_N}, \boldsymbol{x}_n \in \mathbb{R}^D$ 의 중심이 $\boldsymbol{0}$ 에 맞춰져 있다고 가정한다. 즉, $\mathbb{E}[\mathcal{X}] = \boldsymbol{0}$ 이다. 영점-평균 가정이 없더라도 정확히 동일한 해에 도달하지만, 표기법이 상당히 복잡해질 것이다.
$\quad$ 우리는 $\mathcal{X}$ 를 $\dim(U) = M$ 이고 정규 직교 기저 벡터 $\boldsymbol{b}_1, \dots, \boldsymbol{b}_M$ 을 가지는 $\mathbb{R}^D$ 의 저차원 부분공간 $U$ 로 선형 사영하는 최적의 방법을 찾는 데 관심이 있다. 이 부분공간 $U$ 를 주 부분공간(principal subspace)이라 부를 것이다. 데이터 포인트의 사영은 다음과 같이 표기된다.
여기서 $\boldsymbol{z}_n := [z_{1n}, \dots, z_{Mn}]^\top \in \mathbb{R}^M$ 은 기저 $(\boldsymbol{b}_1, \dots, \boldsymbol{b}_M)$ 에 대한 $\tilde{\boldsymbol{x}}_n$ 의 좌표 벡터이다. 더 구체적으로, 우리는 $\tilde{\boldsymbol{x}}_n$ 이 $\boldsymbol{x}_n$ 과 최대한 유사해지기를 원한다.
$\quad$ 다음에서 우리가 사용하는 유사도 척도는 $\boldsymbol{x}$ 와 $\tilde{\boldsymbol{x}}$ 사이의 제곱 거리(유클리드 노름) $\Vert \boldsymbol{x} - \tilde{\boldsymbol{x}}\Vert ^2$ 이다. 따라서 우리의 목적 함수를 평균 제곱 유클리드 거리(재구성 오차(reconstruction error))를 최소화하는 것으로 정의한다 (Pearson, 1901).
여기서 데이터를 사영할 부분공간의 차원이 $M$ 임을 명시적으로 나타낸다. 이 최적의 선형 사영을 찾기 위해, 우리는 주 부분공간의 정규 직교 기저와 이 기저에 대한 사영의 좌표 $\boldsymbol{z}_n \in \mathbb{R}^M$ 을 찾아야 한다.
$\quad$ 좌표 $\boldsymbol{z}_n$ 과 주 부분공간의 정규 직교 기저(ONB)를 찾기 위해, 우리는 2단계 접근법(two-step approach)을 따른다. 첫째, 주어진 ONB $(\boldsymbol{b}_1, \dots, \boldsymbol{b}_M)$ 에 대해 좌표 $\boldsymbol{z}_n$ 을 최적화한다. 둘째, 최적의 ONB를 찾는다.
10.3.2 Finding Optimal Coordinates
최적의 좌표 탐색
먼저 $n = 1, \dots, N$ 에 대한 사영 $\tilde{\boldsymbol{x}}_n$ 의 최적 좌표 $z_{1n}, \dots, z_{Mn}$ 을 찾는 것으로 시작하자. 주 부분공간이 단일 벡터 $\boldsymbol{b}$ 에 의해 생성되는 그림 10.7(b)를 고려해 보자. 기하학적으로 말해서, 최적의 좌표 $z$ 를 찾는 것은 $\tilde{\boldsymbol{x}} - \boldsymbol{x}$ 사이의 거리를 최소화하는 $\boldsymbol{b}$ 에 대한 선형 사영 $\tilde{\boldsymbol{x}}$ 의 표현을 찾는 것에 해당한다. 그림 10.7(b)에서 이것이 직교 사영(orthogonal projection)이 될 것임이 명백하며, 다음에서 우리는 정확히 이를 보여줄 것이다.
$\quad$ $U \subseteq \mathbb{R}^D$ 의 정규 직교 기저(ONB) $(\boldsymbol{b}_1, \dots, \boldsymbol{b}M)$ 을 가정하자. 이 기저에 대한 최적의 좌표 $z_m$ 을 찾기 위해, 우리는 다음의 편도함수들이 필요하다.
여기서 $i = 1, \dots, M$ 이며, 이를 통해 다음을 얻는다.
이는 $\boldsymbol{b}_i^\top \boldsymbol{b}_i = 1$ 이기 때문이다(식 ( $10.31a$ )에서 $m \neq i$ 일 때: $\boldsymbol{b}_m^\top \boldsymbol{b}_i = 0$ 이므로 나머지 항 제거). 이 편도함수를 $0$ 으로 설정하면 즉시 최적의 좌표를 얻는다.
( $i = 1, \dots, M$ 이고 $n = 1, \dots, N$ ). 이는 사영 $\tilde{\boldsymbol{x}}_n$ 의 최적 좌표 $z_{in}$ 이 원본 데이터 포인트 $\boldsymbol{x}_n$ 을 $\boldsymbol{b}_i$ 에 의해 생성되는 1차원 부분공간으로 직교 사영(3.8절 참조)한 좌표임을 의미한다. 결과적으로:
- $\boldsymbol{x}_n$ 의 최적 선형 사영 $\tilde{\boldsymbol{x}}_n$ 은 직교 사영이다.
- 기저 $(\boldsymbol{b}_1, \dots, \boldsymbol{b}_M)$ 에 대한 $\tilde{\boldsymbol{x}}_n$ 의 좌표는 $\boldsymbol{x}_n$ 을 주 부분공간으로 직교 사영한 좌표이다.
- 직교 사영은 목적 함수 (10.29)가 주어졌을 때 최상의 선형 매핑이다.
- $U^\perp = \text{span}[\boldsymbol{b}_{M+1}, \dots, \boldsymbol{b}_D]$ 가 $U = \text{span}[\boldsymbol{b}_1, \dots, \boldsymbol{b}_M]$ 의 직교 여공간(orthogonal complement, 3.6절 참조)이므로, $m = 1, \dots, M$ 에 대해 (10.26)의 $\boldsymbol{x}$ 의 좌표 $\zeta_m$ 과 (10.27)의 $\tilde{\boldsymbol{x}}$ 의 좌표 $z_m$ 은 반드시 동일해야 한다.
(기저 벡터 $\boldsymbol{b}_1, \dots, \boldsymbol{b}_M$ 에 대한 $\boldsymbol{x}_n$ 의 최적 사영의 좌표는 $\boldsymbol{x}_n$ 을 주 부분공간으로 직교 사영한 좌표이다.)
Remark (정규 직교 기저 벡터를 사용한 직교 사영). 3.8절의 직교 사영을 잠시 복습해 보자. $(\boldsymbol{b}_1, \dots, \boldsymbol{b}_D)$ 가 $\mathbb{R}^D$ 의 정규 직교 기저라면,
는 $\boldsymbol{x}$ 를 $j$ 번째 기저 벡터에 의해 생성되는 부분공간으로 직교 사영한 것이며, $z_j\boldsymbol{b}_j = \tilde{\boldsymbol{x}}$ 이므로 $z_j = \boldsymbol{b}_j^\top \boldsymbol{x}$ 는 해당 부분공간을 생성하는 기저 벡터 $\boldsymbol{b}_j$ 에 대한 이 사영의 좌표이다. 그림 10.8(b)가 이 설정을 묘사한다.
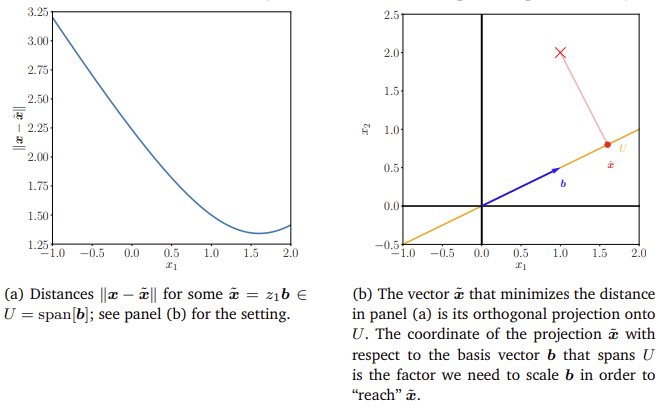
(그림 10.8) $\mathbb{R}^2$ 의 벡터 $\boldsymbol{x}$ 를 1차원 부분공간으로 최적 사영 (그림 10.7에서 이어짐). (a) 일부 $\tilde{\boldsymbol{x}} \in U$ 에 대한 거리 $\Vert \boldsymbol{x} - \tilde{\boldsymbol{x}}\Vert$ . (b) 직교 사영과 최적 좌표.
( $\boldsymbol{b}_j^\top \boldsymbol{x}$ 는 $\boldsymbol{x}$ 를 $\boldsymbol{b}_j$ 에 의해 생성되는 부분공간으로 직교 사영한 좌표이다.)
$\quad$ 더 일반적으로, 우리가 $\mathbb{R}^D$ 의 $M$ 차원 부분공간으로 사영하고자 한다면, 정규 직교 기저 벡터 $\boldsymbol{b}_1, \dots, \boldsymbol{b}_M$ 을 가진 $M$ 차원 부분공간으로의 $\boldsymbol{x}$ 의 직교 사영을 다음과 같이 얻는다.
여기서 $\boldsymbol{B} := [\boldsymbol{b}_1, \dots, \boldsymbol{b}_M] \in \mathbb{R}^{D \times M}$ 으로 정의했다. 정렬된 기저 $(\boldsymbol{b}_1, \dots, \boldsymbol{b}_M)$ 에 대한 이 사영의 좌표는 3.8절에서 논의한 바와 같이 $\boldsymbol{z} := \boldsymbol{B}^\top \boldsymbol{x}$ 이다.
$\quad$ 우리는 이 좌표들을 $(\boldsymbol{b}_1, \dots, \boldsymbol{b}_M)$ 에 의해 정의된 새로운 좌표계에서 사영된 벡터의 표현으로 생각할 수 있다. 비록 $\tilde{\boldsymbol{x}} \in \mathbb{R}^D$ 이지만, 이 벡터를 표현하는 데는 오직 $M$ 개의 좌표 $z_1, \dots, z_M$ 만 필요함에 유의하라. 기저 벡터 $(\boldsymbol{b}_{M+1}, \dots, \boldsymbol{b}_D)$ 에 대한 나머지 $D - M$ 개의 좌표는 항상 $0$ 이다.
$\quad$ 지금까지 우리는 주어진 정규 직교 기저(ONB)에 대해 주 부분공간으로의 직교 사영을 통해 $\tilde{\boldsymbol{x}}$ 의 최적 좌표를 찾을 수 있음을 보였다. 다음에서 우리는 무엇이 최적의 기저인지 결정할 것이다.
10.3.3 Finding the Basis of the Principal Subspace
주 부분공간의 기저 탐색
주 부분공간의 기저 벡터 $\boldsymbol{b}_1, \dots, \boldsymbol{b}_M$ 을 결정하기 위해, 지금까지 얻은 결과를 사용하여 손실 함수 (10.29)를 재구성한다. 이는 기저 벡터를 찾는 것을 더 용이하게 한다. 손실 함수를 재구성하기 위해, 이전의 결과를 활용하여 다음을 얻는다.
이제 내적의 대칭성(symmetry of the dot product)을 활용하면, 다음이 산출된다.
내적의 대칭성: 두 벡터를 내적할 때 곱하는 순서를 바꾸어도 결과값은 동일하다.
기하학적으로 내적은 두 벡터의 크기와 그 사이각 $\theta$ 의 코사인 값을 곱한 것이다. ( $\Vert \boldsymbol{x}\Vert \Vert \boldsymbol{b}\Vert \cos\theta$ ) $\boldsymbol{x}$ 에서 $\boldsymbol{b}$ 를 바라보는 각도나, 반대로 $\boldsymbol{b}$ 에서 $\boldsymbol{x}$ 를 바라보는 각도나 그 크기( $\theta$ )는 동일하다.
식 (10.35)에서 (10.36)으로 유도되는 과정은 $(\boldsymbol{x}^\top \boldsymbol{b})\boldsymbol{b} \to \text(대칭성) \to (\boldsymbol{b}^\top \boldsymbol{x})\boldsymbol{b} \to \text(스칼라곱) \to \boldsymbol{b}(\boldsymbol{b}^\top \boldsymbol{x}) \to \text(행렬곱의 결합법칙) \to (\boldsymbol{b}\boldsymbol{b}^\top)\boldsymbol{x}$ .
원본 데이터 포인트 $\boldsymbol{x}_n$ 을 모든 기저 벡터의 선형 결합으로 전개할 수 있으므로, 다음이 성립한다.
여기서 $D$ 개 항의 합을 $M$ 개에 대한 합과 $D-M$ 개에 대한 합으로 분할했다. 이 결과를 바탕으로 변위 벡터(displacement vector) $\boldsymbol{x}_n - \tilde{\boldsymbol{x}}_n$ , 즉 원본 데이터 포인트와 그 사영 사이의 차이 벡터가 다음과 같음을 도출한다.
이는 차이가 정확히 데이터 포인트를 주 부분공간의 직교 여공간(orthogonal complement)으로 사영한 것임을 의미한다. (10.38a)의 행렬 $\sum_{j=M+1}^D \boldsymbol{b}_j\boldsymbol{b}_j^\top$ 을 이 사영을 수행하는 투영 행렬로 식별한다. 따라서 그림 10.9에 묘사된 바와 같이 변위 벡터 $\boldsymbol{x}_n - \tilde{\boldsymbol{x}}_n$ 은 주 부분공간에 직교하는 부분공간에 존재한다.
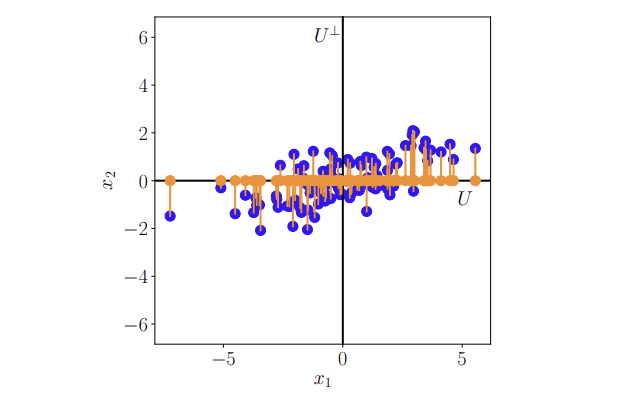
(그림 10.9) 직교 사영 및 변위 벡터. 데이터 포인트 $\boldsymbol{x}_n$ (파란색)을 부분공간 $U_1$ 으로 사영할 때, $\tilde{\boldsymbol{x}}_n$ (주황색)을 얻는다. 변위 벡터 $\tilde{\boldsymbol{x}}_n - \boldsymbol{x}_n$ 은 완전히 $U_1$ 의 직교 여공간 $U_2$ 에 존재한다.
Remark (저랭크 근사, Low-Rank Approximation). (10.38a)에서 $\boldsymbol{x}$ 를 $\tilde{\boldsymbol{x}}$ 로 사영하는 투영 행렬이 다음과 같이 주어짐을 확인했다.
행렬 $\boldsymbol{B}\boldsymbol{B}^\top$ 는 랭크-1(rank-one) 행렬 $\boldsymbol{b}_m\boldsymbol{b}_m^\top$ 들의 합으로 구성됨에 따라 대칭 행렬이며 랭크 $M$ 을 가짐을 알 수 있다. 따라서 평균 제곱 재구성 오차는 다음과 같이 기술된다.
원본 데이터 $\boldsymbol{x}_n$ 과 그 사영 $\tilde{\boldsymbol{x}}_n$ 사이의 차이를 최소화하는 정규 직교 기저 벡터 $\boldsymbol{b}_1, \dots, \boldsymbol{b}_M$ 을 찾는 것은, 단위 행렬 $\boldsymbol{I}$ 의 최적의 랭크- $M$ 근사 $\boldsymbol{B}\boldsymbol{B}^\top$ 를 찾는 것과 동치이다 (4.6절 참조).
(PCA는 단위 행렬의 최적 랭크- $M$ 근사를 찾는다.)
$\quad$ 이제 우리는 손실 함수 (10.29)를 재구성하기 위한 모든 도구를 갖추었다.
이제 제곱 노름을 명시적으로 계산하고 $\boldsymbol{b}_j$ 가 정규 직교 기저(ONB)를 형성한다는 사실을 활용하면 다음이 산출된다.
여기서 마지막 단계에서 내적의 대칭성을 활용하여 $\boldsymbol{b}_j^\top \boldsymbol{x}_n = \boldsymbol{x}_n^\top \boldsymbol{b}_j$ 로 작성했다. 이제 합의 순서를 바꾸어 다음을 얻는다.
여기서 대각합 연산자(trace operator) $\text{tr}(\cdot)$ (식 4.18 참조)가 선형적이며 인자들의 순환 치환(cyclic permutation)에 대해 불변이라는 성질을 활용했다. 데이터셋의 중심이 원점에 맞춰져 있다고 가정했으므로( $\mathbb{E}[\mathcal{X}] = \boldsymbol{0}$ ), $\boldsymbol{S}$ 를 데이터 공분산 행렬(data covariance matrix)로 식별한다. (10.43b)의 투영 행렬은 랭크-1 행렬 $\boldsymbol{b}_j \boldsymbol{b}_j^\top$ 들의 합으로 구성되므로 그 자체의 랭크는 $D - M$ 이다.
$\quad$ 식 (10.43a)는 평균 제곱 재구성 오차를 주 부분공간의 직교 여공간으로 사영된 데이터의 공분산 행렬로 동등하게 공식화할 수 있음을 의미한다. 따라서 평균 제곱 재구성 오차를 최소화하는 것은 우리가 무시하는 부분공간, 즉 주 부분공간의 직교 여공간으로 사영될 때 데이터의 분산을 최소화하는 것과 동치이다. 이는 동등하게 우리가 주 부분공간에 보존하는 사영의 분산을 최대화하는 것이며, 투영 손실을 10.2절에서 논의한 PCA의 최대 분산 공식과 즉시 연결한다. 그러나 이는 또한 최대 분산 관점에서 얻었던 것과 동일한 해를 얻게 될 것임을 의미한다. 따라서 10.2절에 제시된 것과 동일한 유도 과정은 생략하고, 투영 관점에 비추어 앞서 도출한 결과를 요약한다.
$\quad$ $M$ 차원 주 부분공간으로 사영할 때의 평균 제곱 재구성 오차는 다음과 같다.
여기서 $\lambda_j$ 는 데이터 공분산 행렬의 고윳값이다. 따라서 (10.44)를 최소화하려면 가장 작은 $D - M$ 개의 고윳값을 선택해야 하며, 이는 곧 그에 대응하는 고유벡터들이 주 부분공간의 직교 여공간의 기저임을 의미한다. 결과적으로, 이는 주 부분공간의 기저가 데이터 공분산 행렬의 가장 큰 $M$ 개의 고윳값과 연관된 고유벡터 $\boldsymbol{b}_1, \dots, \boldsymbol{b}_M$ 으로 구성됨을 의미한다.
(평균 제곱 재구성 오차를 최소화하는 것은 데이터 공분산 행렬의 주 부분공간의 직교 여공간으로의 사영을 최소화하는 것과 동치이다.)
(평균 제곱 재구성 오차를 최소화하는 것은 사영된 데이터의 분산을 최대화하는 것과 동치이다.)
예제 10.3 (MNIST 숫자 임베딩)
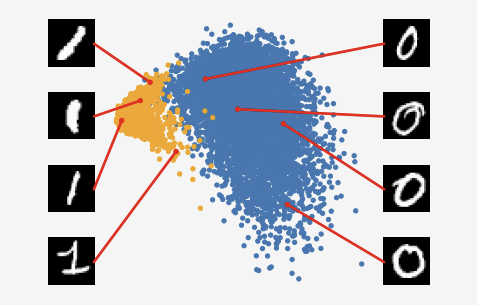
(그림 10.10. PCA를 사용하여 2차원 주 부분공간에 임베딩된 MNIST 숫자 0(파란색)과 1(주황색). 주 부분공간에 있는 숫자 “0”과 “1”의 임베딩 4개가 해당하는 원본 숫자 이미지와 함께 빨간색으로 강조 표시되어 있다.)
그림 10.10은 첫 두 개의 주성분(principal components)에 의해 생성된 벡터 부분공간에 임베딩된 MNIST 숫자 “0”과 “1”의 훈련 데이터를 시각화한다. “0”(파란색 점)과 “1”(주황색 점) 사이의 비교적 뚜렷한 분리(separation)를 관찰할 수 있으며, 각 개별 군집(cluster) 내의 변동성(variation)을 확인할 수 있다. 주 부분공간에 투영된 숫자 “0”과 “1”의 임베딩 4개가 해당하는 원본 숫자 이미지와 함께 빨간색으로 강조 표시되어 있다. 이 그림은 “0” 집합 내의 변동성이 “1” 집합 내의 변동성보다 유의미하게 크다는 것을 보여준다.