다음에서 우리는 선형 회귀(곡선 적합) 문제를 풀기 위해 2, 5, 6, 7장의 수학적 개념들을 적용할 것이다. 회귀에서 우리는 입력 $\boldsymbol{x} \in \mathbb{R}^D$ 를 대응하는 함수 값 $f(\boldsymbol{x}) \in \mathbb{R}$ 로 매핑하는 함수 $f$ 를 찾는 것을 목표로 한다. 우리는 훈련 입력 $\boldsymbol{x}_n$ 의 집합과 그에 대응하는 노이즈가 있는 관측치 $y_n = f(\boldsymbol{x}_n) + \epsilon$ 이 주어졌다고 가정하며, 여기서 $\epsilon$ 은 측정/관측 노이즈 및 잠재적으로 모델링되지 않은 과정(이 장에서는 더 이상 고려하지 않을 것임)을 설명하는 i.i.d. 확률 변수이다. 이 장 전체에 걸쳐 우리는 평균이 0인 가우시안 노이즈를 가정한다. 우리의 과제는 훈련 데이터를 모델링할 뿐만 아니라, 훈련 데이터의 일부가 아닌 입력 위치에서 함수 값을 예측하는 데 있어 일반화가 잘 되는 함수를 찾는 것이다(8장 참조).
$\to$ 노이즈가 평균이 0이고 유한한 분산을 가지는 가우시안을 따른다는 것은, 우도 함수 $p(y \mid \boldsymbol{x}, \boldsymbol{\theta})$ 자체가 함수 $f(\boldsymbol{x})$ 를 평균으로 하는 가우시안 분포임을 시사한다.(그림 9.1(b)의 주황색 정규분포들이 이를 시각화하였다.)
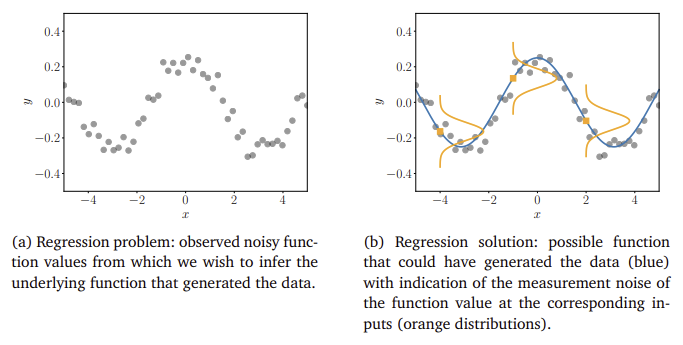
이러한 회귀 문제의 예시가 그림 9.1에 주어져 있다. 전형적인 회귀 설정은 그림 9.1(a)에 주어져 있다: 어떤 입력 값 $\boldsymbol{x}_n$ 에 대해, 우리는 (노이즈가 있는) 함수 값 $y_n = f(\boldsymbol{x}_n) + \epsilon$ 을 관측한다. 과제는 데이터를 생성했으며 새로운 입력 위치에서 함수 값으로 일반화가 잘 되는 함수 $f$ 를 추론하는 것이다. 가능한 해결책이 그림 9.1(b)에 주어져 있으며, 여기서 우리는 데이터의 노이즈를 나타내는, 함수 값 $f(\boldsymbol{x})$ 에 중심을 둔 세 개의 분포도 함께 보여준다.
$\quad$ 회귀는 기계 학습의 근본적인 문제이며, 회귀 문제는 시계열 분석(예: 시스템 식별), 제어 및 로봇 공학(예: 강화 학습, 순방향/역방향 모델 학습), 최적화(예: 선 탐색, 전역 최적화), 그리고 심층 학습 응용(예: 컴퓨터 게임, 음성-텍스트 번역, 이미지 인식, 자동 비디오 주석)을 포함한 다양한 연구 분야와 응용 분야에 등장한다. 회귀는 분류 알고리즘의 핵심 요소이기도 하다. 회귀 함수를 찾는 것은 다음을 포함한 다양한 문제를 해결하는 것을 요구한다.
보통 노이즈의 유형 또한 ‘모델 선택’의 대상이 될 수 있지만, 이 장에서 우리는 노이즈를 가우시안으로 고정한다.
- 모델(유형)의 선택 및 회귀 함수의 매개변수화. 데이터셋이 주어졌을 때, 어떤 함수 클래스(예: 다항식)가 데이터를 모델링하기 위한 좋은 후보이며, 어떤 특정 매개변수화(예: 다항식의 차수)를 선택해야 하는가? 8.6절에서 논의된 바와 같이, 모델 선택은 훈련 데이터를 합리적으로 잘 설명하는 가장 단순한 모델을 찾기 위해 다양한 모델을 비교할 수 있게 해준다.
- 좋은 매개변수 찾기. 회귀 함수의 모델을 선택한 후, 좋은 모델 매개변수를 어떻게 찾는가? 여기서 우리는 다양한 손실/목적 함수(무엇이 “좋은” 적합인지를 결정함)와 이 손실을 최소화할 수 있게 해주는 최적화 알고리즘을 살펴봐야 할 것이다.
- 과적합과 모델 선택. 과적합은 회귀 함수가 훈련 데이터에 “너무 잘” 적합하지만 본 적 없는 테스트 데이터로 일반화되지 않을 때 발생하는 문제이다. 과적합은 전형적으로 기저 모델(또는 그 매개변수화)이 지나치게 유연하고 표현력이 높을 때 발생한다(8.6절 참조). 선형 회귀의 맥락에서 우리는 근본적인 이유를 살펴보고 과적합의 영향을 완화하는 방법을 논의할 것이다.
- 손실 함수와 매개변수 사전 확률 사이의 관계. 손실 함수(최적화 목적 함수)는 종종 확률적 모델에 의해 동기가 부여되고 유도된다. 우리는 손실 함수와 이러한 손실을 유도하는 기저의 사전 가정 사이의 연결성을 살펴볼 것이다.
- 불확실성 모델링. 어떤 실용적인 설정에서든, 우리는 모델 클래스와 해당 매개변수를 선택하기 위해 오직 유한한, 잠재적으로는 많은 양의 (훈련) 데이터에만 접근할 수 있다. 이 유한한 양의 훈련 데이터가 가능한 모든 시나리오를 포괄하지는 않는다는 점을 감안할 때, 우리는 테스트 시점에 모델 예측의 신뢰도 척도를 얻기 위해 남아있는 매개변수 불확실성을 설명하고자 할 수 있다. 훈련 세트가 작을수록 불확실성 모델링은 더욱 중요해진다. 불확실성의 일관된 모델링은 모델 예측에 신뢰 구간을 부여한다.
$\quad$ 다음에서 우리는 선형 회귀 문제를 풀기 위해 3, 5, 6, 7장의 수학적 도구들을 사용할 것이다. 최적의 모델 매개변수를 찾기 위해 최대 우도 추정(MLE)과 최대 사후 확률(MAP) 추정에 대해 논의할 것이다. 이러한 매개변수 추정치를 사용하여, 일반화 오차와 과적합에 대해 간략히 살펴볼 것이다. 이 장의 끝부분에서는 모델 매개변수에 대해 더 높은 수준에서 추론할 수 있게 해주는 베이지안 선형 회귀에 대해 논의하며, 이를 통해 최대 우도 추정 및 MAP 추정에서 발생하는 몇 가지 문제들을 제거할 것이다.